AI解説
arXiv: https://arxiv.org/abs/2610.33275(v1, 2026-10-23, 15 pages / 13 figures / 3 tables) 情報源: arXiv PDF の全文(本文・図・表・Algorithm 1・参考文献)を精読した。付録は無い。 会議・ジャーナルへの採録情報は論文に書かれていないため、
venueは arXiv プレプリントとしている。 図について: Figure 5〜8 は arXiv HTML 版の実画像、Figure 1〜4 と 9〜13 は HTML 版に画像が無いため PDF から切り出した画像である(figures/fig*.png)。 図番号とキャプションは原論文に対応する。AI 生成の補足図は付けていない。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+robots.txtで検索除けされている。
一言で
計算ノートブックの GPU を、セッション単位ではなくセル単位で確保・解放するサーバーレス GPU 基盤。 各セルが実際に読む変数の集合(state closure)と import するパッケージの集合(import closure)を静的解析で求める。 ユーザーがセルを編集している数秒のあいだに、その 2 つだけを載せた GPU ワーカーを先に用意しておく。 実行後は更新分だけを数秒で保存し、すぐ GPU を手放せる。 実 Kaggle ノートブックの評価では、GPU セルの 95〜98% が目に見える遅延なく始まる。 固定セッション予約より 43〜70%、最先端の NotebookOS より 32〜55% 少ない GPU-hours で動く。
背景・問題
解くべき問題
Colab や Kaggle は、ノートブックのセッションに GPU を開始から終了まで束縛する。 しかし GPU が計算するのは GPU セルの実行中だけで、残りの時間は遊んでいる。 論文は理由を 2 つ挙げる。
- ノートブックには、データ準備や描画のような CPU のみのセルが混ざっている。
- ユーザーは実行の合間に、出力を眺め、結果を考え、次のセルを編集する。この時間は実行時間よりずっと長い。
論文が引く既存研究(NotebookOS の論文)では、予約された GPU は 81% 以上の時間でアイドルだった。 固定予約は、フリート規模では無駄が大きく、費用も高い。
自然な解決策は、サーバーレス GPU を使い、GPU セルを 1 回の関数呼び出しとして実行することである。 サーバーレスなら、CPU セルと実行間の待ち時間のあいだ GPU を手放せる。 ただし、ここに stateful と stateless の緊張関係 がある。
- ノートブックのセルは、暗黙の共有名前空間を通じて前のセルの変数やパッケージを引き継ぐ。つまりセッションは stateful である。
- サーバーレスの呼び出しは stateless である。
新しいワーカーで GPU セルを動かすには、次の 2 つが要る。
- 実行環境の準備。CUDA ランタイムの初期化と、カーネルが以前に読み込んだパッケージの import。
- それまでのセルが溜めた変数の復元。
論文はこの総コストを preparation latency(準備遅延)と呼ぶ。 セルの再実行や全変数の読み込みで、1 回あたり数秒から数分かかる。 ユーザーが Run を押した後に準備を始めると、対話的とは言えない。
対話的かどうかの基準は interactive-start threshold = 1 秒 である。 Run を押してからセルが実行を始めるまでが 1 秒を超えたら、その GPU セルの実行は基準を外したとみなす。 1 秒という値は、応答は約 1 秒以内が認知の流れを保つという先行研究(Miller, Nielsen, Nah)に基づく。
したがって問題は「どれだけ速く、セルに必要な状態をワーカーに渡せるか」に帰着する。
3 つの観察(約 5,000 件の実ノートブック)
著者らは Kaggle と公開 GitHub から 5,004 件の AI/ML ノートブックを集めた。
検索語は llama、lora、pytorch など。
各セルの GPU 要否は、GPT-oss-120B と Grok-code-fast-1 の 2 つの LLM に判定させた。
どちらかが GPU と答えたセルを GPU セルとする。
2 モデルの一致率は 94.5%、Cohen’s κ は 0.75(Landis–Koch の基準で substantial agreement)である。
タスクの内訳は次のとおり(Table 1 に相当)。
| タスク種別 | ノートブック数 | 割合 |
|---|---|---|
| Training | 2,597 | 52% |
| Fine-tuning (PEFT) | 1,016 | 20% |
| Inference | 988 | 20% |
| Data analysis and other | 403 | 8% |
| 合計 | 5,004 | 100% |
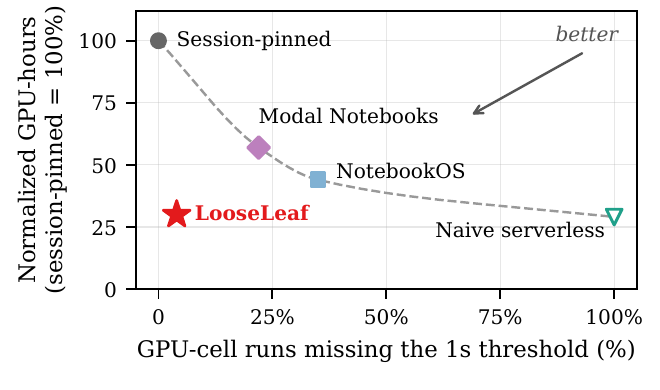
Figure 1: 72 同時セッションでの GPU-hours(縦軸、固定セッション予約 = 100%)と、1 秒の閾値を外した GPU セル実行の割合(横軸)。4 つのベースラインがコスト対対話性のフロンティアを描き、LooseLeaf はそれを左下へ押し下げる。
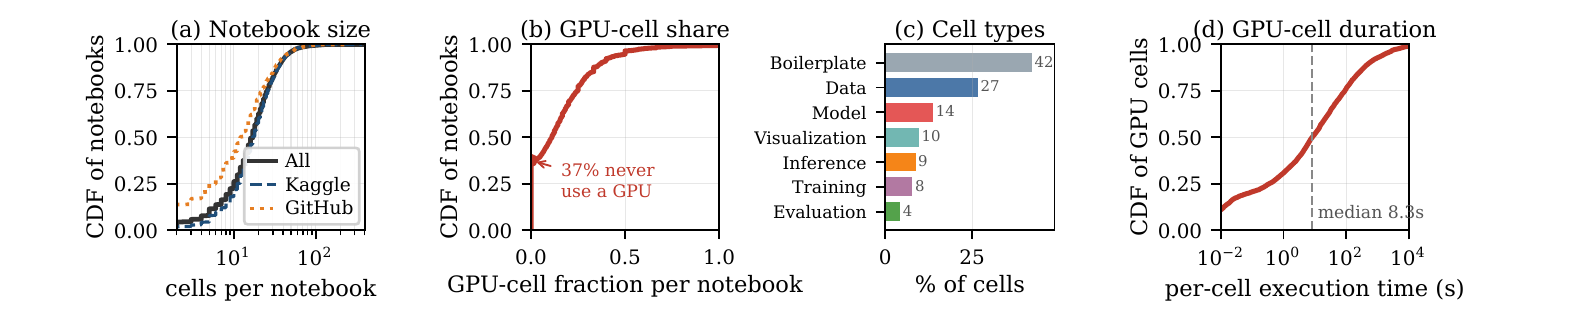
Figure 3: 収集したノートブックの一般統計。(a) ノートブックあたりのセル数の CDF、(b) GPU セルの割合の CDF(0 の位置のジャンプは GPU を使わないノートブック)、(c) セル種別の分布、(d) GPU セルの実行時間の CDF(破線は中央値)。
Figure 3 から、論文は次の統計を読み取っている。
- 典型的なノートブックは 17 セル。セッションの途中で状態がかなり溜まる。
- 37% のノートブックは GPU を一度も使わない。GPU を使うノートブックでも、GPU セルは全セルの中央値 20%。
- セル種別では boilerplate が 42%、data が 27%、model が 14%、visualization が 10%、inference が 9%、training が 8%、evaluation が 4%。
- GPU セルの実行時間は数ミリ秒から数時間まで広がり、中央値は約 8 秒(図中は 8.3 s)。ほとんどの GPU セルは短く、他のセルと同じ対話性を求められる。
この統計から論文は、準備遅延は小さくなければならないと結論する。
次に、3 つの観察が設計を方向づける。
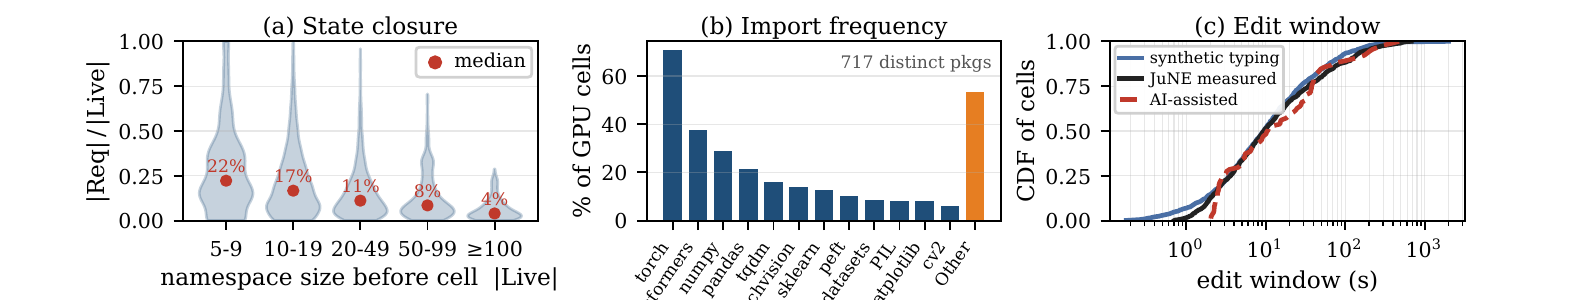
Figure 4: コーパスの 3 つの性質。(a) GPU セルの直前の生きた変数の数に対する state closure の比率、(b) GPU セルでのパッケージ出現頻度、(c) 手入力と AI 補助編集それぞれの編集時間窓の分布。
観察 1: GPU セルの state closure は小さい。
Live(c) を、セル c の実行前に使える変数(データ変数)の集合とする。
Req(c) を、セルの state closure S_c(セルが読まねばならない変数)とする。
比 |Req(c)| / |Live(c)| は、実行のために実体化すべき名前空間の割合を表す。
この比の中央値は、名前空間が大きいほど小さい。
| 実行前の生きた変数の数 | 比の中央値 |
|---|---|
| 5〜9 | 22% |
| 10〜19 | 17% |
| 20〜49 | 11% |
| 50〜99 | 8% |
| 100 以上 | 4% |
名前空間全体の復元コストは溜まった状態に比例して増える。 一方、GPU セルが要る状態の増え方はずっと緩やかである。 示唆は「名前空間をまるごと再構築せず、対象セルの依存誘導 closure だけを変数粒度で復元せよ」となる。
観察 2: パッケージの分布は head と tail をもつ。
GPU セルの import closure を集計すると、torch が GPU セルの 71% に現れ、transformers、numpy、pandas、tqdm、torchvision、sklearn が続く。
一方、パッケージは全体で 717 種あり、GPU セルの 53.5% は上位 12 個の外のパッケージを 1 つ以上使う。
空のプロセスから毎回始めると、head のパッケージの import コストを毎回払う。
固定集合を事前に読み込むと、tail のせいで多くのセルには足りないか、ほとんどのセルが使わない数百のパッケージを読み込むことになる。
示唆は「GPU を意識した import キャッシュを持て」である。
この分布は、SOCK が Python サーバーレス負荷で報告した分布に似ている。 SOCK は、共通パッケージを読み込み済みのプロセス(zygote)から fork し、tail は fork 後に import する。 しかし SOCK は CPU の関数が対象である。 fork した子プロセスは親の CUDA コンテキストのハンドルを継承するが、基盤の GPU ドライバ資源は複製されない。 そのため同じ機構はそのままでは使えない。 ただし、CUDA を正しく扱えれば、zygote 方式は有望な基礎になるというのが論文の見立てである。
観察 3: 編集は短い準備窓を与える。 観察 1・2 は準備の量を減らす。 それでも、Run の後に始めれば遅延になる。 ユーザーがセルを編集する間に準備を前倒しできれば、遅延を隠せる。 窓の大きさは、次の 2 つで見積もっている。
- 大規模キーストローク研究(136 million keystrokes)のタイピング速度モデルから作った合成分布。
- JuNE(Jupyter の開発トレース。20 人・100 時間超の実行ログ)で測った、純粋なタイピング区間。
2 つの分布は一致し、中央値は合成 9.4 秒、実測 9.5 秒である。 窓は実在するが、典型的には数秒のオーダーしかない。
LLM の補助でコードを貼り付けると、窓が縮むかもしれない。 これを DSPM(学生が LLM アシスタントを使うデータ分析の研究)の対話ログで確かめた。 「生成コードの貼り付けから次の実行まで」の間隔の中央値は 10.7 秒で、タイピングの窓とよく似ていた。 ユーザーは貼り付けた後も、数秒をかけて読み、手直ししてから実行する。
提案手法: LooseLeaf
課題(何をやるか)
セルごとの state closure と import closure を静的解析で導き、編集中に GPU ワーカーを用意し、実行後に更新分だけを保存して GPU を手放す。 この 3 点を、サーバーレス GPU 基盤として実装する。
2 つの closure(§2.2)
ノートブックは、セルの粒度でプログラム構造が見える。 各セルを静的解析して、定義する変数と参照する変数の関係(def-use)を取り、セル間の依存グラフを作る。 辺は、参照から定義へ向かう。 ひとつの名前を複数のセルが定義することもあり、セルは任意の順で実行されうる。 そのため、辺は「その名前を最後に実行して定義したセル」へ向ける。
対象セルから BFS で参照をたどると、2 つの集合が得られる。
- state closure
S_c: セルが読まねばならない生きた変数の最小集合。 - import closure
I_c: セルが import すべきパッケージの最小集合。
これでセルは、サーバーレス関数 F_c(S_c, I_c) → (S'_c, O_c) としてモデル化できる。
S'_c は更新後の状態、O_c は出力である。
静的解析で両者を厳密に決められるのは、セルが使う変数とパッケージが、セルのコードか、参照する関数の本体に名前で現れるからである。
例外は、exec や globals() のように名前空間を動的に読む構文で、ノートブックのコードではめったに使われないと論文は述べる。
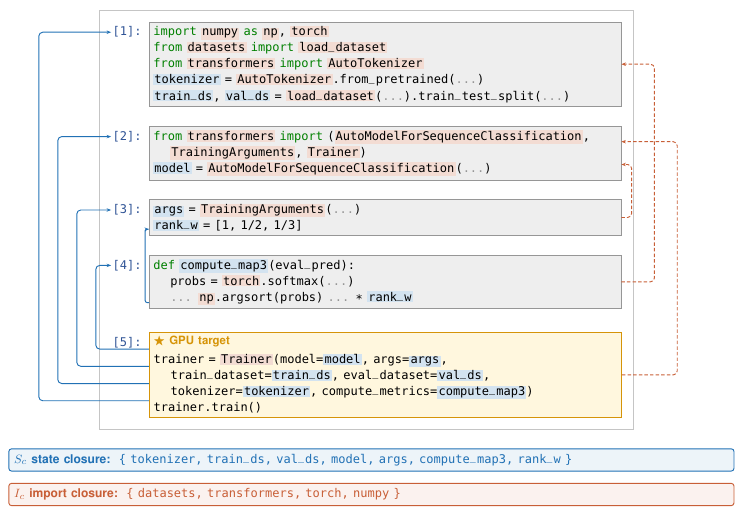
Figure 2: 5 セルのモデル微調整ノートブックの依存グラフ。Cell 5 が GPU ターゲット。実線は state の依存、破線は import の依存で、どちらも推移的にたどる。下の枠が得られる closure S_c と I_c。
Figure 2 の例で確かめる。
Cell 5 は Trainer を作って学習を起動する GPU セルである。
Cell 5 が直接参照する変数は model、args、train_ds、val_ds、tokenizer、compute_map3 の 6 つ。
さらに、Cell 4 の関数 compute_map3 が Cell 3 の rank_w を読むので、rank_w も閉包に入る。
計 7 変数が S_c である。
compute_map3 は torch.softmax と np.argsort を呼ぶため、Cell 5 が直接 import していなくても torch と numpy が要る。
datasets と transformers を加えた 4 パッケージが I_c である。
全体構成と GPU セルの経路(§3.1)
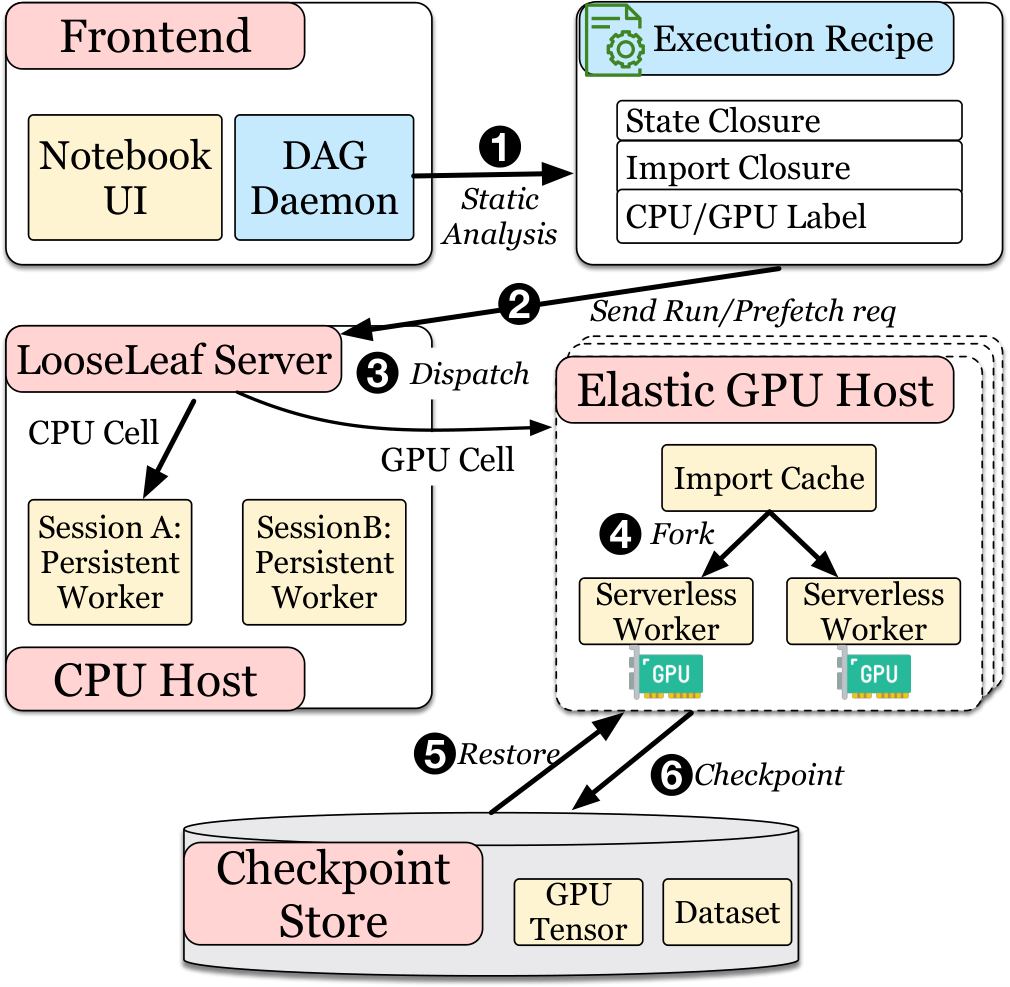
Figure 5: LooseLeaf のアーキテクチャと、1 リクエストの経路。編集中に DAG daemon が各セルを実行レシピ(state closure、import closure、CPU/GPU ラベル)にまとめる。CPU セルはセッションの永続ワーカーで、GPU セルは GPU ホスト上の import cache から fork したワーカーで動く。ワーカー間の状態は checkpoint store を介してやり取りする。丸数字は本文の手順に対応する。
構成要素は 5 つある。
- frontend: ノートブック UI と DAG daemon。編集のたびに依存グラフを更新し、セルごとの実行レシピを作る。
- server: セルの割り当てとワーカー管理を担う制御面。GPU を同居させる必要は無く、ユーザーのローカルマシンでも遠隔ホストでもよい。
- 永続 CPU ワーカー: セッションのノートブックカーネルを持つ。CPU セルはここで走る。
- 一時的な GPU ワーカー: 1 つの GPU セルだけを実行する。
- import cache: ホストごとのプロセスプール。GPU ワーカーはここから fork される。
- checkpoint store: ノートブックの変数を保持し、ワーカー間・ホスト間で運ぶ。
GPU セルは 2 つの相を通る。
- 編集中。DAG daemon が静的解析でレシピを更新する(①)。セルが GPU セルとラベルされたら、レシピを prefetch 要求として server に送る(②)。server は要求を dispatch し(③)、セッションの GPU ワーカーを確保する。ワーカーは暖かい既存のものか、import cache から fork した新しいもの(④)。fork で、キャッシュが読み込み済みのパッケージが手に入る。ワーカーは残りの import を済ませ、state closure の変数を checkpoint store から復元する(⑤)。
- Run 後。Run 要求は、送信されたコードから計算し直した closure を運ぶ。ワーカーは残りの準備を終えてから実行する。実行後、更新した変数を store に書き戻す(⑥)。その後もワーカーは、後述の退避方針のもとでセッションのために暖かいまま残る。
依存誘導チェックポイント/リストア(§3.2)
GPU ワーカーは、セルを走らせる前に state closure の変数を持っている必要がある。 観察 1 により、変数単位で復元する。 セッションの変数は、セルの合間は checkpoint store にある。
素朴な変数ごとの pickle は、誤りであり、遅い。 pickle は変数を、構造(作り直し方)と payload(生のデータ バイト)の 2 つを含む自己完結のストリームに符号化する。 変数ごとに別ストリームにすれば独立に保存・復元できて、closure の粒度に合う。 しかし次の 2 つの問題がある。
- 誤り(共有が壊れる): pickle が共有を検出するのは、1 本のストリームの中だけである。memo(書き出した全オブジェクトの記録)がストリームの終了で捨てられるためである。たとえば optimizer の parameter group は、model の parameter を参照する。model と optimizer を別ストリームにすると、共有されていた parameter が 2 つのコピーになる。復元後、学習ステップは optimizer が持つコピーを更新し、model は別のコピーで計算してしまう。tensor のビュー(スライスや reshape で作る、ベース tensor とストレージを共有する別オブジェクト)でも同じ失敗が起こる。
- 遅い: pickle のストリームは、payload の全バイトをストリーム内に実体化する。保存で payload を少なくとも 2 回コピーし、復元でも書き戻す。GPU tensor は PCIe を越える転送が 2 回増える。これらは全て 1 スレッドで逐次に走る。評価で使ったノートブックでは、保存される状態のバイトの 95.0% が GPU tensor で、残りの大半はデータセットや配列のような CPU バッファである。それ以外のオブジェクトは合わせて 1% 未満である。closure の pickle コストとは、ほぼ payload を動かすコストである。共有 tensor を別ストリームで認識できないと、バイトを何度も動かすことにもなる。
したがって変数粒度の復元には、(a) 変数をまたぐ共有を保つ機構と、(b) payload のバイトを pickle ストリームの外に出す機構が両方要る。
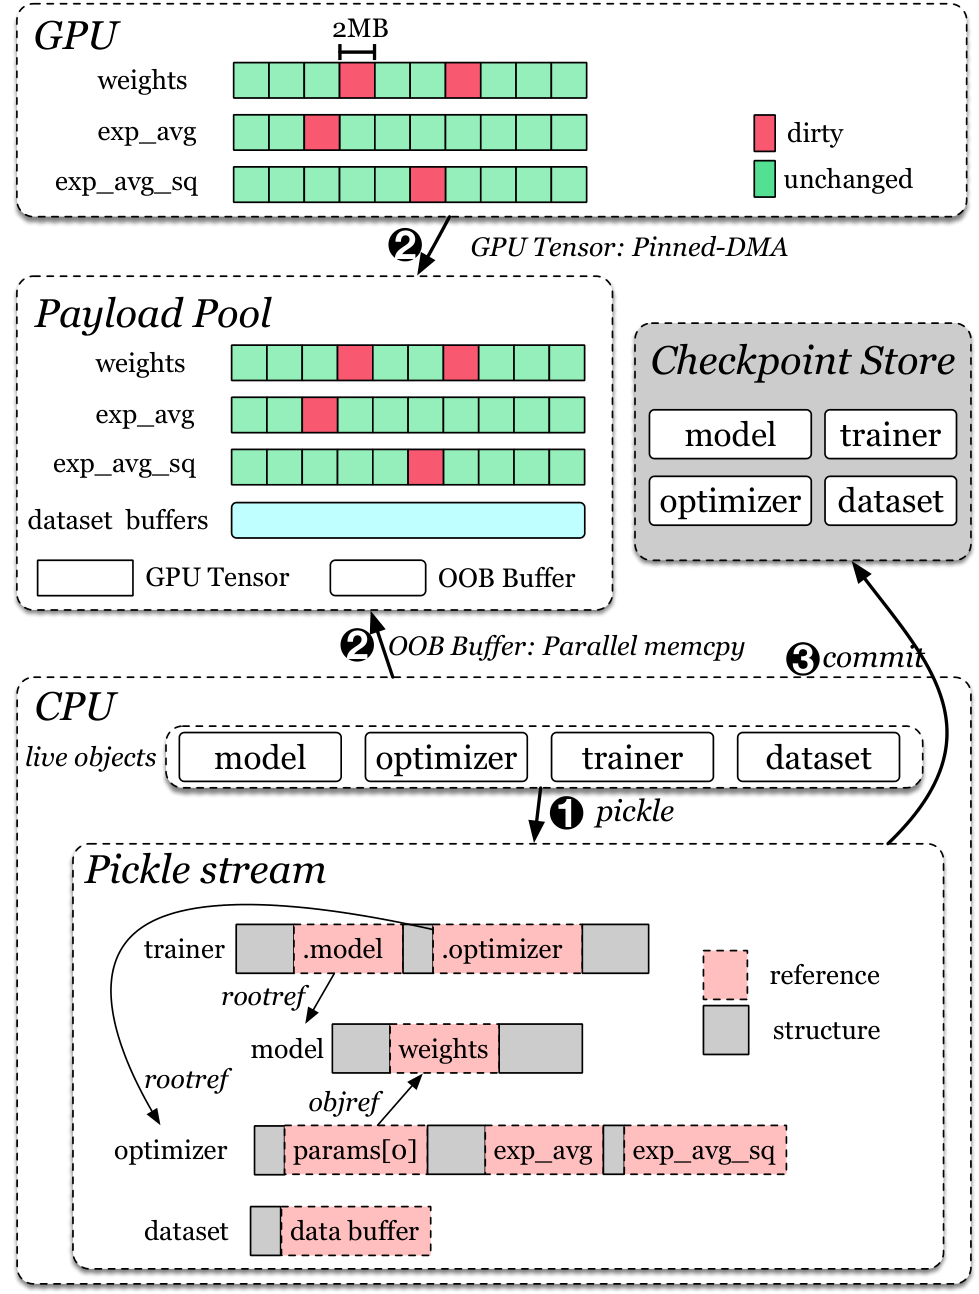
Figure 6: セルの状態のチェックポイント。pickle が構造を取り出し、RootRef と ObjRef で変数間の共有を明示する(①)。大きな payload はストリームから共有プールへ移り(②)、構造 blob が checkpoint store にコミットされる(③)。GPU tensor は 2 MB 単位の dirty 追跡を行う。
共有を保つ: RootRef と ObjRef。 LooseLeaf は、各変数のシリアライズ後も memo を保持する。 memo は記録したオブジェクトを参照し続けるので、記録済みオブジェクトの同一性が別オブジェクトに再利用されることはない。 ある変数をシリアライズするとき、到達した各オブジェクトを、セッション内の他の変数の保持済み memo と照合する。 一致すれば、別の変数がすでにそのオブジェクトを書いたと分かる。 その場合は、コピーを書かずに参照を出す。
- RootRef: 別のトップレベル変数を指す。
- ObjRef: 別の直列化済み変数の中のオブジェクト(model の parameter やバッファなど)を指す。
Figure 6 では、trainer が model と optimizer への RootRef を持つ。
optimizer の中の parameter エントリは、model の下に直列化された weights への ObjRef である。
不変オブジェクトは、共有が観測できないので値で直列化する。
これで変数を別々にシリアライズしても、変数間の共有が保たれる。
大きな payload を外に出す。 LooseLeaf は GPU tensor と CPU バッファのシリアライズを横取りする。 この 2 種類が、保存バイトのほぼ全てだからである。 pickle が payload に到達したら、バイトをストリームの外のホスト上の共有プールへ移し、ストリームには場所の参照だけを残す。
- プールは huge page で裏打ちされる。page fault の時間を減らすためである。
- ストレージの payload は、それを最初に保存した変数が 1 回だけ書く。同じストレージに届く他の変数は、プール上の場所を参照するだけで何も書かない。
- GPU tensor: ワーカーがプールの領域を CUDA に登録し、tensor のストレージが、デバイスメモリとプールのあいだを pinned DMA の 1 回の転送で動く。
- データセットや配列のバッファ: pickle protocol 5 の out-of-band(OOB)バッファ機構で payload をストリームから分け、並列 memcpy でプールにコピーする。
これで各変数のストリームは、構造と参照だけの小さな blob に縮む。 各変数はその blob を checkpoint store にコミットする。 store はセッションの変数ごとに 1 エントリを持ち、payload のバイトがどのホストにあるかも記録する。 セッションが別ホストへ移るときは、旧ホストのプールから新ホストのプールへ payload をコピーする(§3.4)。
リストア。 対象セルの state closure から出発し、closure の変数を依存順に unpickle する。 RootRef や ObjRef に到達したら、参照先のオブジェクトを復元して参照をつなぎ直すので、共有オブジェクトは 1 回だけ復元される。 payload の参照は、共有プールからバイトを取ってくる。 復元は最小であり、GPU メモリにも同じ境界が適用される。 たとえばセッションが model と optimizer の両方を持ち、対象セルが model しか読まなければ、closure は model だけを指す。 weights は GPU に載せ、optimizer の状態は checkpoint store に残す。
増分保存。
実行後、ワーカーは更新後の状態 S'_c を保存する。
S'_c には、セルが定義した変数に加え、closure のうちセルが in-place で変えた変数(リストへの append など)も入る。
静的解析はこの in-place 更新を見抜けない。
そこでワーカーは、state closure の全変数と、そこから参照で届く全変数を再シリアライズする。
再シリアライズで作り直すのは、小さな構造 blob だけである(payload はプールにあるため)。
payload のバイトは dirty 追跡で更新する。
GPU tensor は 2 MB 単位で dirty 領域を追跡し、プール内のその領域だけを更新する。
変数は、到達する保存のたびに再シリアライズされるので、ストリーム内のオブジェクトの位置が変わりうる。
そのため ObjRef は、オブジェクトの永続 id を持つ。
store が id から現在位置への対応を持ち、持ち主が保存のたびに位置を更新する。
ワーカー間の整合性。 永続 CPU ワーカーと一時的な GPU ワーカーは、変数を checkpoint store だけを通じて交換する。 store は変数ごとにバージョンを持ち、保存で変数が変わるたびに進める。 変数のコピーを持つワーカーは、バージョンが進んでいたらコピーを更新する。
GPU を意識した import cache(§3.3)
state の復元は、クラスがパッケージに定義されたオブジェクトを実体化し、セルの実行はパッケージを直接呼ぶ。 そのため復元の前に、ワーカーは CUDA を初期化し、import closure のパッケージを import する必要がある。 観察 2 のとおり、common な head は多くのセルで共通である。 毎回ゼロから import すると、head のコストを繰り返し払う。 import cache から fork したワーカーは、読み込み済みモジュールを copy-on-write で継承し、足りないパッケージだけを fork 後に import する。
CUDA の fork 安全性。 CUDA ランタイムの状態は fork 安全でない。 CUDA コンテキストは初期化したプロセスに束縛され、fork した子は使えない。 そのため、CUDA を初期化したプロセスは GPU ワーカーの親になれない。 import cache のあらゆる fork 親は CUDA-clean でなければならず、import が CUDA に触れるパッケージを含められない。
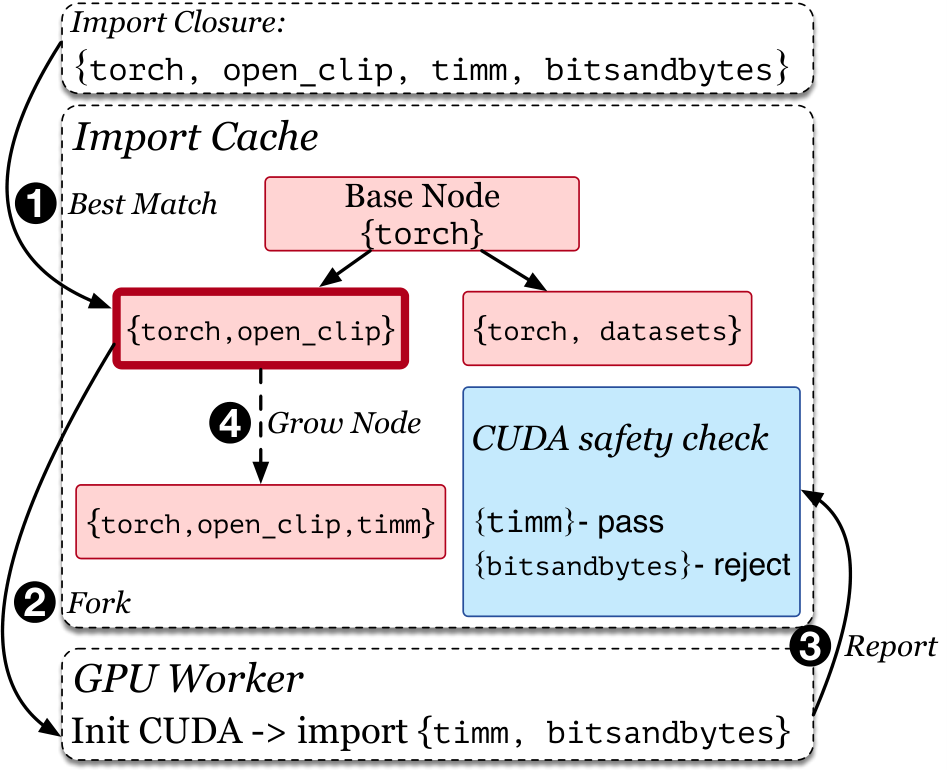
Figure 7: GPU-aware import cache。キャッシュ ノードは CUDA-clean な生きた zygote プロセスで、base ノードが head の共通パッケージを、子ノードが tail のパッケージを持つ。import closure が {torch, open_clip, timm, bitsandbytes} のセルでは、最もよく合うノードから fork し、残りを fork 後に import する。timm は CUDA 安全性チェックを通るのでキャッシュが非同期にノードを伸ばし、bitsandbytes は CUDA に触れるのでキャッシュの外に残る。
階層。 import cache は、キャッシュ ノードの階層である。 各ノードは、モジュールを読み込み済みの CUDA-clean な生きた zygote プロセスである。 base ノードが head の共通パッケージを持ち、子ノードが tail のパッケージで拡張する。 GPU セルでは、import closure に最もよく合うノードを選び(①)、そこから fork して読み込み済みモジュールを継承する(②)。 fork 後に CUDA を初期化し、残りのパッケージを import する。
キャッシュの成長。 セルが選んだノードに無い import を持ち込むと、ワーカーは実行前にそれを import cache に報告する(③)。 キャッシュは、選んだノードを fork して新しいパッケージを import するノードを 非同期に 作り(④)、後のワーカーが継承できるようにする。 非同期なので、セルの実行は遅れない。 全ノードを CUDA-clean に保つため、CUDA 安全性チェックを課し、import が CUDA に触れないパッケージだけを入れる。 CUDA に触れるパッケージはキャッシュに入れず、ワーカーが fork 後に import する。 fork の後ならワーカーは CUDA を初期化済みなので安全である。 各ホストが持てるノード数は有界で、最も長く使われていない葉ノードを追い出す。 base ノードは、common な head を載せ続けるために常駐する。
有界な編集時間中の投機(§3.4)
前の 2 つの機構は、GPU ワーカーを作るコストを下げる。 残る問いは、いつ・どこで作るかである。 Run を押すまで待つと準備遅延が critical path に乗る。 LooseLeaf は編集の窓を使い、編集中に GPU ワーカーを用意する。 DAG daemon は編集のたびに def-use グラフを最新に保つ。
GPU 経路への振り分け。
全てのセルを GPU 経路に流すと、CPU のみのセルが GPU を無駄にする。
判定は静的なパッケージ依存でできる。
GPU の仕事は、PyTorch などの GPU ライブラリに束縛された Python パッケージ経由で起動されるからである。
def-use グラフから各セルの effective import set(セルのトップレベル文の参照から到達できる、import 済みパッケージの全て)を求める。
Figure 2 の Cell 5 の集合には、Trainer の参照から transformers が、compute_map3 内の呼び出しから torch が入る。
一方 Cell 4 は、トップレベル文が関数定義だけなので集合が空である。
effective import set が GPU フレームワーク パッケージのリストに含まれるときだけ、GPU 経路に振り分ける。
リストは自動と手動で作る。
ワーカーホストにインストールされたパッケージの依存に CUDA ランタイムが含まれれば、リストに入る。
ユーザーが追加することもできる。
prefetch とワーカー確保(Algorithm 1)。 GPU と判定された候補セルについて、frontend が現在の closure を prefetch 要求として server に送る。 server は、そのセッションの GPU ワーカーを確保する。
- セッションが暖かいワーカー
wを持っていれば、再利用して不足分の状態だけを復元する(hit)。 - 無ければ(miss)、メモリが足りて空き GPU スロットのあるホストのうち、最も負荷の高いものを選ぶ(consolidation)。そのようなホストが無ければ、退避できるアイドル ワーカーを持つ、最も負荷の高いホストを選び、GreedyDual 方針で
L(s')が最小のセッションのワーカーを退避する。選んだホストの import cache から fork し、前回のホストと違えばセッションの状態を先に移す。最後に state closureS_cをwに復元する。
GPU の滞在を有界にする。
prefetch で用意したワーカーは GPU デバイスを占有する。
固定タイムアウトでは、短ければ有用な準備を捨て、長ければ安い prefetch 要求で GPU を握れてしまう。
そこで LooseLeaf は、アイドルのワーカーをキャッシュとして管理する。
セッション s の暖かいワーカーが持つ GPU 状態を R_s とし、次を計算する。
c(s) = Σ_{r ∈ R_s} bytes(r)
L(s) = H_s + c(s)
H_s は、R_s が最後に変わった時点のホストの時計の値である。
時計は減らない。
GPU が逼迫したら、まず「セルが完了したアイドル ワーカー」を退避する。
それが無ければ、投機的に用意したワーカーを退避する。
各クラスの中では L(s) が最小のワーカーを退避し、時計をその値まで進める。
この方針で、あるクライアントが得られる滞在は有界になる。
H_s は時計を超えないので、L(s) は時計より高々 c(s) 上にあるだけである。
L(s) が上がらない限り、時計がそこまで進んだ時点でワーカーは退避される。
L(s) が変わるのは R_s が変わるときだけである。
実行を除けば、クライアントが R_s を変えられるのは prefetch だけで、prefetch はワーカーがまだ持たない変数を読み込む。
その変数は、セッションの以前の実行に由来するものに限られる。
同じ closure への prefetch を繰り返しても L(s) は変わらず、時計が追い越していく。
したがって、セッションの滞在は、そのセルがすでに計算した状態のバイト数で抑えられる。
安い prefetch 要求で GPU を握ることはできず、攻撃者は、同じ状態を計算した誠実なセッション以上の滞在を得られない、と論文は主張する。
配置とクラスタのプロビジョニング。 新しいワーカーは consolidation(最も負荷の高いホストへ寄せる)で配置する。 背景のコントローラが、target-utilization 方針と square-root staffing の余裕で、電源が入っているホスト数を調整する。 ホストを落とすのは、暖かいワーカーを退避し、常駐する状態を別ホストへ移してからである。
GPU セルの一生。
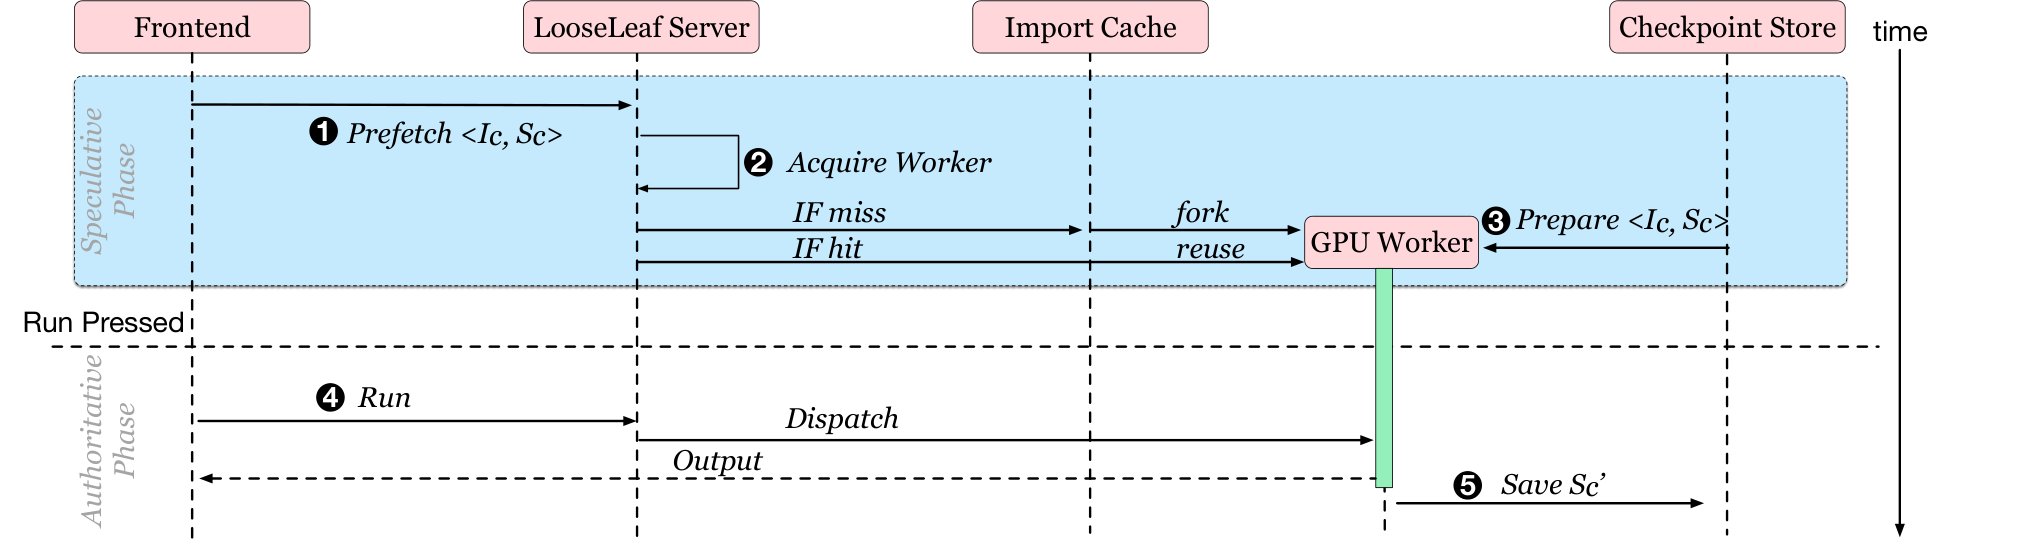
Figure 8: 編集中に frontend が現在の closure を載せた prefetch を送り(①)、server がセッションのワーカーを確保する(②)。miss なら import cache から fork し、hit なら暖かいワーカーを再利用する。ワーカーは残りのパッケージを import し、state closure を checkpoint store から復元する(③)。ユーザーが Run を押すと(④)、ワーカーは残りの準備を終えて実行する。実行後は更新状態を store に保存し(⑤)、ワーカーは後で回収され、状態は store に残る。
プロトコルは、編集中の 投機相 と Run 後の 確定相 からなる。 投機が安全なのは、prefetch がパッケージと変数を読み込むだけで、セルを実行しないからである。 用意したワーカーは、Run までに古くなりうる。 そのため Run 要求は、送信されたコードから計算した closure を運ぶ。 ワーカーは復元済み変数のバージョンを確認し、古いものを store から更新し、残りの準備を終えてから実行する。 古い prefetch は、カバーしきれなかった準備時間のコストを払うだけで、正しさには影響しない。
実装(§4.1)
Jupyter と marimo の両方に実装している。 どちらでも frontend は、Pyodide の web worker の中で、編集中の def-use グラフの維持、closure の計算、GPU ラベル付けを行う。 2 つの frontend は、同じ server とワーカーを共有する。
- import cache は、ホストごとのプロセス木で、LRU 退避、上限 50 ノード。
- checkpoint store は、メタデータを Redis に、payload のバイトを hugetlbfs プール(dlmalloc で管理)に持つ。
- payload のホスト間移動は、Linux のゼロコピー インターフェース(
MSG_ZEROCOPY)を使う。 - 構造 blob は Ray の object store で同期する。
- server は需要信号を、標準的なクラスタ オートスケーラ(Kubernetes の HPA)に出す。
実験・結果
設定(§4.1)
- テストベッド: AWS p4d.24xlarge(A100-40GB × 8、vCPU 96、RAM 1,152 GiB)のクラスタ。各ノードに 512 GiB の hugepage アリーナを確保し、checkpoint の payload プールを支える。
- ワークロード: 2024〜2025 年の Kaggle コンペ コーパスから 24 ノートブックを抽出する。タスク種別とモデル サイズの分布に、Hamilton 方式の按分で合わせる(Table 2)。モデルは 300M 未満の CNN から 14B の LLM まで。セル間の到着間隔は Adobe のノートブック トレース(NotebookOS の論文のもの)から、各セルの編集窓は DSPM の貼り付けから実行までの分布から引く。
- ベースライン 4 つ:
- Session-pinned: Jupyter・Colab・Kaggle の方式。セッションが到着から終了まで GPU を持つ。全セルが暖かいカーネルに当たるので、遅延の理想であり、プロビジョニングの上限でもある。8 GPU ホストへ best-fit で詰め、空になったホストはすぐ電源を切る、という寛大なモデルにしている。
- NotebookOS: セッションごとに永続カーネルのレプリカを 3 つ持つ。セルの実行時にレプリカへ空き GPU を割り当てる。レプリカは状態を CPU メモリに持つので、GPU セルは先にモデル状態を GPU へ移す。更新後は実行したレプリカが直列化して他のレプリカと同期する。同期がセル間の空き時間より長引くと、次のセルが残りを待つ。
- Modal: 本番のサーバーレス GPU 基盤で、サーバーレスのノートブック サービスも持つ。セッションごとに 1 カーネルで、既定 10 分のアイドル タイムアウトで回収する。回収で状態は捨てられ、次のセルはノートブック サーバーを再起動して上流の全セルを再実行する。
- Naive serverless: 各 GPU セルを素のサーバーレス GPU 関数として動かす。新しいコンテナを起動し、CUDA を初期化し、フレームワークを cold import し、名前空間全体を転送する。実行後は名前空間全体を書き戻す。LooseLeaf から、依存グラフ、checkpoint store、import cache を全部外した構成に等しい。
- 指標:
- GPU-hours: プロビジョニングされた GPU 数の時間積分(8 GPU ホスト単位)と、ピーク GPU 数。実際にセルを実行している GPU 数と比べる。
- user-visible latency: Run を押してからセルが実行を始めるまで(実行時間は除く)。p95 の対話性は、セル実行の 95% 以上が 1 秒以内に始まるかで判定する。
- preparation latency(編集窓との比較)と save time(セル間隔との比較)。
GPU プロビジョニング(§4.2)
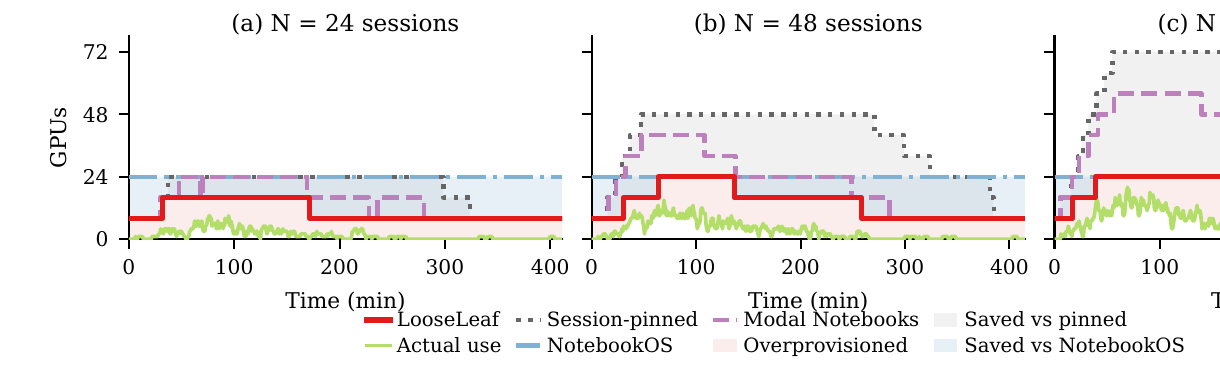
Figure 9: 24・48・72 同時セッションでの、プロビジョニングされた GPU 数の時間変化と、実際にセルを実行している GPU 数。プロビジョニングは 8 GPU 単位のホスト粒度で行われる。網掛けは、各ベースラインに対して LooseLeaf が節約する GPU 時間と、実使用に対して LooseLeaf が持つ余裕を示す。
実際に実行中の GPU のピークは、3 つの負荷で 9、15、20 GPU である。 セッションは、ほとんどの時間を考えるか編集することに使うからである。
| 方式 | ピーク GPU(24/48/72 セッション) | LooseLeaf の GPU-hours 削減(24/48/72) |
|---|---|---|
| Session-pinned | 24 / 48 / 72 | 43% / 63% / 70% |
| NotebookOS | 24(常に一定) | 24 セッションで 55%、72 セッションで 32% |
| Modal | 24 / 40 / 56 | 29% / 33% / 47% |
| LooseLeaf | 16 → 24(負荷が 3 倍で) | — |
NotebookOS の 48 セッションでの削減率は、本文に明記されていない。
理由は次のとおり。
- Session-pinned はセッション数に比例する。セッションが 1 GPU を握り続けるので、ピークがセッション数に従う。削減は、予約コストが線形に増える一方で LooseLeaf が実使用を追うので、負荷が増えるほど大きくなる。
- LooseLeaf は GPU を、セッションでなくセルに束縛する。セルの合間は暖かいワーカーしか持たず、状態は checkpoint store にあるので、暖かいワーカーはいつでも退避できる。consolidation でワーカーを少数のホストに集め、軽いホストを空にする。square-root staffing が到着の波の前にホストを起こす。
- NotebookOS は 24 GPU を常に保つ。セッションの 3 レプリカは別々の 3 ホストに置く必要があり、電源の入った 3 ホストが下限になる。レプリカは CPU メモリに常駐してスケールインを妨げるので、ホスト数は減らない。24 セッションでは下限の多くが遊び、72 セッションでは需要が下限に追いつくので、削減が縮む。
- Modal は、10 分のアイドル タイムアウトでセッションの予約を抑える。長い休止だけ GPU が返る。タイムアウトを短くすれば遊びをもっと回収できるが、期限切れのたびに状態が捨てられ、次のセルが再計算を払う。LooseLeaf は状態を store に残すので、このトレードオフを避ける。
LooseLeaf が実使用の上に持つ余裕は、ホスト粒度、square-root staffing、セルの合間に持つ暖かいワーカーから来る。 4 つのベースラインのうち、実使用に追従するのは LooseLeaf だけである。
エンドツーエンドの対話遅延(§4.3)
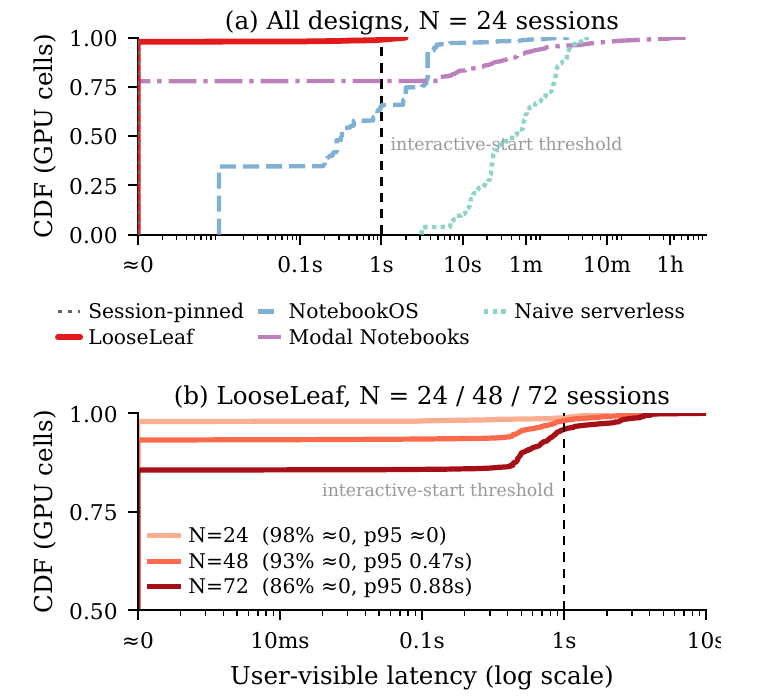
Figure 10: GPU セルのユーザーから見える遅延(対数軸)。(a) 24 同時セッションでの全方式。LooseLeaf の曲線は左端で session-pinned の理想と重なる。(b) 負荷を 48・72 セッションまで上げたときの LooseLeaf。縦の破線が 1 秒の閾値。
どの方式でも、GPU セルの遅延は 2 つの源から来る。
- Run を押した後に始まる準備。
- 前のセルの未完の仕事(保存など)を、新しい実行が待つこと。
LooseLeaf は、第 1 の源を編集中の準備で消す。 24 セッションでは、GPU セルの 98% が Run の直後に始まる。 露出する遅延は、p99 で 1.1 秒以下、最悪で 2.0 秒である。 GPU セル実行の 98.9% が 1 秒以内に始まる。 理由は 2 つある。
- 79% の GPU セルでは、セッションがワーカー キャッシュに暖かいワーカーを見つけ、前回の実行以降に変わった変数だけを復元する。
- 残りの 21% は import cache から新しいワーカーを fork し、checkpoint store から state closure を復元する。この cold 準備の中央値は 1 秒未満(§4.4)。
残る裾は、編集窓が cold 準備より短いセルから来る。 ユーザーが fork と復元の完了前に実行すると、未完の残りが露出する。 第 2 の源は、LooseLeaf には無い。 GPU ワーカーが実行直後に更新変数を保存し、増分保存が次の実行よりずっと前に終わるからである(§4.6)。
比較は次のとおり。
| 方式 | 24 セッションでの対話遅延 |
|---|---|
| NotebookOS | 準備が受け身(Run 前には転送を始められない)で、closure が無いので、セッションに溜まった全モデルを動かす。中央値 0.33 s、p95 4.4 s。第 2 の源が裾を支配する。実行のたびにモデル全体を直列化して書き出し、数十 GB の状態を持つノートブックでは同期が次の実行までの間隔より長引く。p99 で 63 s、最大 194 s で、閾値内に始まるのは 65% だけ |
| Modal | コンテナが暖かい 78% の GPU セルは即座に始まる。アイドル停止の後は、エンドポイントを再起動して上流の全セルを再実行する。この再計算は p90 で 46 秒、裾では 1 時間を超える |
| Naive serverless | 両方の源を毎セルで払う。Run 後に新しいコンテナを起動し、CUDA を初期化し、フレームワークをゼロから import し、名前空間全体を転送する。中央値 41 秒。実行後の名前空間全体の書き戻しが、次の実行を同じように遅らせる。閾値内に始まる実行は 0 件 |
論文は、LooseLeaf の各機構が、これらのコストの 1 つに対応すると整理する。 import cache がコンテナ起動と import を消し、state closure が転送を縮め、増分保存が書き戻しを縮める。
負荷が増えても遅延は低いまま保たれる。 セッションが 3 倍になっても、LooseLeaf のピーク GPU は 16 から 24 にしか増えない。 暖かいワーカーが退避されやすくなり、hit 率が 79% から 48% に下がる。 それでも 72 セッションで、GPU セルの 86% が即座に始まり、p95 は 0.88 秒、95.9% が閾値内に始まる。 48 セッションでは 93% が即座に始まり、p95 は 0.47 秒である。 残る裾は、ノードの電源を入れる時間で抑えられ、需要の急増でオートスケーラが追いつく前に時々払う。
準備が編集窓に収まる理由(§4.4)
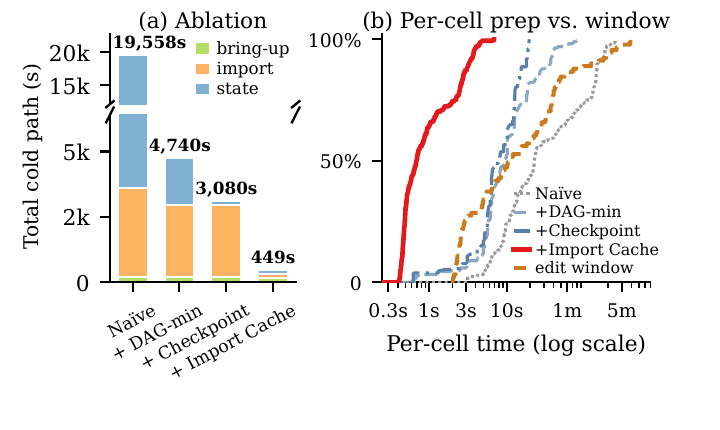
Figure 11: (a) 3 つの機構を累積的に有効にしたときの、ワークロード全体の cold 経路の準備時間の合計(ワーカー起動、モジュール import、状態の転送/復元に分けて表示)。(b) 各段階でのセルごとの cold 準備時間の分布と、編集窓の分布の比較。
測定では GPU ワーカーを毎セル後に解放するので、全 GPU セルが新しいワーカーで準備し、cold 経路の全体を払う。 Figure 11(a) は 3 つの機構を順に有効にした結果である。
| 構成 | cold 準備の合計 | 変化 |
|---|---|---|
| Naive | 19,558 s(うち 15,951 s が名前空間全体の移動) | — |
| + DAG-min | 4,740 s | 状態の項が 8.9 倍、合計が 4.1 倍に縮む |
| + Checkpoint | 3,080 s | 状態の項が 124 s に下がる |
| + Import Cache | 449 s | import の項が 18 倍縮む |
3 段で、cold 経路は 44 倍 縮む。
単一モデル状態での復元と保存のコスト(Table 3)は次のとおり。 full save は状態の初回保存で、全体を書く。 増分保存は 2 回目以降のセルが出し、変わった領域だけを更新する。
| モデル | 状態サイズ | Full save | Restore | 増分保存 |
|---|---|---|---|---|
| DINOv3-L | 1.2 GB | 0.18 s | 0.29 s | 29 ms |
| ESMC-300M | 2.7 GB | 0.41 s | 0.48 s | 47 ms |
| Mistral-7B | 14.5 GB | 1.57 s | 2.03 s | 66 ms |
| Qwen3-8B | 15.1 GB | 1.63 s | 2.04 s | 19 ms |
復元は DMA が支配する。 14〜15 GB のモデルの再読み込みに約 2 秒かかり、速度は 7.6〜8.1 GB/s である。 転送はインスタンスの host-to-GPU の PCIe 経路を通り、測定した pinned メモリ帯域のピークは 12.4 GB/s である。 残りの時間は、Python オブジェクトの構造を再構築するのに使われる。
3 機構を全て有効にしたときの cold 準備は、セルあたり中央値 0.71 秒、p95 3.8 秒、最大 6.9 秒である。 編集窓の分布の中央値は 10.7 秒で、準備を編集中に隠す余地は大きい。 ただし論文は、これは全ての cold 準備が完全に隠れることは意味しないと注記する。 図はセルごとに準備時間と実際の編集窓を対応づけておらず、長い準備が短い窓と重なることもありうる。
透過的な GPU チェックポイント/リストアとの比較(§4.5)
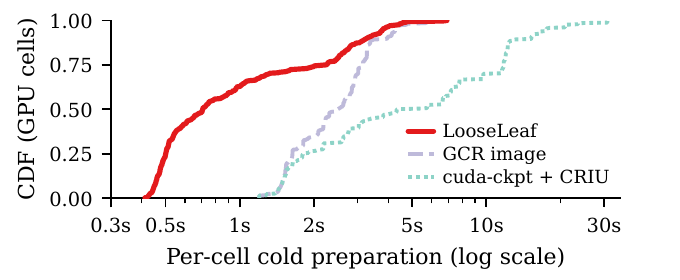
Figure 12: LooseLeaf の復元コストを、最先端の透過的なチェックポイント/リストアと比較したもの。
CRIU + cuda-checkpoint は、カーネル プロセスと GPU メモリを一緒に保存し、必要時に両方を復元する。 GCR は、GPU メモリを PCIe 帯域に近い速度で復元する最近の GPU チェックポイント システムである。 どちらの方式も、まずコンテナを起動し、続いてセッションが溜めたプロセス メモリと GPU メモリを読み込む。 復元時間は、測定したメモリ サイズと転送速度から 推定 している。
| 方式 | セルあたり cold 準備の中央値 |
|---|---|
| LooseLeaf | 0.71 s |
| GCR ベース | 2.50 s |
| CRIU ベース | 4.38 s |
差は、各方式が復元する状態の量から来る。
チェックポイント系は、セッション全体を復元し、データを動かす前にコンテナ起動の固定コストも払う。
LooseLeaf は、対象セルの state closure と import closure だけを復元する。
チェックポイント系が速いのは裾だけである。
LooseLeaf の最遅のセルは 6.9 秒で、その大半は bitsandbytes の import に費やされる。
bitsandbytes は CUDA 安全でないパッケージで、import cache では最適化できない。
保存が間隔に収まる理由(§4.6)
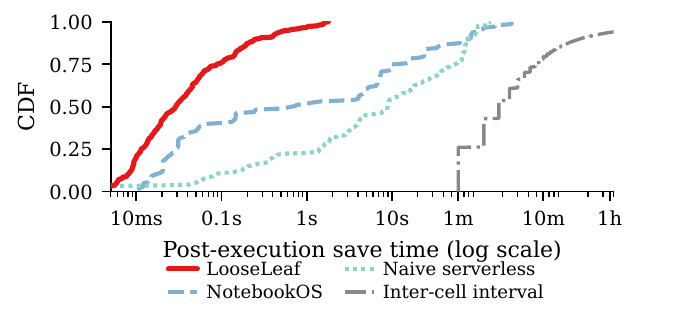
Figure 13: 各方式の実行後の保存時間を、本番トレースのセル間間隔と比較したもの。
第 2 の遅延源は、前のセルの保存である。 LooseLeaf の保存は、2 段階で増分的である。 セルが更新した変数だけを保存し、GPU tensor の中ではさらに、前回のチェックポイント以降に変わった 2 MB 領域だけを更新する。 Table 3 に見るとおり、15 GB の状態の full save は 1.6 秒(D2H DMA で 9.6 GB/s)だが、後続のセルの増分保存は数十ミリ秒である。
NotebookOS は同期のたびに完全なモデルと optimizer の状態を保存し、Naive serverless は毎セル後に名前空間全体を保存する。 Session-pinned と Modal は、状態を実行中のカーネルにだけ持ち、何も書き戻さない。
| 方式 | 保存時間 |
|---|---|
| LooseLeaf | 中央値 29 ms、最大 1.8 秒未満。トレースの最小間隔は 60 秒なので、次の実行を遅らせる保存は無い |
| NotebookOS | p95 で 109 秒、最大 254 秒(LooseLeaf の p95 の 177 倍)。トレースの間隔の 4.6% を超過 |
| Naive serverless | 間隔の 6.8% を超過 |
間隔を超過する保存が、§4.3 の遅延の裾の原因である。 速い保存はプロビジョニングにも効く。 暖かいワーカーは、保存が終わって初めて退避できる(退避で状態を失ってはならないため)。 LooseLeaf の保存は毎セル後の数秒で終わるので、全ての暖かいワーカーがほぼ即座に退避可能になり、§4.2 の需要追従型のプロビジョニングが可能になる。
関連研究との関係
論文は、NotebookOS を最強のベースラインと位置づけ、評価で比較している。 NotebookOS は、セルへ GPU を割り当てる点では同じ方向だが、3 つの永続レプリカを CPU メモリに常駐させる。 そのため、スケールインできない下限(上の結果では 24 GPU)が残る。 LooseLeaf はレプリカを持たず、状態を checkpoint store に置く。 詳細は NotebookOS のノートを参照。
論文の Related Work は、次の整理をしている。
- ノートブックの状態管理: ElasticNotebook は、ライブ マイグレーションのためセッション状態をチェックポイントし、変数ごとに保存と再計算を選ぶ。Kishu は、セッション状態をバージョン管理し、増分チェックアウトで過去の状態を復元する。Chipmink は、オブジェクト グラフをコストに基づく pod に分割し、変わった pod だけを永続化する。nbsafety は、セル間の lineage をたどって古い結果を警告する。これらは、1 つの長命カーネルで動くセッションの CPU 状態 を扱い、チェックポイントは、障害・チェックアウト・移行のときに読み戻される。LooseLeaf はこの系譜を、ワーカー間を移動する GPU 上の状態 へ広げる。しかも store が実行経路上にあり、全てのセルが closure を store から復元し、更新変数を書き戻す。
- 透過的な GPU チェックポイント/リストア: CRIU + cuda-checkpoint、PhoenixOS(実行と並行して GPU アプリをチェックポイント)、GCR(dirty 領域の増分チェックポイントで PCIe 帯域近くで復元)。これらは透過的で、アドレス空間全体を捕まえ、セルが要る部分を区別できないので、復元は常にセッション全体を運ぶ。LooseLeaf は対象セルの state closure だけを復元し、復元した変数間のオブジェクト共有も保つ。差は §4.5 に定量化されている。
- サーバーレス データ システムとコールド スタート: Starling、Lambada(クラウド関数での分析)、Cloudburst(キャッシュを関数 executor に同居)、Vexless(ベクトル インデックスをステートフル関数に)、Azure SQL Database Serverless(次の要求の前に停止中のデータベースを再開)。一般的なプラットフォームでは、事前ビルドしたスナップショット、予測したキープアライブ窓、初期化済み CUDA コンテキストのスナップショットで、関数の起動遅延を減らす。これらは、次の要求が届くまで、要求が必要とする状態を決められない。そのため、完全な状態を用意しておくか、critical path で取得する。ノートブックでは次のセルのコードが実行前に分かるので、LooseLeaf はそのセルの closure だけを、実行の要求の前に編集中に用意する。
評価と動機づけのデータには、JuNE(編集窓の実測)が使われている。 DSPM(LLM 補助の貼り付けから実行まで)の対話ログと、NotebookOS の論文の Adobe トレース(セル間の到着間隔)も使われている。
論文が明記している前提・限界
- 静的解析で closure を厳密に決められるのは、
execやglobals()のような動的な名前空間アクセスを除く場合である。 - 静的解析は in-place 更新を検出できないので、保存では closure の全変数と、そこから届く全変数を再シリアライズする(構造 blob だけで軽いとされる)。
- CUDA に触れるパッケージ(例:
bitsandbytes)は import cache に入れられず、fork 後に import する。評価でも、最遅の cold 準備の主因になっている。 - 編集窓が cold 準備より短いセルでは、準備の残りが露出する。72 セッションで hit 率が 48% に落ちると、その露出が増える。
- 古い prefetch は、カバーしきれなかった準備時間のコストを払うだけで、正しさには影響しない。
- 透過的 C/R との比較(§4.5)の復元時間は、実測でなく、測定したメモリ サイズと転送速度からの推定である。
- 図 11 は、セルごとの準備時間と実際の編集窓を対応づけていないので、全ての cold 準備が隠れるとは言えない。
Q&A
自分のコメント
(ここは自分で都度書く欄。)