AI解説
実装: SiloR(Silo データベースの上に構築)。https://github.com/stephentu/silo(Silo 本体、著者による公開実装) 情報源: OSDI 2014 論文本文(全14頁、付録含む)を精読して記述。本文に書かれていない事項は書いていない。
一言で
マルチコアのインメモリデータベース Silo に、ロギング・チェックポイント・リカバリを追加した SiloR。ログ生成、チェックポイント生成、リカバリのすべてでマルチコア並列性を徹底的に活用し、通常実行のスループットをほとんど落とさずに、43.2GBのキーバリューデータベースを106秒、70GB超のTPC-Cデータベースを211秒で復旧できることを示す。
背景・問題
現代のマルチコア・インメモリデータベースは1秒あたり数百万から数千万件のトランザクションを処理できるが、クラッシュや電源障害からの頑健性が弱点になりうる。レプリケーションはある拠点を別の拠点で代替させられるが、相関障害(複数拠点が同時に影響を受ける障害)に耐えるにはレプリケートされたデータベースでも永続ストレージへの書き込みが必要であり、永続化と復旧の両方の性能が問題になる。
ロギングやチェックポイントのような耐障害機構は、素朴に実装すると実行を大きく遅くする。1秒あたり数千万件の小さなトランザクションをさばく高速なインメモリデータベースは、値かオペレーションのいずれをログしても毎分50GBを超えるログデータを生成しうる。これはトランザクションレートとログサイズの両面で、それまでのインメモリデータベース永続化研究で報告された値より数桁大きい。ログをディスクやフラッシュへ書くこと自体はログ書き込みが逐次的なので理論上は速いが、逐次的なログ再生は現代のマルチコアマシンでは速くない。チェックポイントも、ログを無限に伸ばさないために必要だが、データベース全体を走査する必要があり、データ移動とキャッシュ汚染によって並行するトランザクション性能を落としうる。単一コアでの数ギガバイト規模のデータベース復旧は90分を超えることがあり、レプリケートされたシステムでもこれは長い。
著者らの目標は、トランザクションスループットへの犠牲を比較的低く抑えた完全な永続性を持ち、かつレプリケーションなしで数分以内にトランザクション一貫性のある状態へ復旧できるインメモリデータベースを作ることだった。
提案手法
Silo のエポック機構
Silo は楽観的並行性制御(OCC)の一種を使い、トランザクションID(TID)を中心に直列化する。古典的な OCC はコミットするトランザクションの TID を大域カウンタのインクリメントで得るが、現代のマルチコアハードウェアでは大域カウンタが性能を制約する競合の原因になりうる。Silo はこの競合を、TID に埋め込まれたエポックという時間区間で解消する。大域エポック番号 E は全スレッドから見え、指定されたスレッドが40ミリ秒ごとにこれを進める。新しい TID は、(a) read-set 内のどの TID よりも大きく、(b) そのワーカーが最後にコミットした TID よりも大きく、(c) エポック E に属する、という条件で決まる。
ここで根本的な問題が生じる。並行するトランザクション T1、T2 で T1 が読んだキーを T2 が後で上書きする場合(反依存、anti-dependency)、T1 は T2 より前に順序付けられねばならないが、Silo の TID にはこの依存を伝える通信が一切なく、TID(T1) > TID(T2) となりうる。つまり TID 順にコミット済みトランザクションを再生すると、間違ったデータベース状態を復旧しかねない。エポックはこの正しい再生の鍵になる。x86-64 のような TSO(total-store-order)アーキテクチャでは、指定スレッドによる E の更新は全ワーカーに同時に見えるため、ワーカーが直列化点でエポックを読む限り、異なるエポックを持つ TID の順序は常に直列順序と両立する。エポックはさらに一種のグループコミットを提供し、SiloR はエポック単位で永続化と復旧を行う。
ロギング — value logging と epoch ベースの group commit
SiloR ではトランザクションを実行するワーカーと、ロギング・チェックポイント・その他の維持作業だけを担うロガースレッドとに責任が分かれる。ワーカーはコミット時にログレコード(コミットした TID と、そのトランザクションが変更した全レコードのテーブル・キー・値情報)を生成し、専用バッファプールから取ったメモリバッファへディスク形式で格納する。バッファが満杯になるかエポック境界に達すると、ワーカーは共有メモリキュー経由でそのバッファをロガーへ渡す。
SiloR はvalue logging(オペレーションログではなく値そのものをログする)を選ぶ。これは復旧の並列性を優先した設計判断である。value logging は並列に再生しやすい——同じキーへの複数の変更があっても、最大の TID を持つエントリだけが勝てばよい。これは TID が依存関係(書き込みの順序)を反映しており、かつエポック単位で復旧するため反依存が問題にならないために成り立つ。対照的にオペレーションログは、元の直列順序で再生する必要があり並列化しにくいうえ、反依存を守るために read-set(キーとTID)までログする必要が生じる。
ワーカーは1つのロガーへ、ロガーは1つのディスクへという構成を取り、コア・ピニングでロガーとそのワーカー群が同じソケット上で動くようにすることでリモートメモリアクセスを避ける。ログバッファは512KBで、ロガーはバッファが埋まるかエポックが変わるたびに(どちらか早い方で)ワーカーへ返す。
pepoch — 永続エポックの計算
各ログファイルはどのエポックの記録を含むか以外の追加情報を持たず、複数ロガーが独立に別ディスクへ書くため、単一のログだけでは復旧に十分な情報にならない。そこで専用のロガースレッドが pepoch ファイルへ現在の永続エポックを維持する。この計算は次の手順で行われる。
- 各ワーカー
wは自分の現在のエポックe_wを公表し、これ以降にロガーへ送る全てのトランザクションのエポックがe_w以上であることを保証する。ログバッファをロガーへフラッシュした後、e_w ← Eに更新する。 - 各ロガー
lはワーカーからログバッファを読み、ログファイルへ書く。 - 各ロガーは定期的に書き込みを永続化することを決め、そのとき自分の担当ワーカー群の
e_wの最小値と、まだ書かれていないログバッファのエポック番号の最小値を取り、これをそのロガーの現在のエポックe_lとする。ロガーはその後、全ての書き込みをディスクへ同期する。 - この同期が完了すると、ロガーは
e_lを公表する。これは、このロガーのワーカー群についてエポック< e_lの全トランザクションが永続化されたことを保証する。 - 専用のロガースレッドが定期的に、全ロガーにわたる
min{e_l} − 1として永続エポックe_pを計算し、pepochファイルへ書いてディスクへ同期する。 pepochが永続化されると、専用のロガースレッドはe_pを大域変数へ公表する。この時点で、エポック≤ e_pの全トランザクションが永続化されたことになり、ワーカーはその結果をクライアントへ返せる。
このプロトコルはグループコミットの一形態を提供するが、トランザクションコミットのクリティカルパスに(ログファイル用とpepoch用の)2回の fsync を含むという欠点があり、レイテンシをいくらか増やす。
チェックポイント — inconsistent(fuzzy)チェックポイント
チェックポイントはチェックポインタスレッドが書き、ディスク1台につき1スレッドを割り当てる。データベースは n 個のディスクの数だけスライスに分割され、各チェックポインタがおよそ 1/n を担当する。OCC はコミット時に変更を反映するため、チェックポインタが見る全てのレコードはコミット済みであり、これはARIES 流の undo ログと redo ログの両方が不要で、ログには引き続き “redo” レコードだけを含めればよいことを意味する。ただし並行するトランザクションはチェックポインタとレコード単位のロック以外で協調しないため、あるトランザクションの複数の変更をチェックポインタが全て見る保証はない。この結果 SiloR のチェックポイントはinconsistent(fuzzy)になる——直列順序上のある一点でのデータベースの一貫したスナップショットとは限らない。一貫したスナップショットへ復旧するには、常にチェックポイントの復元とログの再生の両方が必要になる。
inconsistent チェックポイントを選んだ理由は、一貫したチェックポイントよりメモリ使用の点でコストが低いからである。一貫したチェックポイントを取ろうとすると、書き込みに数十秒かかる間データベース全体が書き換えられうるため、スナップショットを保持するメモリコストと、新しい更新を(上書きではなく)新規に割り当てたレコードへ格納するコストがかかり、通常実行時のスループットを10%程度落とすことが分かった。
重要な最適化として、チェックポインタはエポック ≥ e_l(チェックポイント開始エポック)で現在のエポックを持つレコードをスキップする。inconsistent チェックポイントを e_l から始めた以上、常にログを e_l から再生する必要があるため、その後ログで再生されるレコードをチェックポイントへ書く必要はない。この最適化によりチェックポイントサイズは20%以上削減される。
リカバリ — チェックポイント復元と並列ログ再生
チェックポイントは n × m 個のスレッド(n はディスク数、m はディスクあたりのファイル数)で並列に復元される。各スレッドは1つのディスクから読み、キー・値・TID の三つ組を対応するインデックス木へ挿入する。
チェックポイント復元後、ログ復旧に移る。ログファイルは実行時に整理されておらず、様々なインデックス木への変更が入り混じっているが、value logging はログをどの順序で処理しても同じ結果になるという性質を持つ。あるキーへの複数の変更があっても、最大の TID を持つエントリだけが結果に反映されればよいためである。マネージャスレッドはまず pepoch ファイルを読んで e_p を得て、e_p より後のエポックを持つ記録は無視する(グループコミットが完了していないエポックを処理すると、直列順序の prefix に対応しないデータベースになりかねないため)。各ディスクについて g = ⌈N/n⌉ 個のログプロセッサスレッドを起動し(N はコア数)、まだ処理されていないファイルのうち最新のものから逆順に処理する。値ログの再生順序は結果に影響しないが、キーが複数回書き換えられている場合、逆順(新しいファイルから)に処理する方が、木の現在値がログレコードより新しいために上書きが不要になるケースが増え、CPU を効率よく使えるとしている。
実験・結果
評価環境は4基の8コア Intel Xeon E7-4830(合計32物理コア)、256GB DRAM、3台の Fusion ioDrive2 フラッシュドライブと1台の RAID-5 ディスクアレイ。比較対象は SiloR(フル機能)、LogSilo(ロギングのみ、チェックポイントなし)、MemSilo(永続化なしの Silo 本体)。
- YCSB 変種ワークロード(read/write比70/30、レコード100バイト、400M キーで計43.2GB):SiloR は8.76 Mtxn/s(MemSilo の10.83 Mtxn/sの80%)を達成し、チェックポイント実行中でもスループットを大きく落とさなかった。平均レイテンシは90ミリ秒/トランザクション。
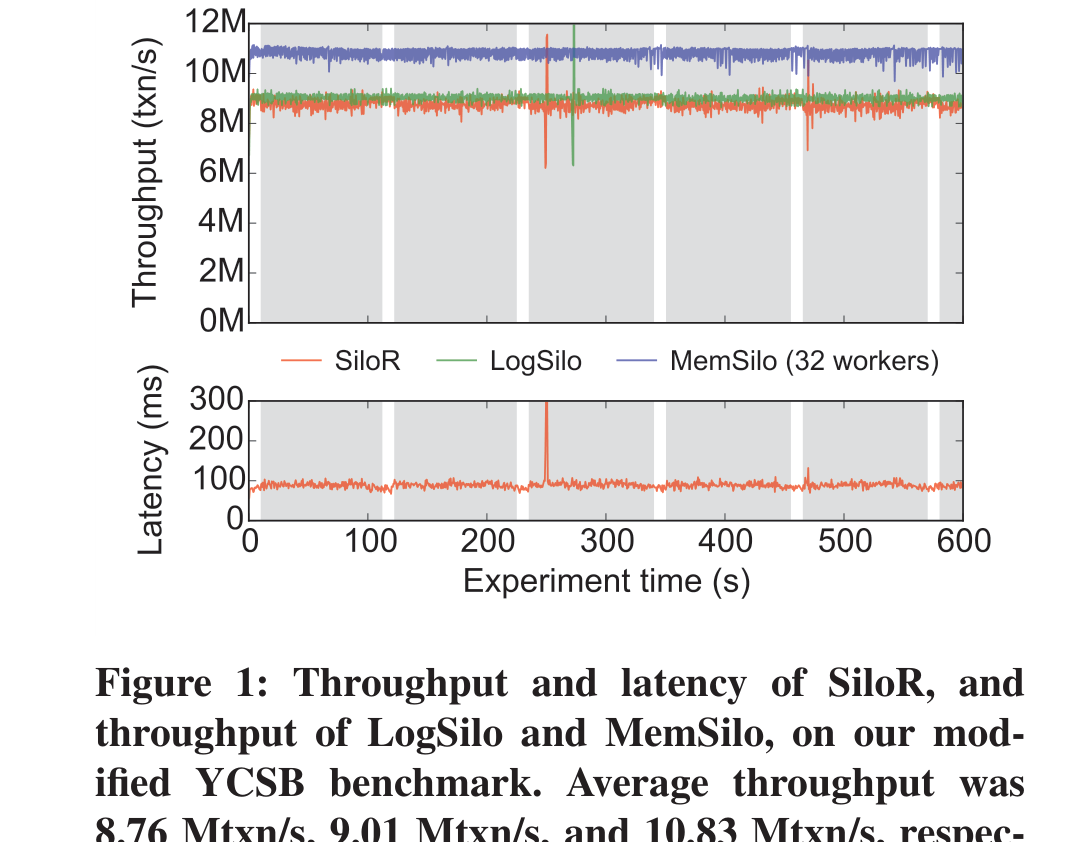
Figure 1: Throughput and latency of SiloR, and throughput of LogSilo and MemSilo, on our modified YCSB benchmark.
- fsync頻度の重要性:チェックポイント完了後に1回だけ fsync する素朴な戦略は、スループットとレイテンシに激しいバースト(レイテンシは最大2秒に達する)を引き起こした。32MBごとに定期的に fsync する SiloR の方式は、このバースト性をほぼ解消した。
- TPC-C ワークロード:10プライマリテーブルと2セカンダリインデックスを持つ、新規注文45%・配送4%を含む標準構成で、データベースは実験中に2GBから94GBまで成長。SiloR のスループットは MemSilo の約93%(548 Ktxn/s 対 592 Ktxn/s)で、平均レイテンシは110ミリ秒/トランザクション。
- リカバリ:チェックポイント完了直前にクラッシュさせ、再生すべきログを最大化する条件で測定。YCSB では43.2GBのデータベース(チェックポイント36GB+ログ64GB)を106秒で復旧し、うち33秒がチェックポイント、73秒がログ再生だった。TPC-C では72.2GBのデータベース(チェックポイント15.7GB+ログ180GB)を211秒で復旧し、うち17秒がチェックポイント、194秒がログ再生だった。いずれも復旧時間は読み込むべきデータ量にほぼ比例し(約1.06〜1.08秒/GB)、ログ再生が復旧時間の律速要因であるとし、頻繁なチェックポイントによってログ再生量を減らす設計判断を正当化している。
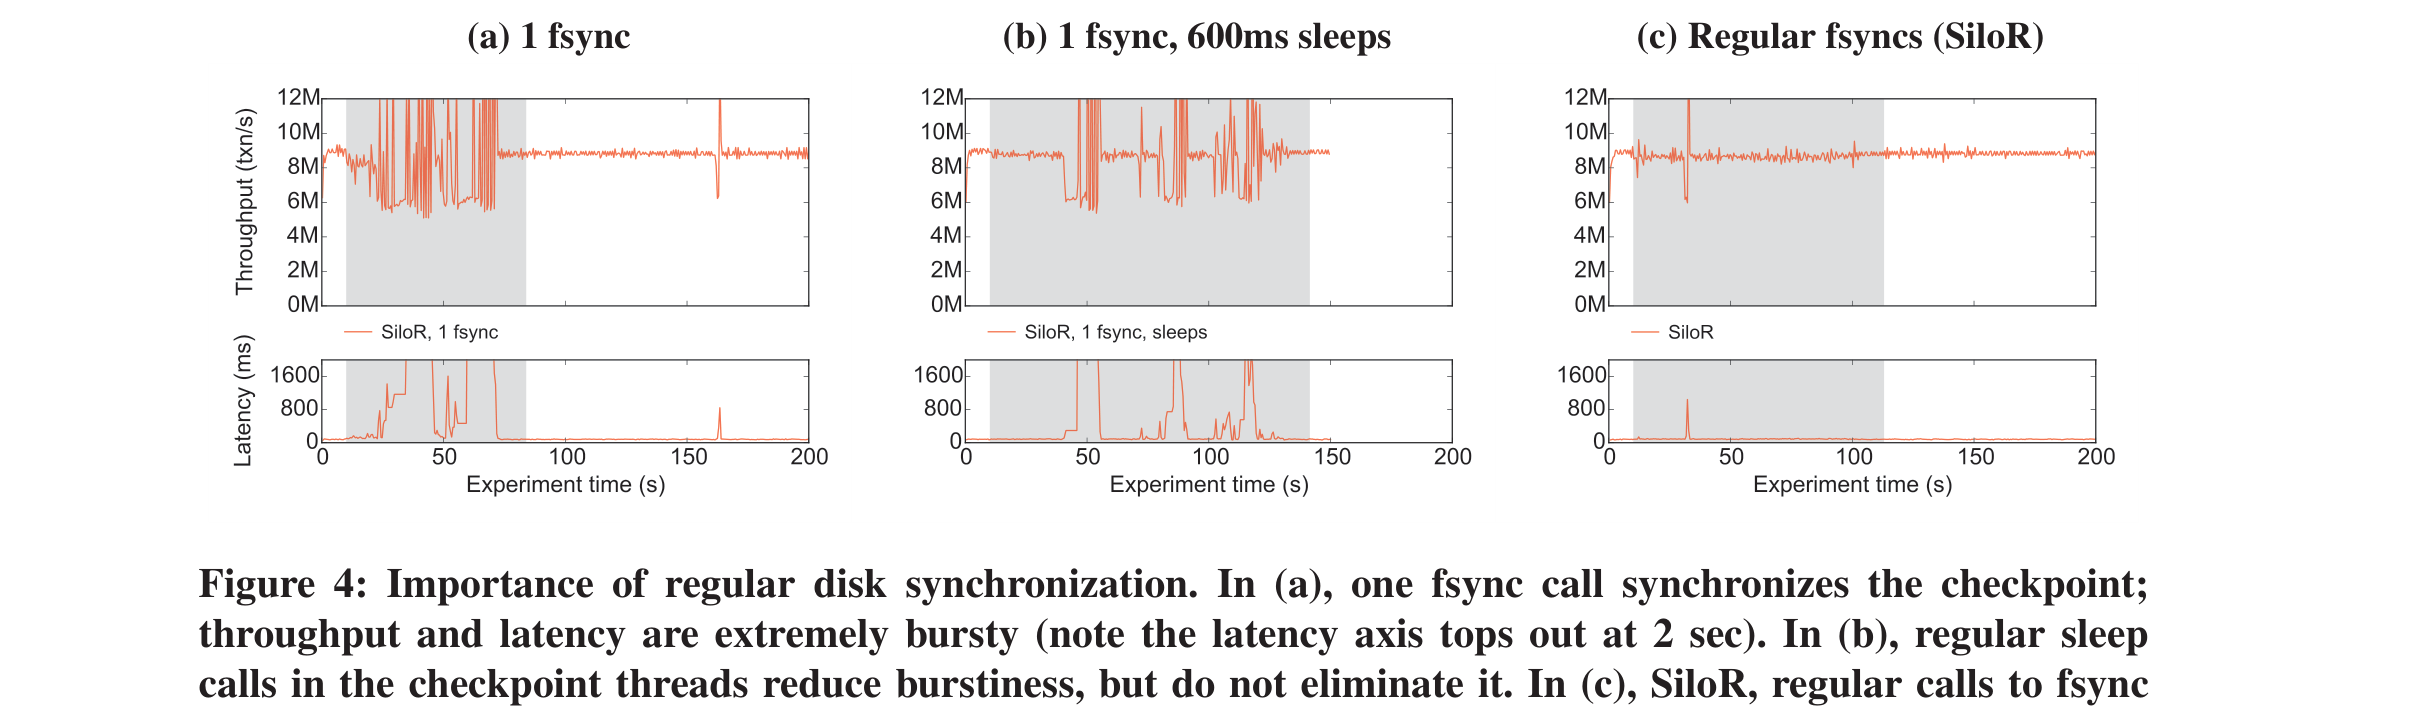
Figure 4: Importance of regular disk synchronization.
関連研究との関係(メモ)
- ARIES(cite key
mohan1992aries):論文自身が「データベースのログとチェックポイントの黄金律」と位置づける。ARIES はコミット前のデータをチェックポイント相当の状態へフラッシュしうるため undo ログと redo ログの両方が必要だが、SiloR は OCC を使うためコミット前のデータがチェックポイントに現れることがなく、redo(value)ログだけで足りると説明している。 - VoltDB(Malviya らの評価を含む):VoltDB はコマンドロギング(オペレーションログの一種)を使い、パーティション化されたデータの利点でコマンドログをある程度並列に復旧できるが、コマンドログはトランザクション一貫性のあるチェックポイントを要求し、全レコードを copy-on-write としてマークするコストを伴う。論文はこれを「受け入れがたいコスト」としている。
- RAMCloud:ホットバックアップとレプリケーションによって64GB超のデータを1〜2秒で復旧できる、SiloRより大幅に速い代替。ただしトランザクションをサポートせず、復旧時のフラグメンテーションはデータベースの文脈では複数マシン間の調整コストを増やすため望ましくないとしている。
- 分野横断的な位置づけは アプリケーションレベルのチェックポイント の §3.4 を参照。
Q&A
(自分がAIに実際に質問したことだけをQ/A形式で残す。まだなし。)
自分のコメント
(ここは自分で都度書く欄。)