AI解説
実装: Apache Spark 情報源: NSDI 2012 論文本文(全14頁)を精読して記述。本文に書かれていない事項は書いていない。
一言で
Resilient Distributed Datasets(RDD)という、クラスタ上でのインメモリ計算を耐障害的に行える分散メモリ抽象を提案する。RDD は決定的な変換だけから作られる読み取り専用のコレクションで、細粒度の状態更新ではなく粗粒度の変換の記録(lineage)によって耐障害性を実現する。これを実装した Spark は、反復的な機械学習アプリケーションで Hadoop より最大20倍速く、あるデータ分析レポートを40倍高速化し、1TBのデータセットに対して5〜7秒のレイテンシで対話的にクエリできる。
背景・問題
MapReduce や Dryad のようなクラスタ計算フレームワークは、ワークの分配や耐障害性を意識せずに高水準な演算子で並列計算を書けるようにしたが、分散メモリを活用するための抽象を欠いている。これは、複数の計算にまたがって中間結果を再利用するアプリケーション群にとって非効率になる。PageRank や K-means、ロジスティック回帰のような反復的な機械学習・グラフアルゴリズムでのデータ再利用や、同じデータ部分集合に対して複数のアドホッククエリを投げる対話的データマイニングがその代表例である。現行のフレームワークでは、計算間でデータを再利用する唯一の方法は、分散ファイルシステムのような外部の安定ストレージへ書き出すことであり、データ複製・ディスク I/O・シリアライズのオーバーヘッドがアプリケーションの実行時間を支配しうる。
Pregel(反復グラフ計算のために中間データをメモリに保持する)や HaLoop(反復 MapReduce インタフェース)のような特化型フレームワークもこの問題に取り組んでいるが、特定の計算パターン(MapReduce のステップ列をループさせるなど)しかサポートせず、そのパターンに限定した形でしかデータ共有を行わない。複数のデータセットをメモリへロードして横断的にアドホッククエリを走らせるといった、より一般的な再利用の抽象は提供していない。
提案手法
RDD の定義
RDD は形式的には読み取り専用の、パーティション分割されたレコードの集合である。RDD は (1) 安定ストレージ上のデータ、または (2) 他の RDD に対する決定的な操作を通じてのみ作成できる。これらの操作を(他の RDD 操作と区別するため)変換(transformation)と呼ぶ。map、filter、join がその例である。
RDD は常に実体化されている必要はない。RDD は自分がどの他のデータセットからどう導出されたか(そのlineage)についての情報を十分に持っており、安定ストレージ上のデータから自分のパーティションを計算できる。この性質は強力である。本質的に、プログラムは障害後に再構築できない RDD を参照することができない。
利用者はさらに RDD の2つの側面を制御できる。永続化(どの RDD を再利用するか、そのためにどのストレージ戦略を選ぶか、例えばインメモリ保存)と、パーティショニング(各レコードのキーに基づいて RDD の要素をマシン間でどう分割するか)である。
狭い依存と広い依存
RDD の表現で最も重要な設計判断は、RDD 間の依存関係をどう表すかである。論文はこれを2種類に分類することが十分かつ有用だとしている。狭い依存(narrow dependency)は、親 RDD の各パーティションが子 RDD の高々1つのパーティションでしか使われない依存で、map や filter がこれにあたる。広い依存(wide dependency)は、複数の子パーティションが1つの親パーティションに依存しうる依存で、join(親が hash-partition されていない場合)がこれにあたる。
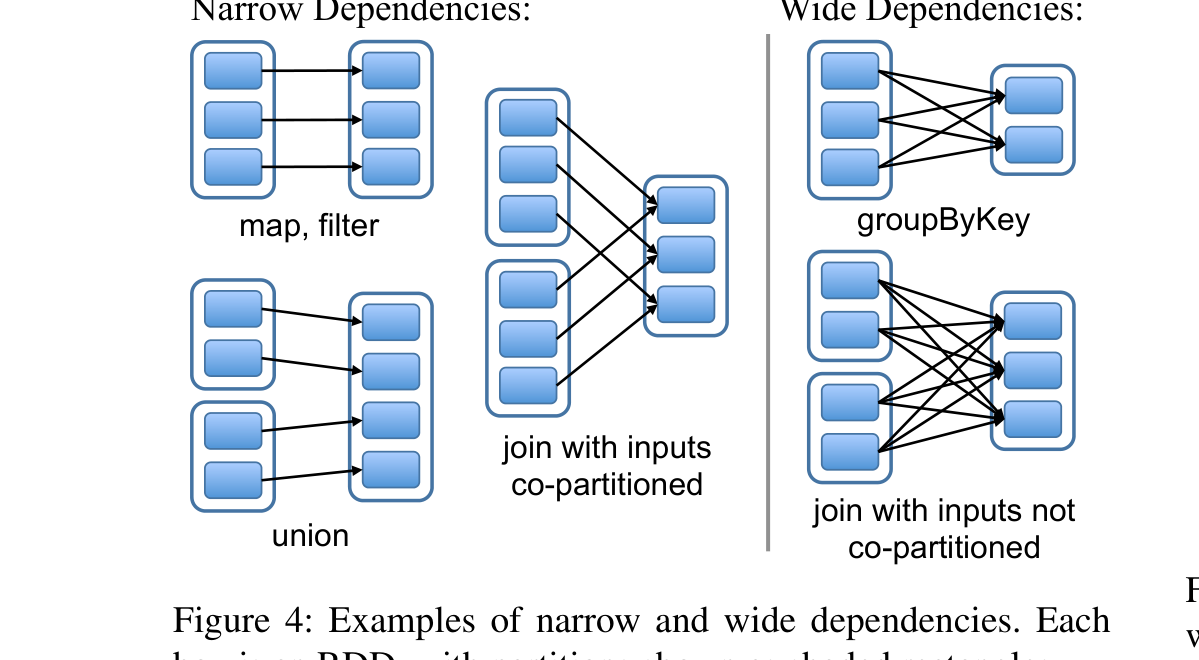
Figure 4: Examples of narrow and wide dependencies。
この区別が有用な理由は2つある。第一に、狭い依存は1つのクラスタノード上でのパイプライン実行を許す(親パーティションをすべて1ノードで計算できるため、map の後に filter を要素ごとに適用するといったことができる)。対して広い依存は、全ての親パーティションのデータが揃っている必要があり、MapReduce 的な操作でノード間をまたいでシャッフルされる必要がある。第二に、ノード障害後の復旧効率が異なる。狭い依存では失われた親パーティションだけを再計算すればよく、それらは異なるノード上で並列に再計算できる。対して広い依存を持つ lineage グラフでは、1ノードの障害が、ある RDD の祖先全てから一部のパーティションを失わせる可能性があり、完全な再実行が必要になりうる。
Lineage によるチェックポイントの回避
RDD と分散共有メモリ(DSM)の主な違いは、RDD が粗粒度の変換によってのみ作成(「書き込み」)される点にある。これはバルク書き込みを行うアプリケーションに RDD を限定する代わりに、より効率的な耐障害性を可能にする。RDD は lineage によって復旧できるため、チェックポイントのオーバーヘッドを被る必要がない。さらに、失われた RDD のパーティションだけが障害時に再計算されればよく、プログラム全体をロールバックすることなく複数のノードで並列に再計算できる。
RDD が読み取り専用であるという性質のおかげで、一般的な共有メモリよりもチェックポイントが単純になる。一貫性が問題にならないため、RDD はプログラムの一時停止や分散スナップショット方式を必要とせずにバックグラウンドで書き出せる。
チェックポイントが有効な場合(§5.4)
lineage は常に障害後の RDD 復旧に使えるが、lineage チェーンが長い RDD ではこの復旧が時間を要しうる。そのため、一部の RDD を安定ストレージへチェックポイントしておくことが役立つ場合がある。
一般に、広い依存を含み長い lineage グラフを持つ RDDではチェックポイントが有用である。PageRank の例における ranks データセットがこれにあたり、こうした場合クラスタ内のノード障害が各親 RDD から何らかのデータのスライスを失わせ、完全な再計算を要求しうる。対照的に、ロジスティック回帰の例における points や PageRank の links のように、安定ストレージ上のデータへの狭い依存を持つ RDD では、チェックポイントは価値がない場合もある。ノードが1台落ちても、こうした RDD の失われたパーティションは、RDD 全体を複製するコストのごく一部で、他のノード上で並列に再計算できる。
Spark は現時点でチェックポイントの API(persist への REPLICATE フラグ)を提供するが、どのデータをチェックポイントするかの判断は利用者に委ねている。ただし論文は、自動チェックポイントの可能性にも触れている。スケジューラは各データセットのサイズと最初の計算に要した時間の両方を把握しているため、システムの復旧時間を最小化するようなチェックポイント対象 RDD の最適な集合を選べるはずだとしている。
実装
Spark は約14,000行の Scala で実装され、Mesos クラスタマネージャ上で動作し、Hadoop や MPI などの他のアプリケーションと資源を共有できる。RDD は共通インタフェース(パーティション集合、親への依存集合、パーティションを計算する関数、パーティショニング方式に関するメタデータ)を通じて表現され、この設計のおかげでスケジューラに特別なロジックを追加することなく、ほとんどの変換を20行未満のコードで実装できたとしている。
スケジューラは、アクションが呼ばれた RDD の lineage グラフをたどってステージの DAG を構築する。各ステージは、可能な限り多くの狭い依存の変換をパイプライン化して含む。ステージの境界は、広い依存に必要なシャッフル操作、または既に計算済みで親 RDD の計算を打ち切れるパーティションのいずれかによって決まる。
実験・結果
評価は主に Amazon EC2 上、m1.xlarge ノード(4コア、15GB RAM)、HDFS ストレージ(256MBブロック)で行われた。
- 反復機械学習:ロジスティック回帰と K-means を100GBのデータセット、25〜100台のマシンで10イテレーション実行。ロジスティック回帰では2回目以降のイテレーションで Hadoop に対し25.3倍、インメモリバイナリ形式の HadoopBinMem に対し20.7倍高速化した。計算量の多い K-means でも1.9〜3.2倍の高速化を達成した。
- PageRank:54GBのWikipediaダンプ(約400万記事のリンクグラフ)で10イテレーション実行。インメモリ保存だけで30ノード上でHadoopに対し2.4倍の高速化、RDDのパーティショニングをイテレーションをまたいで一貫させる最適化を加えると7.4倍まで向上し、60ノードまでほぼ線形にスケールした。
- 障害復旧:75ノードクラスタでK-meansの10イテレーションを実行し、6回目のイテレーション開始時に1台のマシンを強制終了する実験を行った。障害がない場合、各イテレーションは約58秒だった。6回目のイテレーションでは、失われたタスクとパーティションを他のノード上で並列に再実行し、lineageによってRDDを再構築した結果、イテレーション時間は80秒に伸びた。失われたパーティションの再構築が終わると、イテレーション時間は58秒に戻った。論文は、チェックポイントベースの復旧機構であれば、チェックポイントの頻度次第で少なくとも数イテレーション分の再実行が必要になり、さらにシステムはアプリケーションの100GBの作業セットをネットワーク越しに複製する必要があり、Sparkの2倍のメモリを消費してRAM上に複製するか、100GBをディスクへ書き込むまで待つ必要があると指摘し、対照的にこの例のRDDのlineageグラフはいずれも10KB未満のサイズだったとしている。
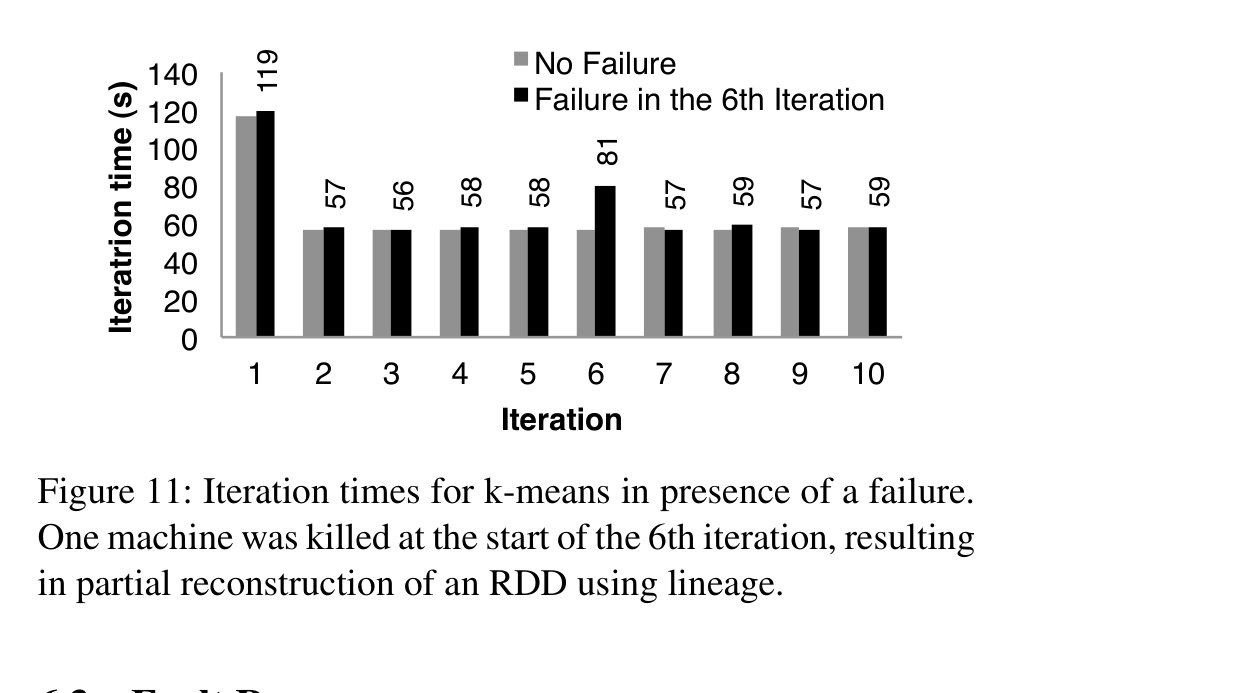
Figure 11: Iteration times for k-means in presence of a failure。
- 対話的データマイニング:1TBのWikipediaページビューログ(2年分)に対するクエリで、100台のm2.4xlargeインスタンスを使い、5〜7秒のレスポンスタイムを達成した。これはディスク上のデータを扱う場合(1TBファイルのクエリに170秒)より1桁以上速い。
lineage の具体例
errors = lines.filter(...) のように連鎖する変換の例では、対応する lineage graph は各 RDD を箱、変換を矢印とするグラフとして表される。ある RDD のパーティションが失われても、対応する親 RDD のパーティションにだけ変換を再適用すればよい。
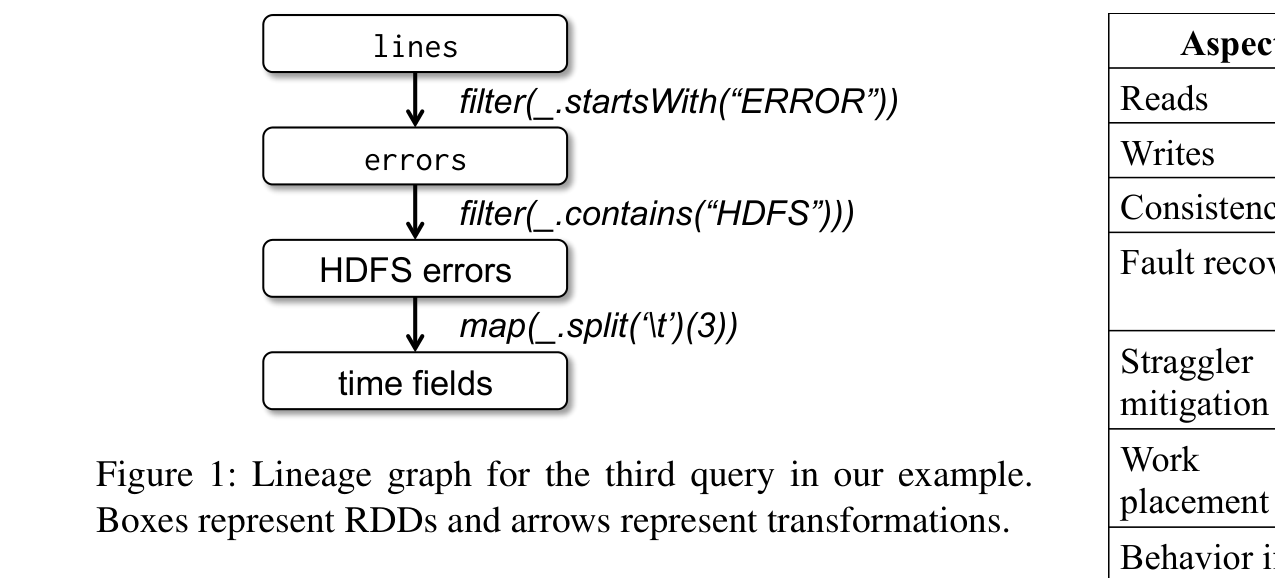
Figure 1: Lineage graph for the third query in our example。箱がRDD、矢印が変換を表す。
関連研究との関係(メモ)
- Flink の Asynchronous Barrier Snapshotting(cite key
carbone2015abs):ストリーム処理は「保存する」立場、Spark は「lineageをたどって再計算する」立場という対照をなす。ただし RDD 自身も、広い依存を含み長いlineageを持つデータセットに限ってはチェックポイントを推奨しており、二択ではなく「既定値をどちらに置くか」の違いとして読める。 - ElasticNotebook(
li2023elasticnotebook):保存する変数と再計算する変数をコストモデルの最小カットで最適化する ElasticNotebook の設計は、RDD が「チェックポイントするかどうか」を lineage の長さと依存の広さという単純な指標だけで判断している点と対比できる。詳細は アプリケーションレベルのチェックポイント の §5(橋)を参照。
Q&A
(自分がAIに実際に質問したことだけをQ/A形式で残す。まだなし。)
自分のコメント
(ここは自分で都度書く欄。)