AI解説
論文: Ziqi Yuan, Haoyang Zhang, Yirui Eric Zhou, Apoorve Mohan, I-Hsin Chung, Seetharami Seelam, Jian Huang(UIUC と IBM Research)。arXiv:2506.06472v1、2025-06-06。 情報源: arXiv PDF(12 ページ)の本文、図、参考文献を読んだ。arXiv 版は 2 つの図のサブ図の番号が重複するなど、体裁が粗い。 図について: PDF のページを画像化して切り出した。Figure 1、2、4、7 だけを収録している。Figure 3、5、6、8、9 は文章で述べるにとどめた。 対象の注意: この論文の対象は、LLM 学習中のテンソルの GPU↔SSD の退避と先読みである。チェックポイントの保存や復元ではない。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+
robots.txtで検索除けされている。
一言で
LLM 学習の 1 イテレーションでは、GPU メモリのうち、いま実行中のカーネルが使うテンソル(active)は、平均 1.7% にすぎない。 残りの不活性なテンソルは長く使われないので、SSD に退避して先読みすれば、GPU を止めずに済む。 Teraio は、最初の数イテレーションでテンソルの寿命を測り、退避と先読みの計画を作って、GPUDirect Storage(GDS)で GPU と SSD の間を直接転送する。 ZeRO-Offload と ZeRO-Infinity に対して、学習の速度が平均 1.47 倍になり、メモリが無限にある理想の 80.7% に達した。
背景・問題
解くべき問題
LLM の学習に必要なメモリは、GPU メモリの増加より速く増える。 ホストメモリへの退避は、ホストの DRAM の容量で頭打ちになる。 SSD への退避は、既存の方法(ZeRO-Infinity など)では、SSD の帯域を使い切れず、遅い SSD アクセスを隠せない。 論文は ZeRO-Infinity について、DNN の層の粒度で退避する粗い方式が、限られた SSD 帯域を無駄にすると述べる。
特性調査(§2)
2 基の H100 で Llama3-8B、Llama3-70B、GPT2-40B、T5-11B を調べた。
- active なテンソルは、GPU メモリ容量の 14% 未満(平均 1.7%)にとどまる(Figure 1)。
- 多くのテンソルは 10 MB〜1 GB の大きさで、40% 超が 10^4 マイクロ秒より長く不活性である(Figure 2)。この時間は、6.5 GB/s で SSD に移すのに要する時間より長い。
- 退避の帯域が 32〜48 GB/s あれば、理想に近い性能になる(Figure 3、性能モデルによるシミュレーション)。1 台の SSD は 6.5 GB/s 程度なので、複数台の束ねが要る。
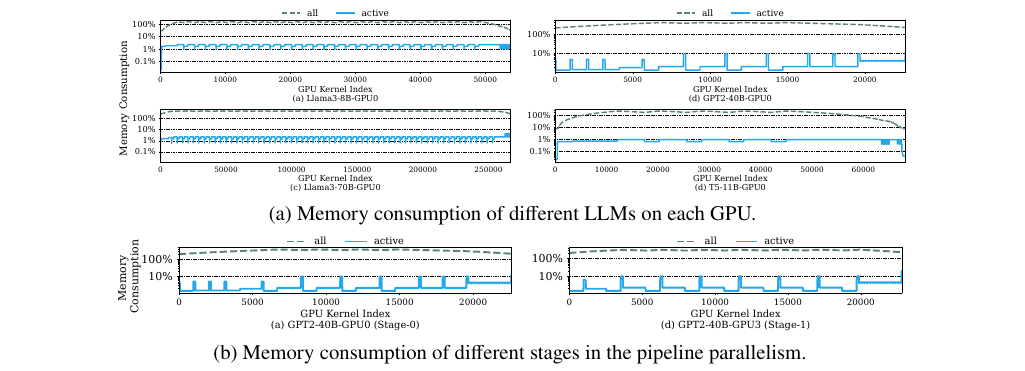
Figure 1: 並列学習の 1 イテレーションでの、全テンソルと active テンソルのメモリ消費(GPU メモリ容量に対する比、対数軸)。(a) モデルごと、(b) パイプラインのステージごと。
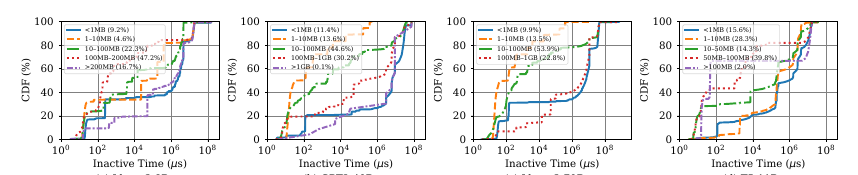
Figure 2: テンソルの不活性期間(マイクロ秒)の累積分布。(a) Llama3-8B、(b) GPT2-40B、(c) Llama3-70B、(d) T5-11B。
提案手法
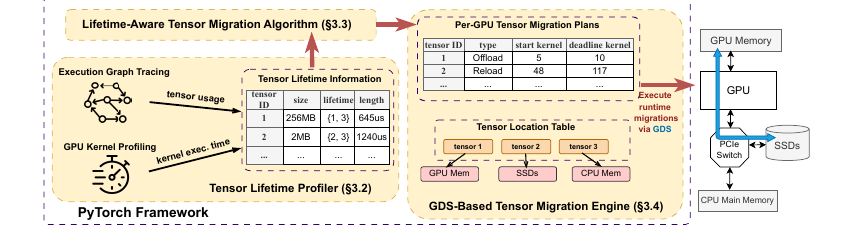
Figure 4: Teraio のシステム概要。寿命プロファイラ、寿命を考慮した移動計画、GDS ベースの移動エンジン。
- 寿命プロファイラ(§3.1)。PyTorch の演算子の実行を追って、テンソルがいつ active になるかを測る。最初の数イテレーションで学習の実行グラフが決まり、後のイテレーションでも同じ挙動をする、という前提を使う。
- 寿命を考慮した移動計画(§3.2)。GPU メモリの容量を超えないことと、移動の通信量を最小にすることの 2 つを目標に、退避するテンソルと時刻を決める。移動先は、できるだけ SSD にする。
- GDS を使った移動エンジン(§3.3)。GPU と SSD の間の移動に GDS を使う。理由は、マルチ GPU でホストの CPU が律速になることである。論文の例では、8 GPU の構成で理想に近づけるには、GPU 1 基当たり 32〜48 GB/s の双方向帯域が要る。GDS なら、PCIe Gen5 スイッチ越しに SSD 8 台を GPU に直接つなげる。従来の「SSD からホストメモリへ読み、cudaMemcpy で GPU へ」という方式は、余分なコピーで CPU を使うと述べている。なお、GPU と CPU メモリの間の移動も、Teraio は残している。
実験・結果
環境は H100 NVL 2 基、SSD は Samsung 990 PRO(読み書き 6.7/6.5 GB/s)8 台、PCIe Gen5、CPU メモリ 1.5 TB。 SSD 4 台の RAID-0 を GPU 1 基に割り当て、1 基当たり約 16 GB/s。ソフトは PyTorch 2.5.0 と TorchTitan。 モデルは Llama3-8B、Llama3-70B、Granite-code-base-8B。
- ZeRO-Offload と ZeRO-Infinity に対して平均 1.47 倍、最大 1.59 倍。理想(GPU メモリ無限)に対して 80.7%(Figure 7)。
- Llama3-70B では、ZeRO-Infinity が理想の 43.0%、Teraio-Mixed が 59.7%。Teraio-Mixed は SSD とCPU メモリの両方を使う。
- Teraio-SSD(SSD のみ)は、Granite では ZeRO 系と同程度だった。
- 費用効率は、ZeRO-Offload と ZeRO-Infinity に対して 1.45 倍と 1.47 倍。GPU だけの構成に対して最大 5.41 倍安い(§4.3)。
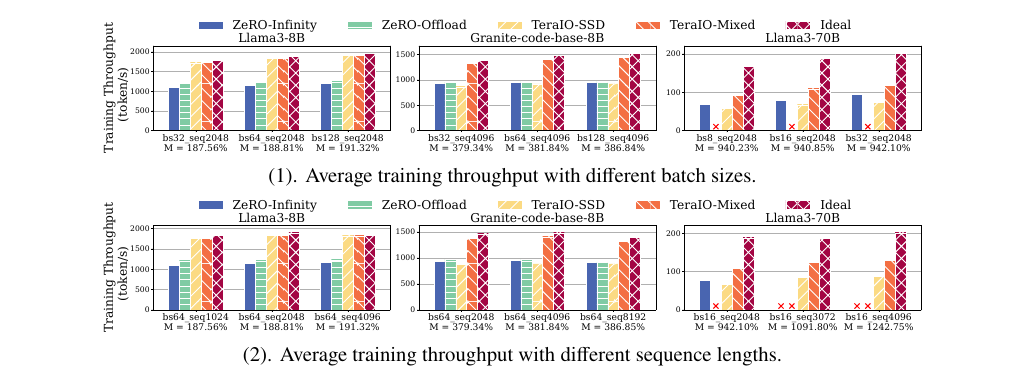
Figure 7: Llama3-8B、Granite-code-base-8B、Llama3-70B の学習スループット。(1) はバッチサイズ、(2) は系列長を変えた場合。M は GPU メモリ容量に対する学習全体の消費比。×は OOM で学習できなかった構成。
関連研究との関係と限界
- GDS の効果を単独で測った実験は無い。比較は ZeRO 系との全体比較だけで、GDS を使う場合と、ホストの CPU を経由する場合を、Teraio の中で比べる実験は、論文に見当たらない。1.47 倍の改善のうち、GDS が寄与した分は、この論文からは分からない。
- ZeRO との比較は、数値表現の違い(ZeRO は 16 ビット、TorchTitan は 32 ビット)で不公平にならないよう、著者が混合精度を切って揃えたと書いている(§4.1)。
- 保存先は、ローカルの PCIe SSD である。NFS や、ネットワーク越しのストレージは扱っていない。
- GDS が使える前提条件(対応 GPU、ファイルシステム、ドライバ)は、論文に書かれていない。
Q&A
自分のコメント
(AI による作業メモ。以下は本論文の主張ではなく、読んだ AI の推論である。)
- 「GDS を使う理由」は、マルチ GPU でホストの CPU が律速になるという設計上の動機であり、実測の裏づけは無い。単一 GPU が 1 本の NFS に書く構成には、この動機はそのまま当てはまらない。
- 退避と先読みを計算に重ねる設計なので、保存の「完了までの時間」が主題である ElasticKernel の移行とは、性能の指標が違う。