AI解説
情報源:arXiv v2(https://arxiv.org/abs/2406.08334、MLSys 2026 採録版に対応)の全文を付録まで精読。図は arXiv HTML 版から取得した。
一言で
LLM 学習のメモリ管理(ZeRO 分割、スワップ、gradient checkpointing)の設定を、プロファイルに基づくコストモデルで自動探索する学習システム。 乱立する低レベルの設定ノブを少数の構造化されたパラメータに抽象化し、実行時間とピークメモリの2つのコストモデルで全設定を解析的に評価して最適な組み合わせを選ぶ。 DeepSpeed、Colossal-AI、FSDP と比べてスループットを 1.43〜2.71 倍に改善し、A100 1枚で 75B パラメータのモデルを学習できる。 学習アルゴリズム自体は変えないため精度への影響はない。
背景・問題
LLM 学習ではパラメータ増加の 16 倍のメモリがモデル状態(fp16/fp32 パラメータ、fp16 勾配、fp32 モーメント)に必要になり、メモリが支配的なボトルネックになっている。 既存フレームワークは並列化、gradient checkpointing、テンソルスワップといった省メモリ技法を実装しているが、それぞれが低レベルの設定ノブを露出しており、手動チューニングとシステムの専門知識を要求する。
チューニングが難しい理由を、論文は2つに分けている。
第一に、技法どうしが排他的な場面がある。 活性メモリの削減では、checkpointing(再計算)とスワップ(CPU への退避)のどちらが速いかは、計算が I/O を隠せるかという実行時の動態で決まる。にもかかわらず実用システムは単純さを理由に checkpointing 一択になりがちである。
第二に、補完的な技法どうしもハードウェア資源を奪い合う。 活性のスワップとパラメータのプリフェッチは同じ CPU-GPU 帯域を使うため、スワップを有効にすると帯域が飽和してプリフェッチが止まり、計算が停止しうる。
DeepSpeed は ZeRO 分割、スワップ、checkpointing にまたがる 18 個以上の結合したパラメータを露出する。 デフォルト設定で 10B GPT-2 を RTX 3090 で学習すると GPU メモリの 35.6% しか使わず、最適化済み設定より 1.18 倍遅い。 RTX 3090 向けの設定は A100 を使い切れず、A100 向けの設定は RTX 3090 で OOM を起こすため、ハードウェアを変えるたびに再チューニングが要る。
提案手法
ProTrain は3つのコンポーネントからなる。
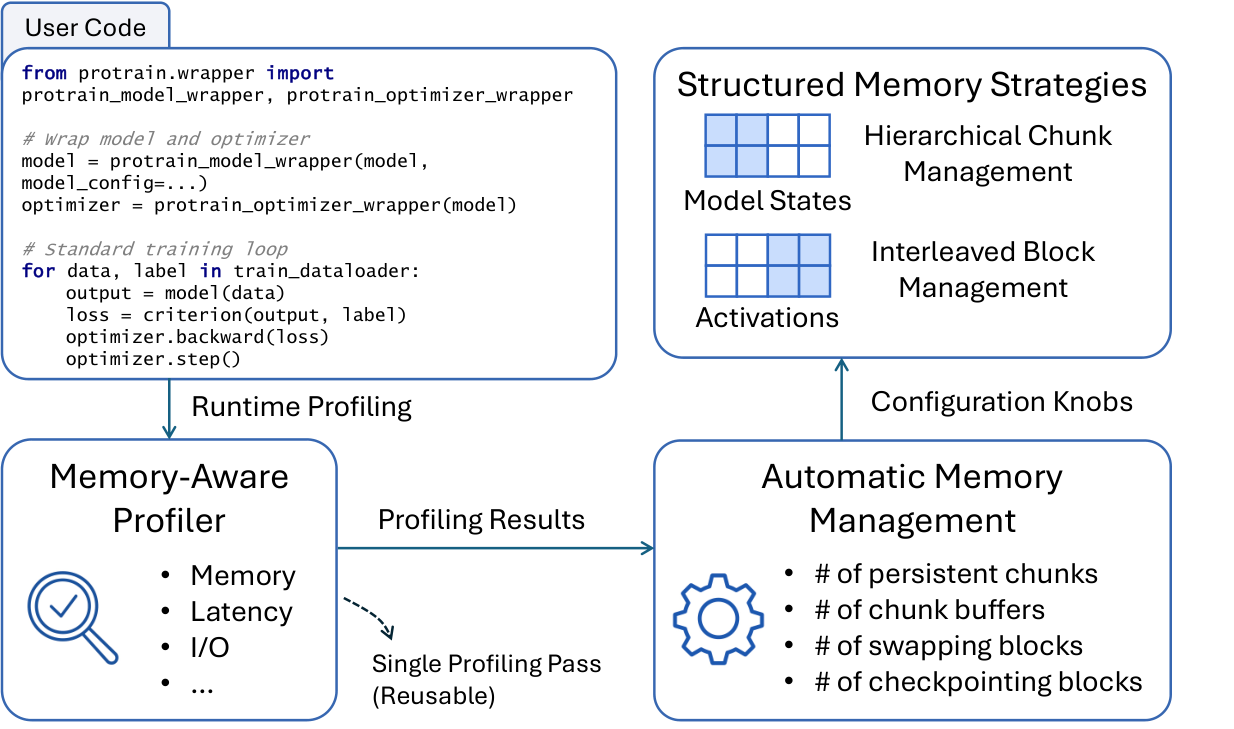
Figure 1: ProTrain のシステム概要。Structured Memory Strategies がモデル状態と活性を管理し、Memory-Aware Profiler が実行時間・メモリ・帯域を計測し、Automatic Memory Management がコストモデルで最適設定を探索する。
1. 構造化メモリ戦略(Structured Memory Strategies)
モデル状態は階層的チャンク管理で扱う。 パラメータ・勾配・オプティマイザ状態をチャンクにまとめて転送効率を上げる発想自体は先行研究(PatrickStar 系、Colossal-AI、FSDP)から借りるが、既存のチャンク方式には (1) 全モデル状態を転送するため計算と重ならない、(2) チャンクが実行順でなくモデル定義順に並びピンポンアクセスが起きる、(3) 動的確保のオーバーヘッドと断片化、という限界がある。
ProTrain はチャンク間レベルでチャンクを persistent(GPU 常駐) と non-persistent(CPU などへ退避、使用時に gather) に二分する。 これが ZeRO 分割とオフロードを統一する抽象になっており、persistent チャンク数という1つのパラメータでメモリと通信のトレードオフを調整できる。 persistent チャンクはモデルの先頭から順に割り当てる。 先頭の数層は forward ではプリフェッチを隠す時間がなく、backward では最後に処理されるため CPU 更新の遅延も隠せない、という2つの観察に基づく。 non-persistent チャンクの CPU パラメータ更新は GPU の backward 計算と重ねて実行する。
チャンク内レベルでは、モデル状態を実行順に並べてピンポンアクセスをなくし、事前確保したチャンクバッファでプリフェッチする。 バッファ不足時の追い出しも実行順に従うため、複雑な動的追い出しポリシーが要らず、実行時挙動が決定的になる。 この決定性が、後述のコストモデルの精度を支えている。
活性はブロック単位のインターリーブ管理で扱う。 既存手法は全 transformer ブロックへ一律に checkpointing をかける粗粒度か、テンソル単位の細粒度(Capuchin や Beaumont らの方式)かの二択で、前者はメモリを使い残して不必要に遅く、後者は LLM の膨大な活性テンソルで探索空間が爆発する。 ProTrain は transformer ブロックを単位とし、各ブロックにスワップ、gradient checkpointing、最適化なしの3戦略のいずれかを割り当てる。 計算グラフの再構築が不要で、既存の transformer 実装にそのまま載る。
配置には決まった形(インターリーブレイアウト)を使う。 スワップブロックを前方に置いて計算との重なりを稼ぎ、スワップと checkpointing のブロックを交互に並べて活性の滞留と OOM を防ぎ、最適化なしのブロックを後方に置いて早期に消費させ、スワップブロックのプリフェッチを間に合わせる。
補足図(AI生成):Figure 2 の再構成。8ブロックの transformer で、ブロック1・4がスワップ(青)、2・3・5・6が gradient checkpointing(橙)、7・8が最適化なし(灰)。スワップを前方、無最適化を後方に置き、交互に並べることでピークメモリを抑える。
2. メモリ認識プロファイラ(Memory-Aware Profiler)
従来の静的プロファイルや層単位のフックでは、(1) 演算子内部で生まれる一時テンソルと、(2) nn.functional.* のようにフックできない演算子のメモリを取りこぼす。
この取りこぼしは 10B GPT-2(バッチ16)でピークメモリの 17.2%(3.06 GB)に達し、OOM の原因になる。
ProTrain は演算子を単体でなくモデル実行トレースの中でプロファイルし、2種類のメモリ差分を記録する。 演算子内差分(実行中のピーク − 開始直前の確保量)が一時テンソルのスパイクを、演算子間差分(フック可能なモジュール間のピーク − 前モジュール終了時の確保量)がフック不能演算子のコストを捉える。
もう1つの問題は、70B モデルの fp16 重みだけで 140 GB になり、1 GPU でトレースを完走できないことである。 プロファイル時はテンソルを使用直前に確保し使用後すぐ解放するオンデマンド管理で走らせ、ピークを最大の単一演算子ぶんまで下げる。 その代わり実際の学習とはメモリの滞留パターンが変わるので、モデル状態と活性の寄与(サイズが固定で予測可能)は静的解析で復元する。 この「動的に測った差分+静的に復元した滞留」の合成で、任意の設定でのピークメモリを再構成する。
3. 自動メモリ管理(Automatic Memory Management)
メモリ管理を制約付き最適化として定式化する。
minimize T_iteration   s.t.  M_peak < M_capacity
configs = {n_persist, n_buffer, n_swap, n_checkpoint}
チューニング対象は、モデル状態側の persistent チャンク数 n_persist とチャンクバッファ数 n_buffer、活性側のスワップブロック数 n_swap と checkpointing ブロック数 n_checkpoint の4つに絞られる(チャンクサイズ S_chunk、チャンク数 N_chunk、ブロック数 N_block、スワップ間隔 N_interval は探索前に独立に決める)。
実行時間モデルは T_iteration = T_FWD + max{T_BWD + T_GPU_OPTIM, T_CPU_OPTIM} を基本形とし、forward/backward はチャンク単位に max(計算, 通信) を足し合わせる。
たとえば forward は T_FWD = Σ_i max(T_comp(i−1), T_prefetch(i)) で、persistent チャンク(i ≤ n_persist)のプリフェッチ時間は 0 になる。
backward には checkpointing ブロックの再計算時間 T_recomp(i) と、勾配の reduce とオフロードの通信が加わる。
帯域は固定値を仮定せず、活性スワップとプリフェッチが重なる区間では削減後の帯域を使うシミュレーションで、資源競合の複合効果を織り込む。
ピークメモリモデルは、プロファイルした演算子ごとの差分を式(8)〜(11)のとおり順に積み上げ、checkpointing ブロック先頭での再計算によるスパイクも指示関数で加算する。 最後に persistent チャンクとバッファのぶんを足し、断片化の係数 α を掛ける。
探索は全列挙にプルーニングを組み合わせる。
n_swap はスワップ間隔と帯域から実行可能な値が数個に絞られ、設定をメモリ使用量の昇順に評価して容量超過を早期に捨てる。
候補ごとに学習を実際に走らせる方式と違い、1回のプロファイルで全候補を解析的に評価できる。
実装
PyTorch 上に約 7,600 行で実装した。 モデルとオプティマイザを提供インタフェースでラップするだけで使え、学習ループは変更不要。 低レベルの工夫として、全確保を単一ストリームに統一して PyTorch アロケータのヒープ分断を避ける最適化と、2の冪への切り上げで浪費するデフォルトの pinned memory アロケータを置き換える専用アロケータを実装している。
実験・結果
RTX 3090 ×4(24 GB、PCIe 3.0、NVLink なし)と A100 ×4(80 GB、PCIe 4.0、NVLink 3.0)の2環境で、GPT-2、OPT、Mistral、LLaMA(7B〜40B、系列長 1024)を DeepSpeed(v0.12.1、ZeRO-3+オフロード)、Colossal-AI(0.3.3、Gemini プラグイン)、FSDP(PyTorch 2.0.1)と比較する。
- 最大学習可能サイズ:RTX 3090 1枚で 34B(DeepSpeed は 15B)、A100 1枚で 75B、4枚で 87B(Colossal-AI の 1.64 倍、DeepSpeed の 2.35 倍)。
- スループット:RTX 3090 ×4 で他フレームワークの 1.77〜2.71 倍、A100 ×4 で DeepSpeed 比 1.85 倍、Colossal-AI 比 1.43 倍、FSDP 比 2.22 倍。
- オフロードなしの相手にも勝つ:小さいモデルでは DeepSpeed らはオフロード無効のほうが速いが、13B LLaMA では Colossal-AI のバッチが 220→32 に落ちて逆転する。ProTrain はバッチ 228 を取り、最良の Colossal-AI 設定の 1.3 倍。
- コストモデルの精度:実行時間・ピークメモリとも予測誤差 4% 以内。プロファイルは 1 イテレーション相当(7B Mistral で 3.09 秒)、設定探索は平均 0.06 秒。
- マルチノード:16×A100(4ノード、100Gb InfiniBand)で 175B GPT を学習し、DeepSpeed の 2.58 倍、Colossal-AI の 2.09 倍。FSDP は OOM。
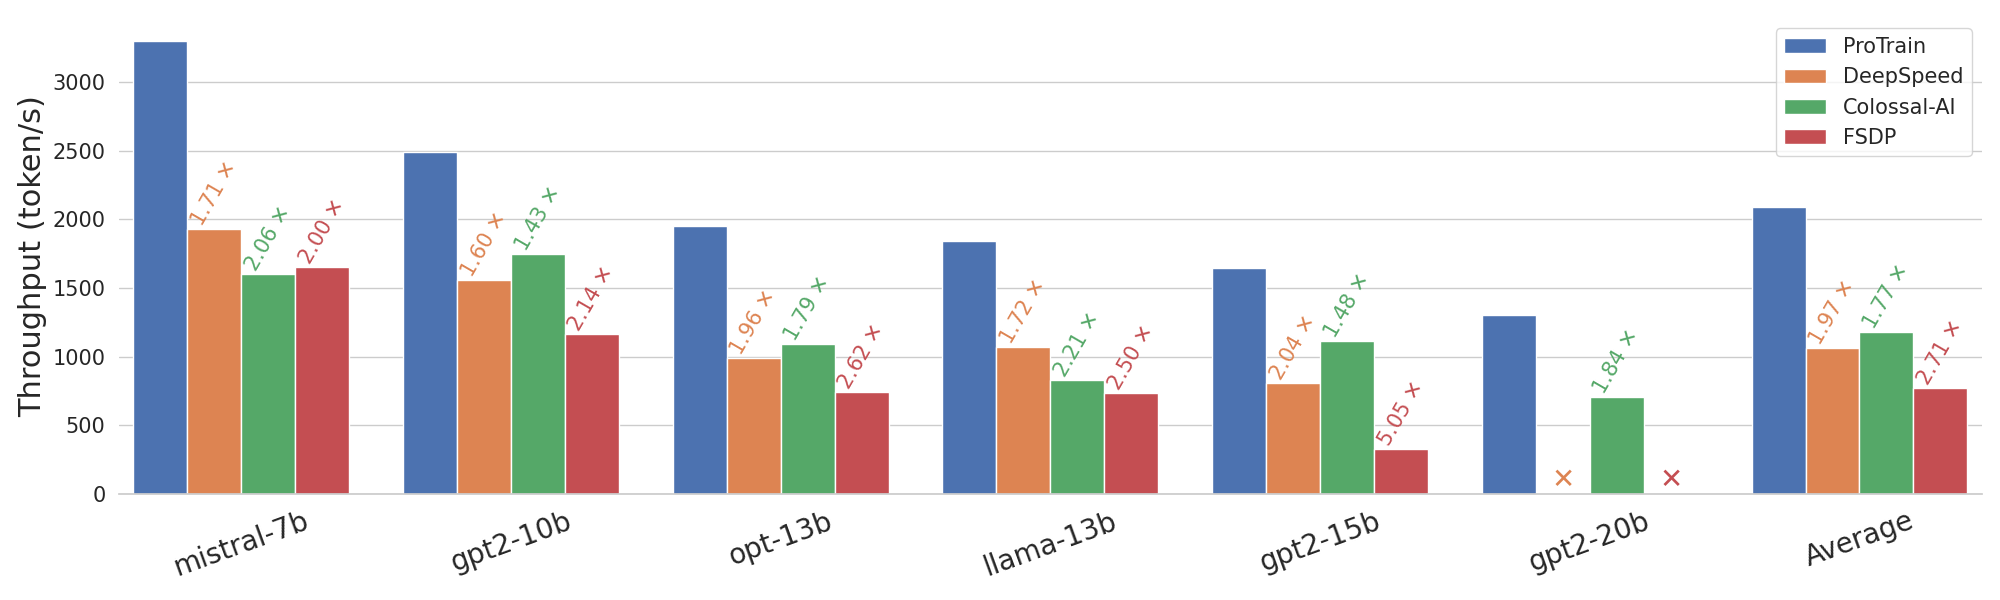
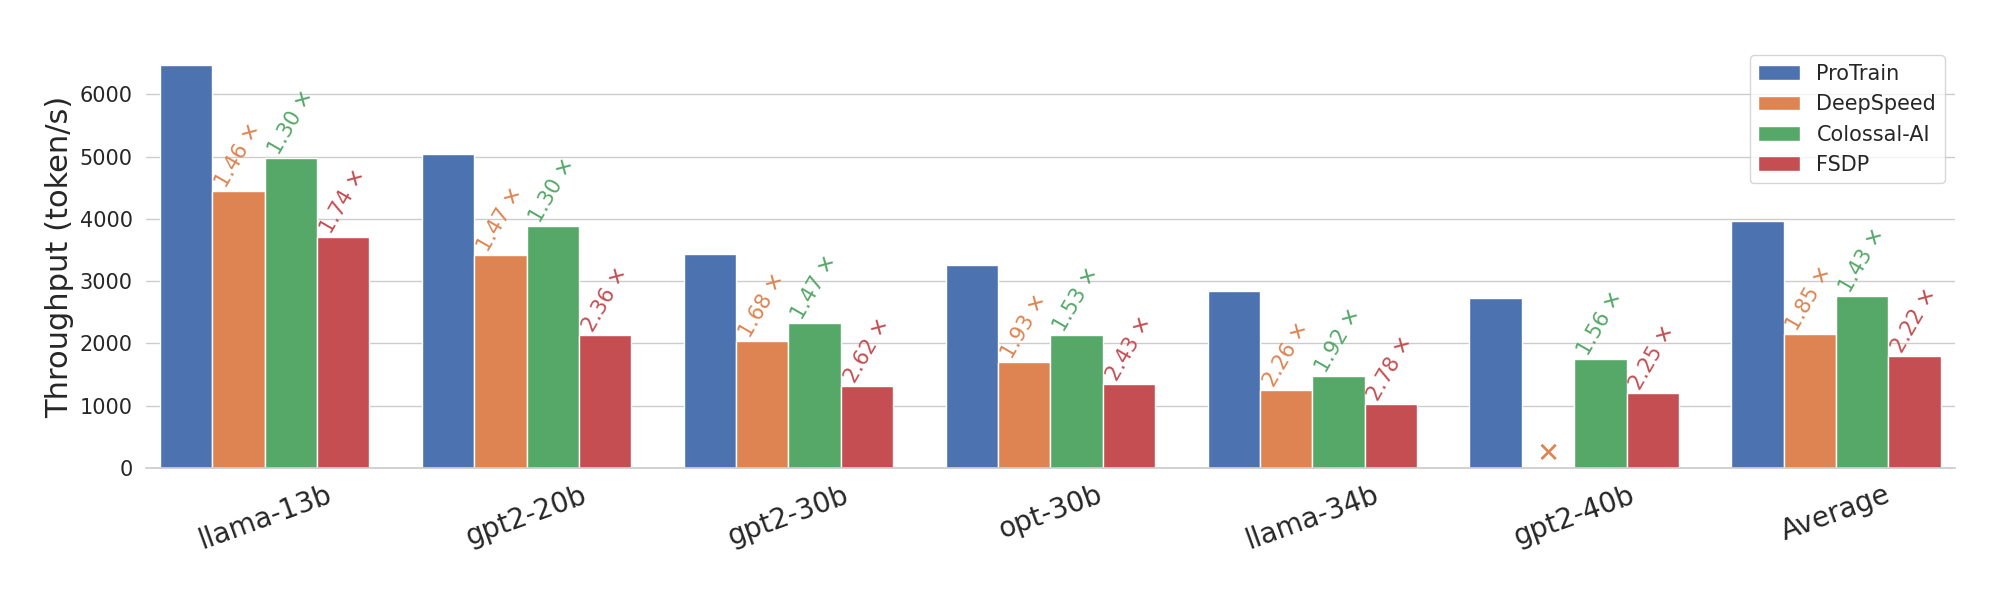
Figure 3: 4×RTX 3090(上)と 4×A100(下)での最大スループット(tokens/s)。×は OOM。
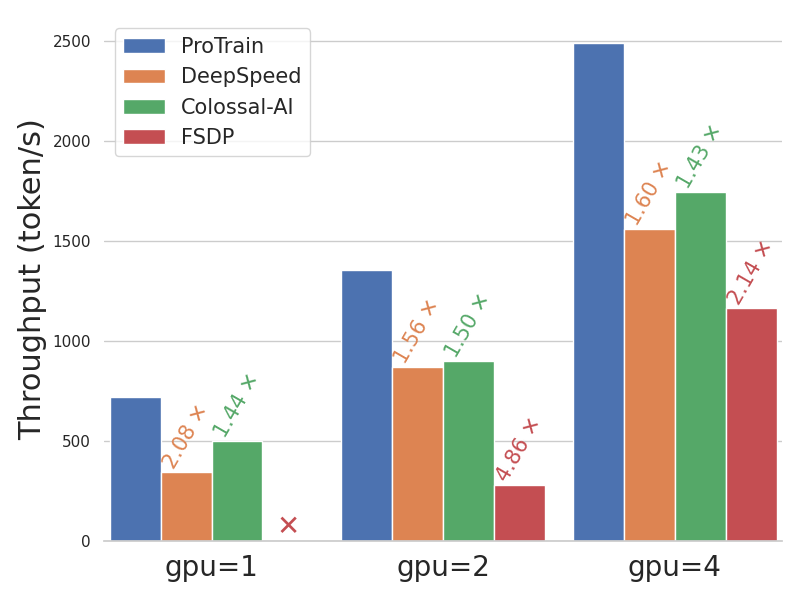
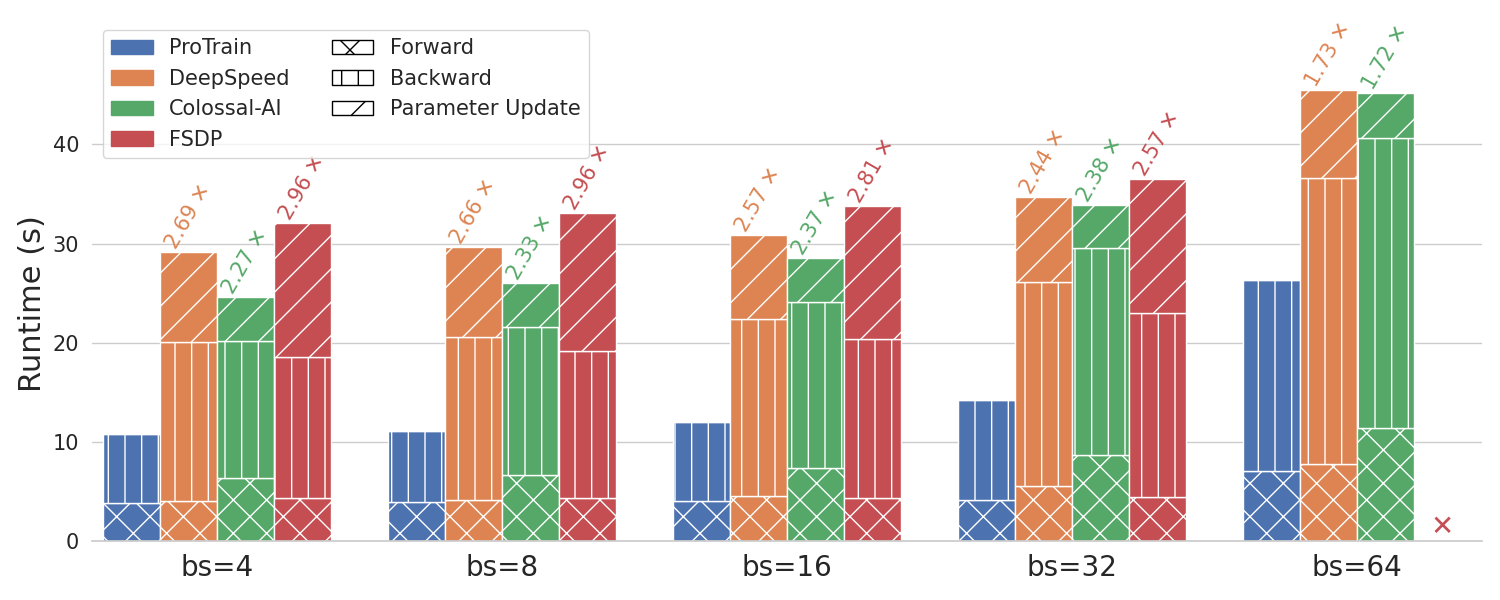
Figure 4: RTX 3090 での性能スケーラビリティ。(a) 10B GPT-2 の GPU 数別最大スループット(4枚で単枚比 3.5 倍)。(b) バッチサイズ別のステップ時間内訳。CPU パラメータ更新は backward と重なりほぼ見えない。
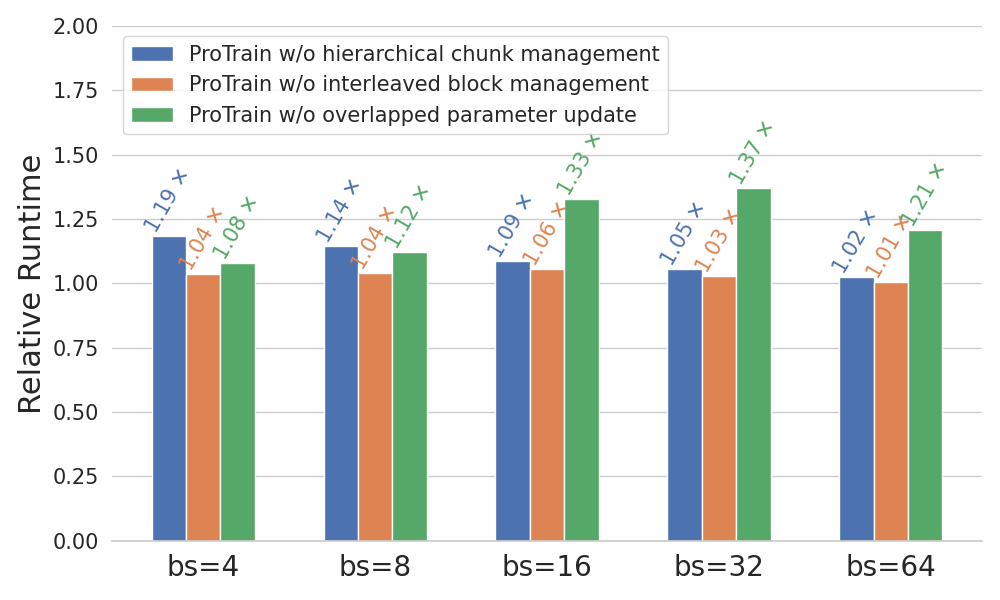
Figure 5: 各最適化を無効化したときの速度低下(10B GPT-2、4×RTX 3090)。階層的チャンク管理で 1.02〜1.19 倍、CPU 更新の重畳で平均 1.22 倍。インターリーブブロック管理は PCIe 3.0 では帯域が飽和していて平均 1.04 倍にとどまる(GH200 のような広帯域ではスワップ優位に転じ利得が大きくなる、という試算も本文にある)。
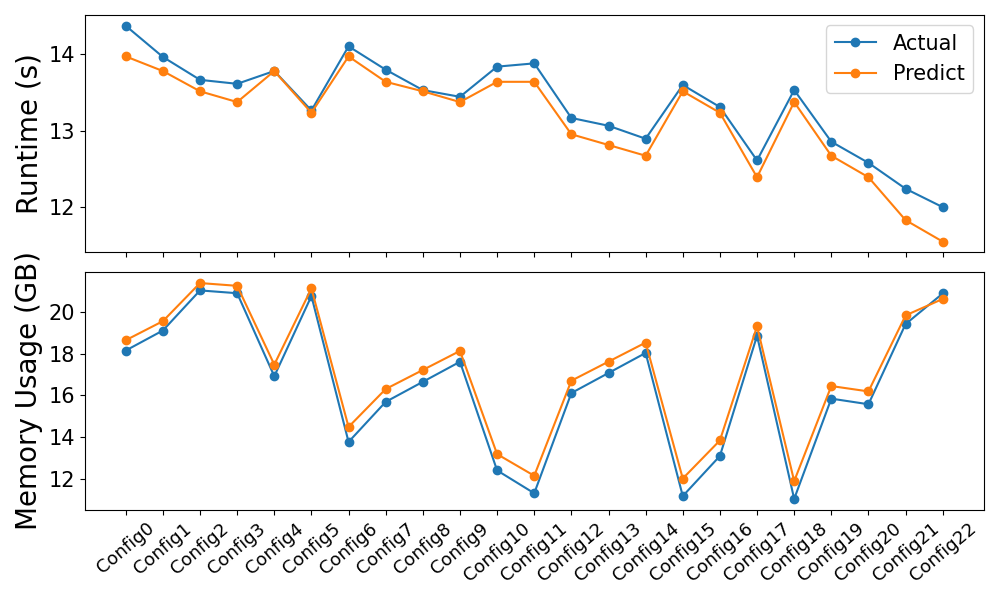
Figure 6: 設定を横断した予測実行時間・予測ピークメモリと実測値の比較(10B GPT-2)。どちらも誤差 4% 以内。
探索された設定の分析(Table 4)も示唆的で、同じモデルでもバッチサイズやハードウェアで最適解が変わる。 1B GPT-2 はバッチ8なら無最適化、バッチ64の RTX 3090 では checkpointing 24 ブロック+スワップ 2 ブロックになり、A100 なら無最適化のままでよい。 10B GPT-2 では RTX 3090 が全ブロック checkpointing(NCCL 通信がボトルネックなので、空いたメモリを persistent チャンクに回す)、A100 は NVLink のおかげで計算律速になり活性を全部保持する。 この多様性が、手動チューニングでなく自動探索が要るという主張の裏づけになっている。
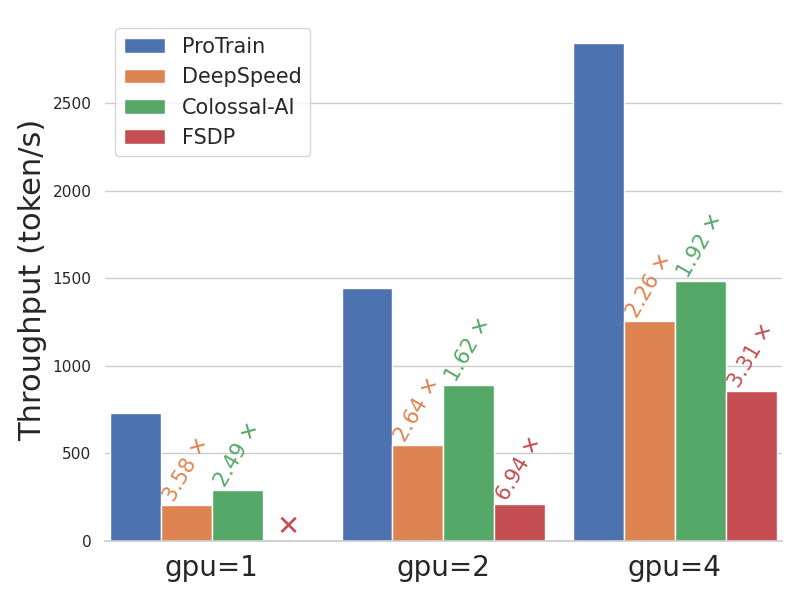
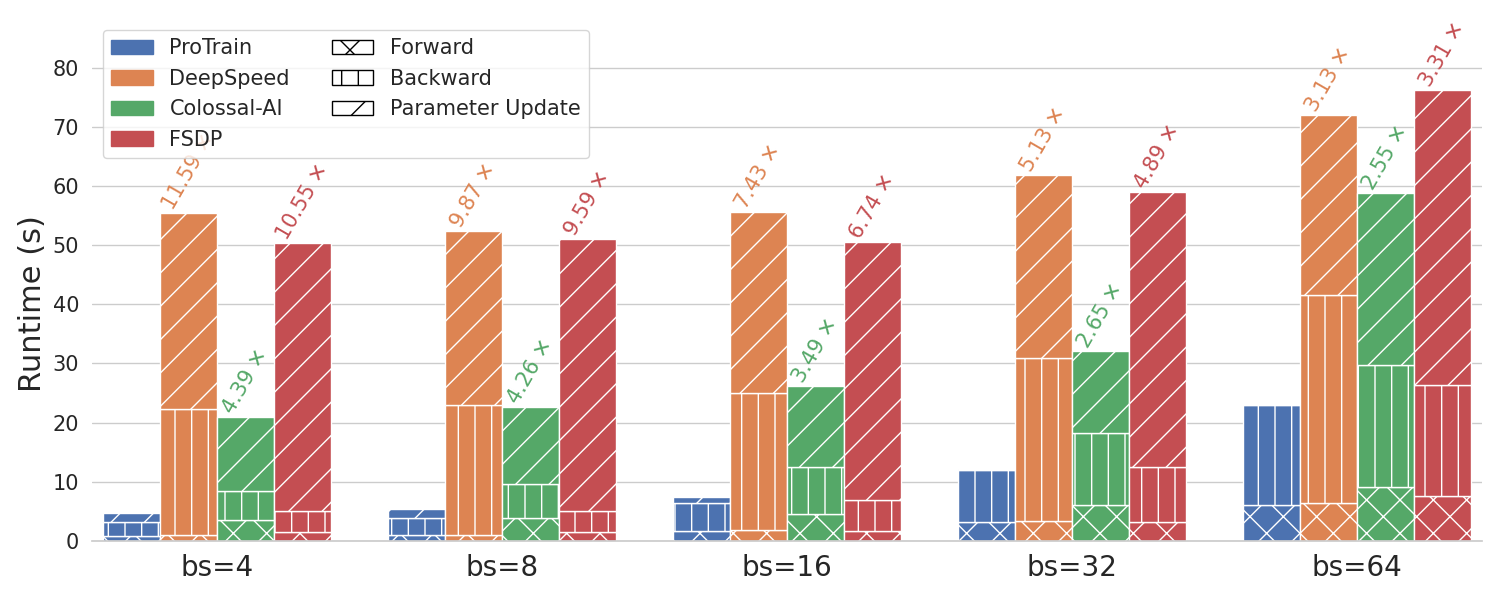
Figure 7: 4×A100 での性能スケーラビリティ。(a) 34B LLaMA の GPU 数別スループット(単枚比 2.49〜3.58 倍)。(b) バッチサイズ別のステップ時間内訳。
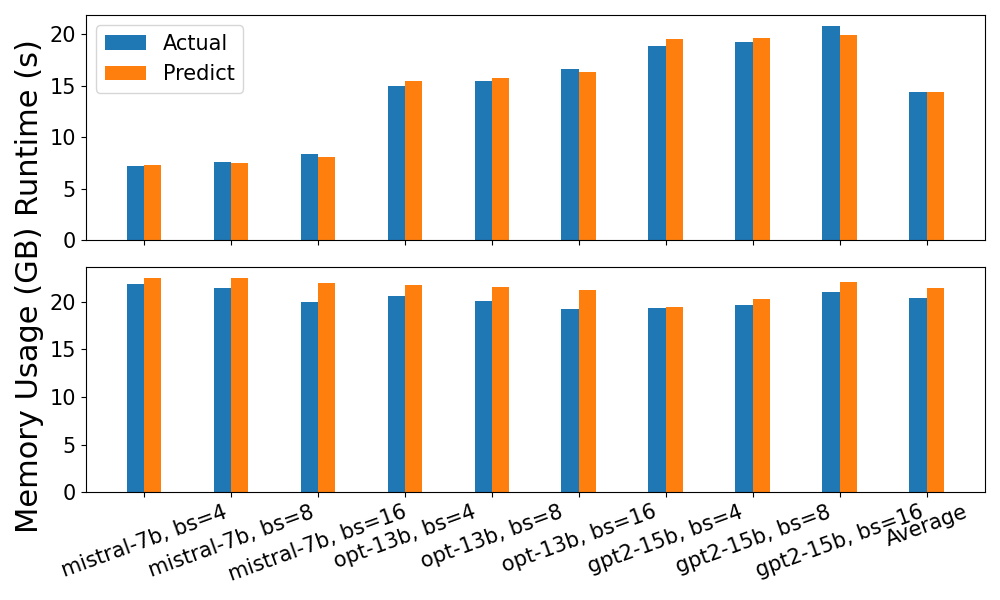
Figure 8(付録 C.2): モデル・バッチサイズを変えた場合の実行時間・ピークメモリ推定の検証。
関連研究との関係
- 粒度の選択が本研究の立ち位置を決めている。テンソル単位の細粒度管理(Capuchin、Beaumont らの POFO。Capuchin のノート参照)は LLM では探索空間が爆発し、全ブロック一律の checkpointing(Colossal-AI、DeepSpeed)はメモリを使い残す。ProTrain のブロック単位はその中間で、LLM の transformer 構造に合わせた選択である。
- ZeRO-Offload / ZeRO-Infinity(DeepSpeed)、Colossal-AI(Gemini)、FSDP は比較対象であり、チャンク管理や CPU Adam(Ren らの fast CPU Adam を利用)などの部品は共有しつつ、設定の自動化と決定的スケジューリングで差をつけている。
- Mist(Zhu ら 2025)は並列化戦略(DP/TP/PP)とメモリ最適化を同時に探索する。ProTrain は並列化を ZeRO ベースのデータ並列に固定した「狭く深い」アプローチで、その分だけ演算子レベルの精密なメモリモデルと扱いやすい探索空間を得ている。ProTrain のメモリ管理層は各ランクのローカルテンソルに閉じるため、原理的には Mist のような並列化プランナと組み合わせられると論じている。
- 本文の締めの主張は、GPU の追加ではなく余っている CPU メモリの活用でモデル容量とバッチを増やすという方向づけである。