AI解説
論文: Jing Wei, Guanyi Chen, Qi Chen, Chuyu Zhang, Zheng Zhou, Chutian Wang, Jian Zhang(ScaleX-IO、HKUST(広州))。arXiv:2610.30868v2、2026-10-23。 情報源: arXiv PDF(16 ページ)の要旨、導入、設計、実験(§4.1〜§4.3 と該当する図)、結論を読んだ。設計の細部(§2.2〜§2.6、§3)と LMCache の実験(§4.6)は、要旨と導入の記述の範囲でしか読んでいない。 図について: PDF のページを画像化して切り出した。Figure 3 と Figure 4 だけを収録している。 対象の注意: この論文は、NVIDIA の GDS(cuFile)を「ローカル NVMe SSD と GPU の間の転送」で測り、その制約を挙げて代替を提案する。チェックポイントを扱う論文ではない。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+
robots.txtで検索除けされている。
一言で
GDS は、ホストメモリを経由せずに SSD と GPU の間で PCIe の P2P DMA を行う。 ただし、各 I/O がカーネルを通る制御経路のコストは、GDS でも残る。 uGDS は、この制御経路をユーザー空間に移した cuFile 風のライブラリで、小さな I/O の遅延を下げる。 副産物として、論文は GDS 自体の挙動(初期化の遅さ、最初の I/O の遅れ、小さな I/O の弱さ)を数値で示している。
背景・問題
GDS(cuFile)は、ホストの bounce buffer を使わずに、SSD と GPU の間で直接 DMA する。 論文は、GDS に残る 3 つの制約を挙げる。
- 制御経路がカーネルを通る。各 cuFile 呼び出しが、VFS、ファイルシステム、ブロック層、カーネルの NVMe ドライバを通り、nvidia-fs が 4 KiB ごとのシャドウページを GPU バスアドレスに変換する。大きな転送では固定費が薄まるが、小さく遅延に敏感な I/O(KV キャッシュの退避、索引の参照)では支配的になる。
- ストリーム順序の I/O が高い。cuFile のストリーム順序 API は、ストリームの FIFO を引き継ぐ。単一ストリームでは、同期 16 MiB 読み出しの帯域の 40.8% しか出ない。
- ユーザー空間の I/O エンジンがクローズドソース。nvidia-fs のカーネルモジュールは公開されているが、libcufile はバイナリ配布である。
提案手法(要旨と導入の範囲)
- NVMe コマンドの生成、doorbell、完了処理を、すべてユーザー空間で行う。カーネルモジュール
ugds_drv.koは、PCI BAR のマップ、GPU ページの固定など、1 回限りの特権設定にだけ使う。 - 同期用と batch 用でハードウェアキューを分け、飛行中の DMA を数えて、SSD がアクセスしうる間はバッファを解放しない。
- cuFile 風の同期、batch、ストリーム順序の非同期 API を持ち、NVIDIA CUDA と AMD HIP の両方で動く。
実験・結果(§4.1〜§4.3)
環境は A100-SXM4-40GB、Samsung 990 PRO 1TB(PCIe Gen4 x4)、IOMMU 無効、Ubuntu 22.04、CUDA 12.4、GDS 1.9.0.20、libcufile 2.12。 §4.1 の初期化の測定では、GDS の互換モード(compatibility fallback)を無効にしている。ほかの測定での設定は、読んだ範囲では確認できなかった。いずれもローカル NVMe 1 台での測定である。
- 初期化。cuFile の driver open を含む設定が、GDS で中央値 114.56 ms、uGDS で 42.00 ms(Figure 3)。GDS では cuFileDriverOpen が 111.83 ms を占める。ここで、nvidia-fs とのセッション確立、プラットフォーム対応の確認、cufile.json の読み込み、PCIe トポロジの探索が行われる。
- 小さな同期 I/O。2 スレッド、4 KiB の書き込みで、uGDS が 1003 MiB/s、GDS が 161 MiB/s(6.23 倍)。16 スレッド、64 KiB では、書き込みが 6264 対 4542 MiB/s(1.38 倍)、読み出しが 4616 対 3855 MiB/s(1.20 倍)に縮む。論文は、要求が大きくなるほどボトルネックが SSD と PCIe に移ると述べる。
- 最初の batch の遅れ(first-use penalty)。128 KiB、batch サイズ 128 で、GDS の最初の batch が読み出し 90.84 ms、書き込み 117.65 ms かかる。64 MiB の転送全体の経過時間のうち、読み出しの 87.7%、書き込みの 92.2% が、この 1 回目である。論文は、nvidia-fs が P2P DMA のマッピングを最初の I/O で作るためと説明する(論文の推定を含む)。
- 定常状態。最初の batch を除くと、GDS は 128 KiB、batch サイズ 128 で、読み出し 3755 MiB/s、書き込み 4855 MiB/s まで回復する。
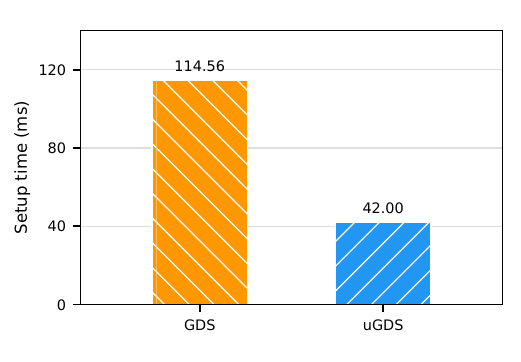
Figure 3: CUDA コンテキスト初期化後の、アプリ側のストレージ設定遅延。10 回の独立したプロセス実行の中央値(小さいほど良い)。
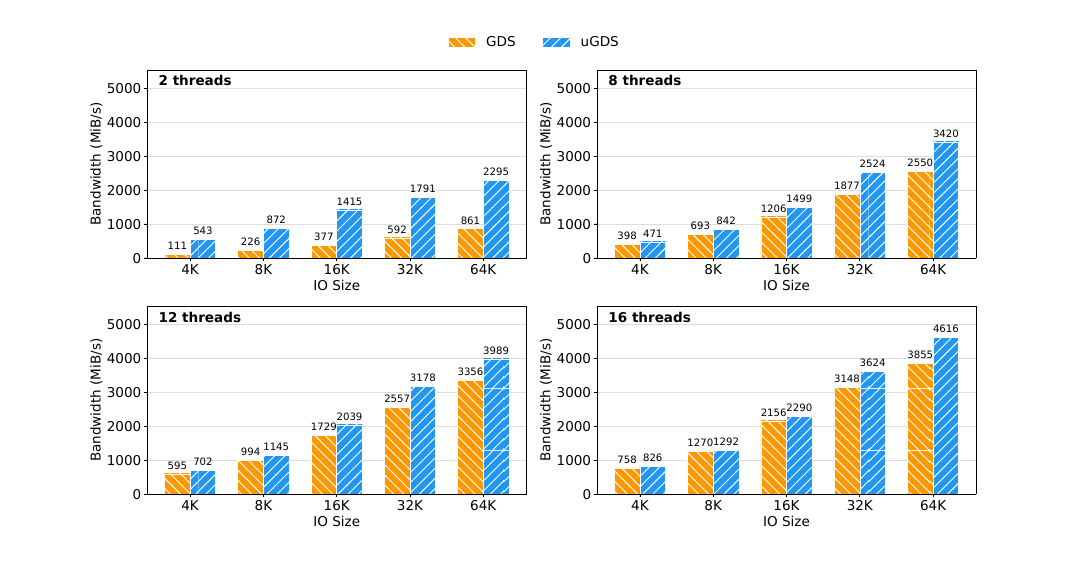
Figure 4: 2、8、12、16 スレッドで発行した同期読み出しの合計帯域。GDS と uGDS を要求サイズ(4K〜64K)ごとに比較した。
関連研究との関係と限界
- 測定は、ローカルの NVMe 1 台に限る。NFS、オブジェクトストレージ、NVMe-oF は測っていない。NVMe-oF の対応は、将来計画として書かれている。
- 要求サイズは 4〜128 KiB の範囲が中心で、チェックポイントのような数百 MiB〜GiB 級の転送は、測定の対象外である。論文自身が「大きな転送は固定費を償却する」と述べる。
- uGDS は、本稿の時点で活発に開発中のプレプリントで、査読を経ていない。
Q&A
自分のコメント
(AI による作業メモ。以下は本論文の主張ではなく、読んだ AI の推論である。)
- GDS 自体の起動コスト(約 115 ms)と最初の I/O の遅れ(約 100 ms 前後)は、保存対象が数 MiB 級で、移行が 1 回ごとのプロセスで起こる場合、無視できない大きさになりうる。ただしこの値は、特定のローカル NVMe での測定である。
- 「GDS が互換モードに落ちる条件」は、この論文には書かれていない。互換モードは、NVIDIA の資料で確認する必要がある。