AI解説
論文: Guanhua Wang, Olatunji Ruwase, Bing Xie, Yuxiong He(Microsoft DeepSpeed)。arXiv:2406.13768v1、2024-06-19。 情報源: arXiv PDF(15 ページ)の本文、図、参考文献、付録冒頭までを読んだ。付録の図 13〜15 は読んでいない。 図について: PDF のページを画像化して切り出した。Figure 1、2、5、7 だけを収録している。ほかの図は本文の数値を文章に引用するにとどめた。 GDS との関係: この論文は GPUDirect Storage を使っていない。GPU から NVMe への DMA が一般には使えないという理由を、本文に 1 文で書いている。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+
robots.txtで検索除けされている。
一言で
モデルのチェックポイントを書く時間は、データ並列でGPUを増やしても縮まないので、学習全体に占める割合が増える。 FastPersist は、NVMe 向けの書き込み最適化、データ並列ランクへの書き込みの分担、次のイテレーションとの重ね合わせの 3 つでこれを縮める。 128 基の V100 で、チェックポイントの作成が PyTorch の標準より最大 116 倍速くなり、1 イテレーションごとに保存しても 13B 以下のモデルで学習の遅延は 5% 未満になった。
背景・問題
解くべき問題
GPUを増やす(データ並列度 DP を上げる)と、計算時間はほぼ DP に反比例して縮む。 チェックポイントの時間は DP を上げても変わらない(Figure 1)。 そのため、V100 128 基までの構成で、チェックポイントが 1 イテレーションに占める割合は、密モデルで 50% から 89%、疎モデルで 82% から 96% に増える。
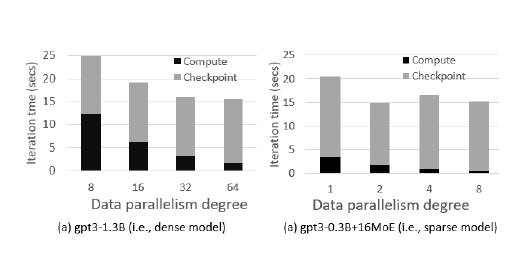
Figure 1: データ並列度が学習時間に与える影響。(a) は密モデル gpt3-1.3B、(b) は疎モデル gpt3-0.3B+16MoE。黒が計算、灰色がローカル SSD へのチェックポイント。V100-32GB を最大 128 基まで使う。
標準の torch.save() については、次の 3 点を挙げている。
- SSD 書き込みの効率が低い。5 つの GPT-3 密モデルで、ローカル SSD の理論ピーク(1 台 24.8 GB/s)に対する割合を測った(Figure 2)。gpt3-0.7b を単一 GPU で書くと、ピークの約 3% しか使えない。8 台まで増やしても、ピークの 20% 未満にとどまる。
- 書き込みの切り離しが不十分。先行研究はスナップショットを揮発性メモリに取り、永続化を非同期に回すので、中断でスナップショットを失う危険がある。また、10 や 100 イテレーションおきの低頻度を想定している。
- 復旧のコストが大きい。保存間隔が n イテレーション、GPU が m 基、1 イテレーションの時間が t のとき、平均の復旧オーバーヘッドは
n/2 * m * tと見積もられる(式 2)。n=1 のとき最小になる。
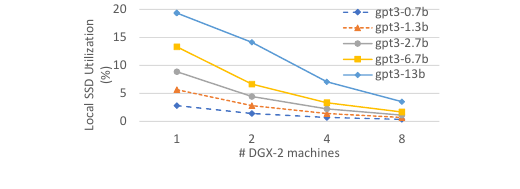
Figure 2: torch.save() による保存での、ローカル SSD の書き込み帯域利用率。横軸は DGX-2 マシン数、系列はモデルサイズ。
提案手法
1. NVMe 向けの書き込み最適化
標準のI/Oライブラリは NVMe の性能を引き出せない。 FastPersist は libaio と io_uring を使い、2 つの制約に対処する。
- メモリバッファの制約。DMA で NVMe に書くには、入力が page-locked な CPU メモリにある必要がある。論文はこの理由を、「アクセラレータと NVMe の間の DMA は、近年の進歩にもかかわらず、まだ広くは使えない」と書き、参考文献に NVIDIA の GPUDirect Storage の紹介記事([39])を挙げている。したがって、GPU メモリから page-locked な CPU メモリへ、そこから NVMe へ、という 2 段の転送になる。FastPersist はこの 2 つの転送をダブルバッファで重ね、2 つ目の転送を、1 つ目が半分終わった時点で始める(Figure 5)。
- データサイズの制約。DMA のため、入力は 512 バイトなどの境界に揃える必要がある。サイズが揃わないテンソルがあるので、データを「揃う最大の接頭部」と「揃わない接尾部」に分け、接頭部は NVMe 向けライブラリで、接尾部は通常の I/O で、同じファイルに書く。また、直列化したテンソルの列をキューに溜め、境界が揃った時点で書き出す。
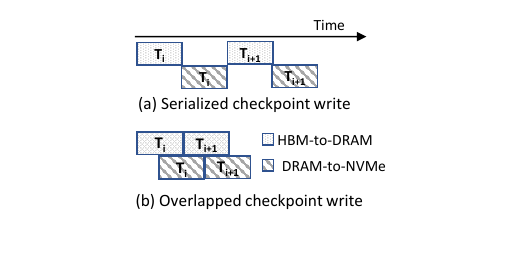
Figure 5: テンソル Ti と Ti+1 を、GPU メモリから NVMe へ書く流れ。(a) HBM→DRAM と DRAM→NVMe を直列にした場合、(b) FastPersist が DRAM をダブルバッファにして重ねた場合。
2. 書き込みのデータ並列への分担
DP のランクは同じチェックポイントを持つので、各ランクが一部だけを書けばよい。 分担は訓練開始前に決めるので、書き込み中に通信が要らない。 分担は直列化の後に、バイト単位で行う。層やテンソルの単位で分けると、層の種類で大きさが違うため、負荷が偏るからである。 全ランクで書くと、書き込みが小さくなりすぎたり、PCIe や SSD の競合が増えたりする。そのため、CPU ソケット当たり 1 つの書き手(Socket)のように、ランクの部分集合を使う選択肢も用意する。
3. 次のイテレーションとの重ね合わせ
チェックポイントは、前向き・後ろ向き計算とは依存がなく、オプティマイザとだけ依存がある。 次のイテレーションの前向き・後ろ向き計算を、チェックポイントの書き込みと並行して走らせる。 オプティマイザの更新は、書き込みが終わるまで待つ。 Python の GIL を避けるため、ランクごとに書き込み専用の別プロセスを立てる。 書き込みの別プロセスは GPU メモリを確保せず、既存のテンソルを page-locked な CPU メモリへ読むだけにする。
実験・結果
環境は DGX-2 を 8 台(V100-32GB を 16 基ずつ、計 128 基)、InfiniBand 接続。 各マシンに NVMe SSD が 8 台あり、RAID-0 で 1 ボリュームにしている。書き込みの合計ピークは 24.8 GB/s。 モデルは GPT-3 型の密モデル 0.7B〜13B と、1.8B の MoE。
単一 GPU でのマイクロベンチマーク(§5.3.1、Figure 7)
16 MB〜512 MB のテンソルを、GPU から SSD へ書く。baseline は torch.save()。
- シングルバッファで 1.8〜3.6 倍、ダブルバッファで 1.8〜6.6 倍。
- チェックポイントが大きいほど改善が大きい。
- IO バッファのサイズでも性能が変わる。512 MB のとき、最良と最悪の比は、シングルで 1.6 倍、ダブルで 2.87 倍。
- ダブルバッファが最良で、16 MB のとき 5.18 GB/s、512 MB のとき 10.9 GB/s。
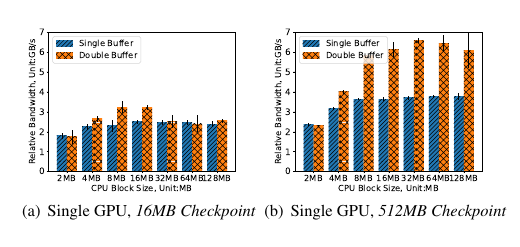
Figure 7: 単一 GPU で、IO バッファのサイズを変えた場合の、baseline に対する相対帯域。(a) 16 MB、(b) 512 MB のチェックポイント。
密モデルの学習(§5.4)
- 128 基で、チェックポイント作成が baseline の 28 倍(gpt3-13B)から 116 倍(gpt3-0.7B)。
- 書き込みは最大 146 GB/s(gpt3-13B、論文の主張では 8 ノードの理論ピークの 80%)。
- 1 イテレーションごとに保存する学習全体で、1.6 倍(gpt3-13B)から 21.8 倍(gpt3-0.7B)の高速化。
- 書き込みの重ね合わせにより、1.3B〜13B で、1 イテレーションごとの保存でも遅延が 5% 未満(§5.6.2)。
関連研究との関係
- 先行の Check-n-run と CheckFreq は、スナップショットを CPU メモリに取って、永続化を非同期に行う。FastPersist は永続化まで 1 イテレーションの中で同期的に行い、その書き込みを次の計算と重ねる。
- GPU から NVMe への DMA(GPUDirect Storage など)は、本論文では使わない。理由は上記の 1 文だけで、GDS との性能比較はしていない。
限界(論文の記述)
- 分担は、訓練開始前に固定する前提である。パラメータの凍結や故障でモデルが変わる場合は、再計算が要る。
- 書き込み先は、ローカルの NVMe SSD である。NFS やオブジェクトストレージは扱っていない。
- 測定は V100 世代の DGX-2 に限る。
Q&A
自分のコメント
(AI による作業メモ。以下は本論文の主張ではなく、読んだ AI の推論である。)
- GDS の議論との関係では、この論文は「GPU から page-locked なホストメモリへのコピーを、書き込みと重ねれば、書き込みの上限は SSD 側で決まる」ことを示す側の証拠になりうる。ただし GDS 経由との直接比較はなく、D2H のコピー時間の内訳も報告されていない。
- 保存先がローカル NVMe の 24.8 GB/s の環境なので、ネットワーク越しの NFS に当てはめるには、別の根拠が要る。