AI解説
arXiv: https://arxiv.org/abs/1912.09256(v1, 2019-12-19, cs.PF, 12 ページ+参考文献 3 ページ) 情報源: arXiv PDF の全文(本文・図・表・参考文献)を精読した。付録は無い。
venueとyearの「NSDI ‘20」は、このノートの依頼元から伝えられた情報である。論文本文と arXiv の掲載ページには会議名が書かれておらず、原本では未確認。 図について: 原論文の Figure 1〜19 をすべて PDF から切り出して置いた(figures/fig*.png)。AI 生成の補足図は付けていない。 図番号とキャプションは原論文に対応する。図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+robots.txtで検索除けされている。 対象の注意: この論文が測っているのはネットワーク帯域とレイテンシであり、ディスクや NFS の入出力ではない。
一言で
クラウドのネットワーク帯域は、事業者の QoS 機構のせいで、使い方(送信パターンと、それまでの送信履歴)によって変わる。 EC2 の c5.xlarge は、帯域を約 10 Gbps で出し続けられるのは連続送信の最初の約 10 分で、その後は約 1 Gbps に絞られる(トークンバケット)。 短い測定だけでは、この絞り込み後の帯域を見落とす。 さらにトークンバケットは過去の送信量に依存するため、実験を繰り返すほど次の実験の初期状態が変わり、繰り返し回数を増やしても信頼区間が狭まらない場合がある。 著者らは、論文の主張として、実験前にマイクロベンチマークで事業者の帯域ポリシー(トークンバケットの有無とパラメータ)を測り、結果と一緒に報告することを勧めている。
背景・問題
解くべき問題
クラウド上の性能は揺らぐことが知られている。 それでも論文は、システム系のトップ会議の実験はこの揺らぎをほぼ無視していると主張する。 著者らは 2008〜2018 年の NSDI・OSDI・SOSP・SC の論文 1,867 本から、キーワードで 138 本、手作業でクラウド実験を含む 44 本(NSDI 15、OSDI 7、SOSP 7、SC 15)を選んだ(Table 1, 2)。 2 人の査読者が独立に分類し、Cohen’s Kappa は 0.95 / 0.81 / 0.85 だった。
結果は次のとおりである(Figure 1, Finding 2.1〜2.3)。
- 60% 超の論文は、繰り返し回数または報告する統計量(平均か中央値か)を書いていない(severely under-specified)。
- 平均または中央値を報告する論文のうち、分散や信頼区間まで報告するのは 37% にとどまる。
- 繰り返し回数を明記した論文の多くは 3、5、10 回で、76% は 15 回以下である。
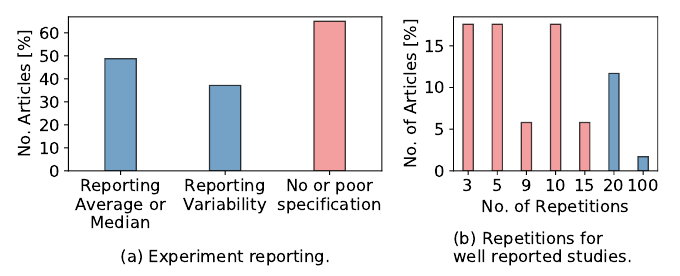
Figure 1: クラウド実験を含むビッグデータ論文の実態。(a) 実験について報告している項目(互いに排他でないので合計は 100% を超えうる)。(b) 仕様が明確な論文の繰り返し回数。
論文が扱うもう一つの問題は、ネットワークの揺らぎがアプリケーションの性能評価に与える影響が、体系的に調べられていないことである。 クラウド事業者は SDN によって VM 間のフローに予測可能な性能を約束している。 しかし論文は、実際にはその帯域が安定していないと報告する。
課題
著者らが取り組む課題は次の 4 つである(論文の貢献 1〜4)。
- 文献調査で、揺らぎの無視を定量化する(Section 2)。
- 商用クラウド 2 つと私設研究クラウド 1 つで帯域と RTT を測り、揺らぎの量と原因を特定する(Section 3)。
- 低レベルの揺らぎが、Spark のアプリケーション性能の再現性と、統計手法の前提(独立同分布)に与える影響を示す(Section 4)。
- 再現性のある実験のための指針を示す(Section 5)。
指標の定義
論文が使う指標を先に整理する。 これらはすべてネットワークに対するもので、ディスク I/O には適用していない。
- 帯域:VM 対のあいだで測った TCP スループット。10 秒ごとの平均を 1 点とする(Figure 4〜6 のキャプション)。
- CV(変動係数):Figure 6 の棒グラフに使われている。論文は CV の式を書いていない。
- 測定間の変動:連続する 10 秒測定どうしの帯域の差。HPCCloud の full-speed で最大 33%、Google Cloud の 5-30 で最大 114%(Section 3.1)。
- RTT:アプリケーションから見た TCP の往復遅延。
tcpdumpでパケットヘッダを取り、wiresharkで、TCP セグメントを(仮想)デバイスへ送った時刻と ACK が戻った時刻の差を求める(Section 3.2)。 - 95% 非パラメトリック信頼区間:中央値と 90 パーセンタイルに対して使う。繰り返し回数が少ない実験の推定値が、繰り返し 50 回の「ゴールドスタンダード」の信頼区間に入るかで正確さを判定する(Section 2.1)。
- CONFIRM:Maricq らの手法。目標の信頼区間の幅に達するまでに必要な繰り返し回数を見積もる(Section 4.1)。
測定の設計
測定対象のクラウド
測定は Amazon EC2(us-east)、Google Cloud(us-east)、私設研究クラウド HPCCloud の 3 つで行った。 期間は 2018 年 10 月から 2019 年 2 月で、合計 21 週間以上のほぼ連続した転送、100 万点超のデータ点、9 PB 超の転送量になる。 RTT のデータは 2019 年 8〜9 月に取り、5,000 万点超ある。 本文で詳しく扱うのは、EC2 の c5.xlarge、Google の 8 コア、HPCCloud の 8 コアの 3 実験である(Table 3)。
送信パターン
各 VM 対について、次の 3 パターンを 1 週間連続で測った(Section 3.1)。
- full-speed:データを連続で送り、10 秒ごとに集計する。長時間の批処理やストリーミングを想定する。
- 10-30:10 秒送り、30 秒休む。
- 5-30:5 秒送り、30 秒休む。
後ろの 2 つは、TPC-H や TPC-DS のような短い分析クエリの通信パターンを想定している。
帯域の揺らぎの結果
HPCCloud(QoS なし)
帯域は 7.7〜10.4 Gbps のあいだで大きく揺れる(Figure 4)。 測定間の変動は最大 33% である。 論文は、小規模な私設クラウドは統計的多重化が効かず、競合トラフィックが来たときに平滑化されにくいと述べる(F3.2)。
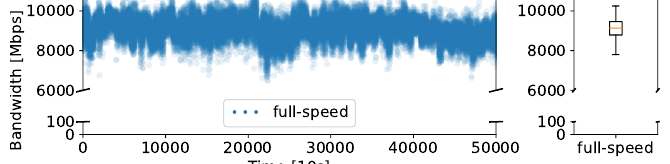
Figure 4: HPCCloud の帯域。左は 1 週間分の時系列(1 点が 10 秒平均)、右は IQR の箱ひげ図(ひげは 1 と 99 パーセンタイル)。
Google Cloud(コアごとの QoS)
測定値は事業者が宣言する QoS 付近に収まる。 帯域は 13〜15.8 Gbps の範囲で、アクセスパターンへの依存が大きい。 長い送信(full-speed)は帯域が高く安定し、5-30 は裾が長い(Figure 5)。 論文は、アイドルのフローが専用ゲートウェイを通る設計によるのかもしれないと述べるが、確認はしていない。 Google Cloud では TCP 再送が実験あたり約 2% 発生する(Figure 9)。
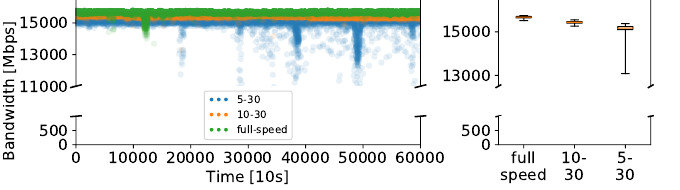
Figure 5: Google Cloud の帯域。左は 1 週間の時系列、右は IQR 箱ひげ図(ひげは 1 と 99 パーセンタイル)。
Amazon EC2(トークンバケット)
EC2 は Google と逆で、重い送信ほど帯域が低く、揺らぎも大きい(Figure 6)。 論文は、10-30 と 5-30 が full-speed に対しておよそ 3 倍と 7 倍の差を持つと書く。 帯域は 1〜10 Gbps のあいだで動く。
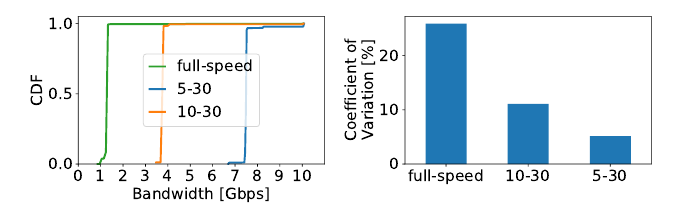
Figure 6: EC2 の帯域。左は経験的 CDF、右は変動係数の棒グラフ。期間は 1 週間で、1 点が 10 秒平均。
原因はトークンバケットである。 Figure 10 によると、EC2 では 3 パターンの総転送量がほぼ等しい。 Google Cloud では full-speed の総転送量が間欠的なパターンより桁違いに多い。 著者らはこの違いと Figure 7 の細かい測定、他の先行研究から、EC2 がトークンバケットで帯域を割り当てていると結論した。
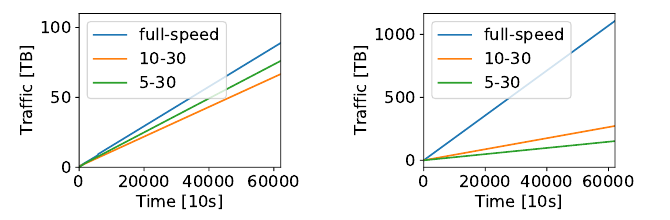
Figure 10: 3 パターンの実験で VM 対が 1 週間に転送した総量。(a) は EC2、(b) は Google Cloud。
トークンバケットの動作とパラメータ
論文の説明は次のとおり(Section 3.3)。
- VM には、割り当て時点で一定量のトークン(予算)が入ったバケットが付く。
- 予算が残っているあいだは高い帯域(c5.xlarge で 10 Gbps)で送れる。
- 予算が尽きると低い帯域(c5.xlarge で 1 Gbps)に制限される。連続送信を約 10 分続けると、この状態になる。
- 補充速度は約 1 Gbit のトークン/秒と実験的に求めた。つまり毎秒、高い帯域で 1 Gbit 送れる分のトークンが戻る。
- 空になった後の制限帯域での送信は、バケットが再び満ちない程度の量なので、バケットを満たすには送信を止めて数分休む必要がある。
Figure 7 は、c5.xlarge の 10 秒間の TCP 送信 2 例を示す。 上段は通常の挙動(帯域は 10 Gbps 付近で一定)、下段はトークンが尽きた後で、帯域が約 1 Gbps に落ち、RTT が約 2 桁増える。 RTT の増加について論文は、仮想デバイスドライバ内の大きなキューを示唆すると述べる。 なお Figure 7 自体は 10 秒間の切り出しで、約 10 分で切り替わる様子を時間軸で示した図ではない。 約 10 分という値は本文の記述である。 バケットが空になるまでの時間は Figure 11 に、c5.large から c5.4xlarge まで 15 回ずつの測定として箱ひげ図で示されている。
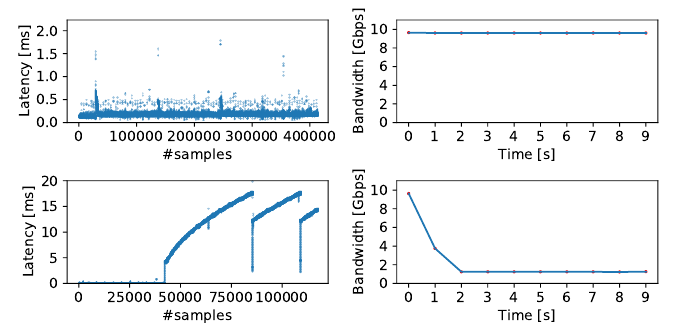
Figure 7: c5.xlarge の 10 秒間の TCP 送信での RTT(左)と iperf の帯域(右)。上は通常の挙動、下は帯域が落ちたときの挙動。
VM のサイズが大きいほど、バケットの大きさと制限後の帯域は比例して大きくなる。 ただし、同じインスタンスタイプでもこれらの値は一定でない(Figure 11 の箱の広がりと高帯域側の誤差棒)。 さらに論文は、2019 年 8 月より前は割り当てた c5.xlarge がすべて 10 Gbps で送れる仮想 NIC を持っていたが、8 月以降は 5 Gbps に制限された仮想 NIC が一貫せずに割り当てられた、と報告する。 原因が一時的な混雑か恒久的な方針変更かは、論文でも分からないとされている。
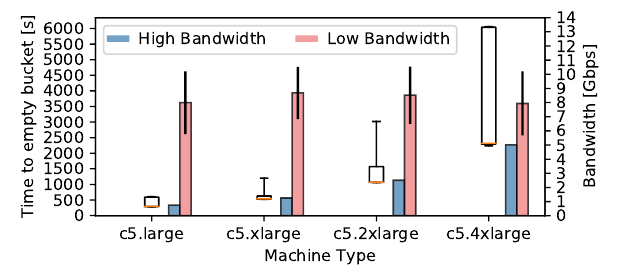
Figure 11: EC2 の c5.* の複数インスタンスで求めたトークンバケットのパラメータ。バケットを空にするまでの時間は箱ひげ図(左軸)、高帯域と低帯域は棒グラフ(右軸)。
レイテンシと仮想 NIC
RTT は Google Cloud で ms オーダー(上限 10 ms)、EC2 で通常サブミリ秒である(Section 3.2)。 EC2 はトークンが尽きて帯域が絞られた時点で、RTT が約 2 桁上がる(Figure 7, 8)。
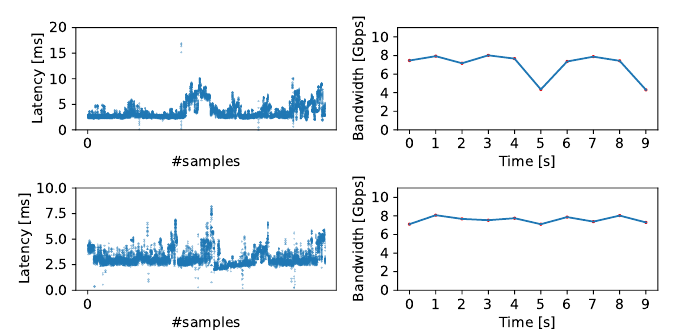
Figure 8: Google Cloud の 4 コアインスタンスでの 10 秒間の TCP 送信における RTT(左)と iperf の帯域(右)。
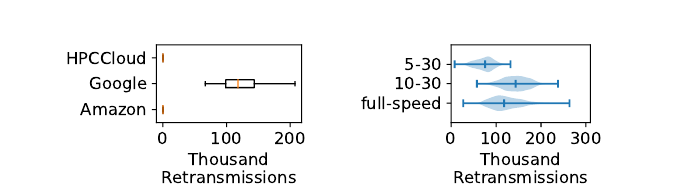
Figure 9: 全実験の TCP 再送数。左は IQR 箱ひげ図、右は Google Cloud の再送のバイオリン図。
仮想 NIC の実装差も効く。
EC2 は MTU 9000 のジャンボフレームを使い、GCE は MTU 1500 で TSO(TCP Segmentation Offloading)を使う。
そのため、アプリケーションの write() サイズが RTT と再送に効く(Figure 12)。
GCE で write() を 9 KB に制限すると、再送はほぼゼロ、平均 RTT は約 2.3 ms だった。
既定の 128 KB では再送が数十万件に達し、RTT は最大 10 ms だった。
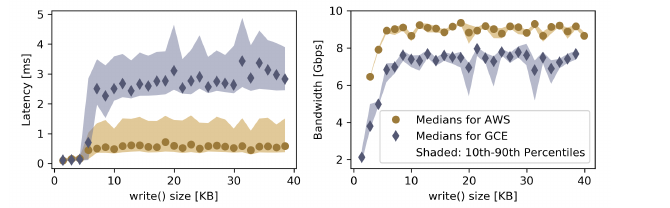
Figure 12: EC2(c5.xlarge)と GCE(広告 8 Gbps の 4 コア VM)で測った、write() サイズに対する RTT と帯域。
アプリケーション性能への影響
繰り返し回数が少ないと何が起きるか(エミュレーション)
Ballani らの先行研究にある 8 つのクラウド(A〜H)の帯域分布(Figure 2)を、Spark の 16 台の私設クラスタで再現した。 各マシンの帯域を、その分布から 5 秒または 50 秒ごとに一様サンプリングして制限した。 50 回繰り返しをゴールドスタンダードにして、3 回と 10 回の実験の中央値を比べた。
HiBench K-Means では、3 回の中央値が 50 回の 95% 信頼区間から外れたのは 8 分布中 6(75%)、10 回では 3(38%)だった。 TPC-DS Q68 の 90 パーセンタイルは、さらに推定が難しい(Figure 3)。 Figure 2 の分布は四分位しか与えず、サンプル間の自己共分散が分からないため、一様サンプリングを仮定している、と論文は断っている。
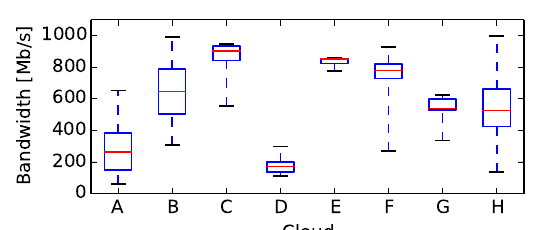
Figure 2: 8 つの実クラウドの帯域分布(Ballani らの研究から導出)。箱ひげ図は 1, 25, 50, 75, 99 パーセンタイル。
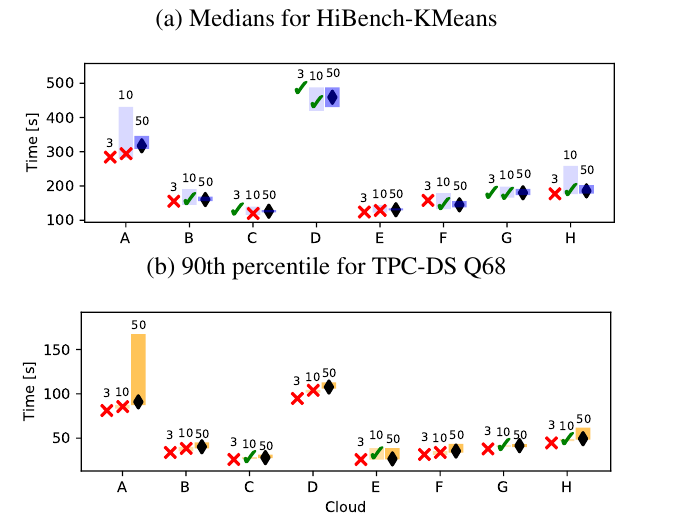
Figure 3: K-Means(a)と TPC-DS Q68(b)の中央値と 90 パーセンタイル。95% 信頼区間つき。◇ が 50 回の推定値で、3 回と 10 回の推定値は 50 回の信頼区間内なら ✓、外なら ×。
確率的な揺らぎなら繰り返しで抑えられる
Google Cloud と HPCCloud の揺らぎは、隣接テナントなどによる確率的な雑音に近い。 この場合は CONFIRM で、必要な繰り返し回数を見積もれる。 2 つの代表的なベンチマークで、中央値の 1% 以内に 95% 信頼区間を収めるには 70 回以上かかった(Figure 13)。 文献の多くの実験は、この図の左端にあたる回数で止まっている。
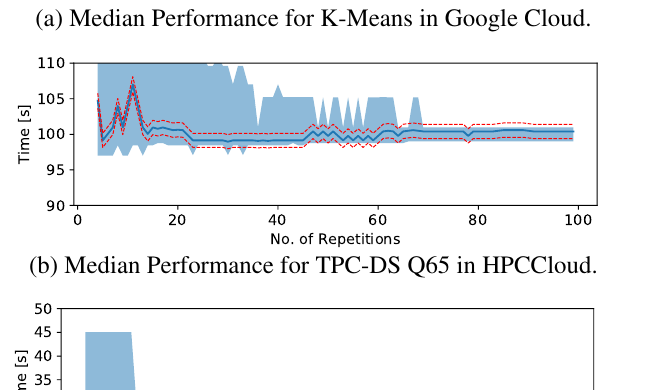
Figure 13: Google Cloud の K-Means と HPCCloud の TPC-DS Q65 の CONFIRM 解析。中央値の推定値(青太線)、95% 非パラメトリック信頼区間(薄青)、1% の誤差境界(赤点線)。縦軸は 0 から始まらない。
トークンバケットは繰り返しの前提を壊す
EC2 のトークンバケットは確率的な雑音ではない。
予算が過去の送信履歴で決まるので、あるアプリケーションの実行が、後続のアプリケーションの実行時間を変える。
著者らは、EC2 上で直接アプリケーションを動かさずに、tc によるエミュレータを作って検証した。
理由は、実クラウドでは CPU など他の揺らぎとネットワークの揺らぎを分離できないからである。
Figure 14 で、エミュレーションが実 EC2 の挙動(高帯域から低帯域への切り替わり)に近いことを確認している。
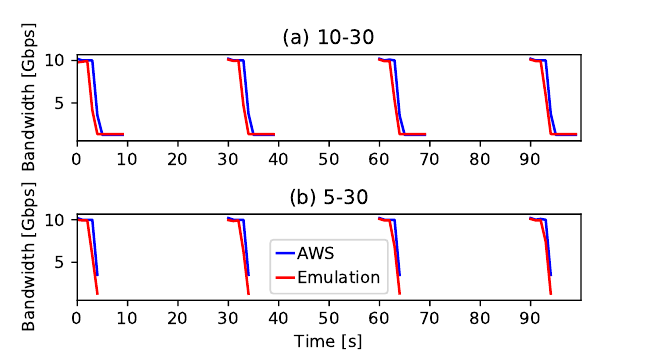
Figure 14: EC2 のトークンバケットのエミュレーションの検証。AWS(青)とエミュレーション(赤)の曲線が似ており、エミュレーションの品質が高いことを示す。
実験は 12 ノード(16 コア、64 GB、SSD、FDR InfiniBand)の私設クラスタで、c5.xlarge 相当(高 10 Gbps、低 1 Gbps)を再現して行った。 HiBench と TPC-DS を各設定で 10 回以上動かし、初期予算を 10 / 100 / 1000 / 5000 Gbit に変えた(Table 4)。
初期予算が小さいほど、ネットワーク利用の変動が大きい(Figure 15)。 ネットワーク負荷の高いアプリ(TS、WC)では、初期予算の違いが性能に 25〜50% の影響を与える(Figure 16)。 TPC-DS でも、すべてのクエリで予算が大きいほど速く、ネットワーク需要の高いクエリほど予算への感度とばらつきが大きい(Figure 17)。
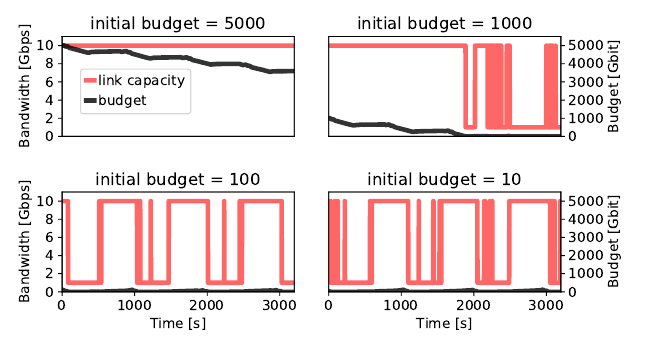
Figure 15: Terasort をトークンバケット上で動かしたときのリンク容量(左軸)とバケットの予算(右軸)。アプリの転送で予算が減る。
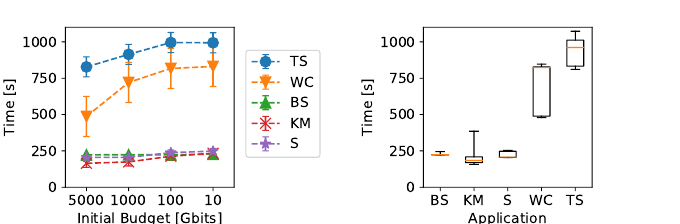
Figure 16: トークンバケットの予算の違いによる HiBench の平均実行時間(左)とばらつき(右、IQR 箱ひげ図)。ネットワーク依存の高いアプリほど影響が大きい。
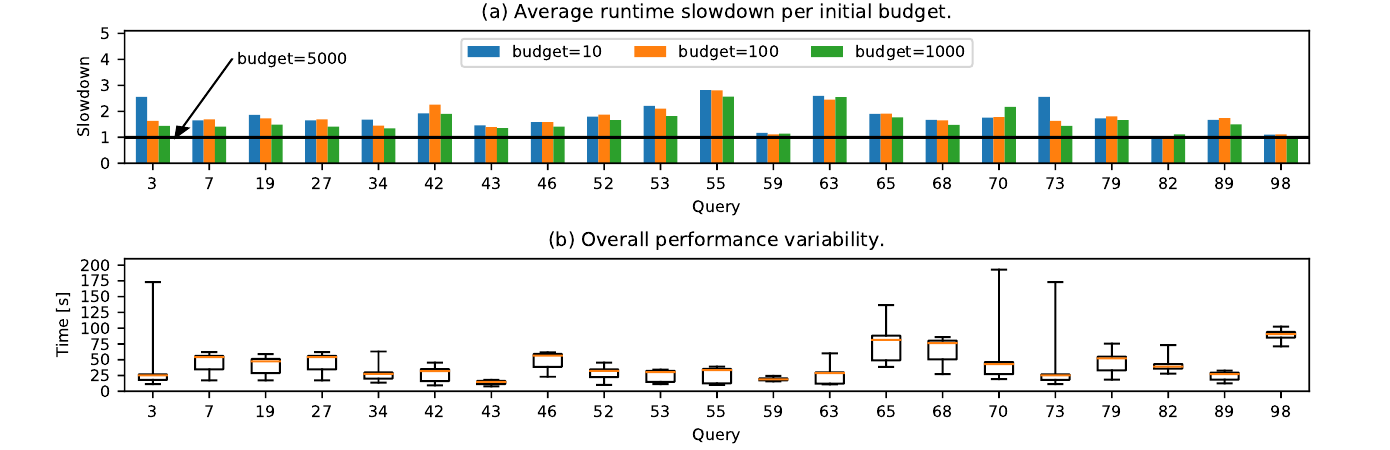
Figure 17: TPC-DS のクエリごとの平均実行時間の遅れ(上、予算 5000 Gbit を基準)と、全予算にわたる性能のばらつき(下)。
予算の状態によっては、1 ノードだけ予算が尽きて 10 Gbps と 1 Gbps を短い周期で行き来し、全体を遅らせるストラグラーになる(Figure 18、初期予算 2500 Gbit、TPC-DS)。 VM ごとにバケットが別で、残りの予算は過去の実行の関数であり、定数も一定でないので、新しい VM の組以外は現在の予算を見積もりにくい、と論文は述べる。
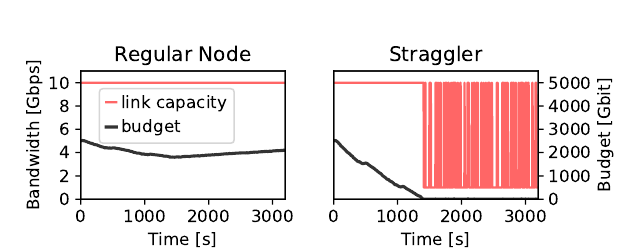
Figure 18: 初期予算 2500 Gbit の TPC-DS でのリンク容量の割り当て。左は通常ノード、右はストラグラー。
繰り返すほど信頼区間が広がる
初期予算を繰り返しごとに減らしながら(連続実験で前の実行が次の予算を減らす状況の再現)、2 つの TPC-DS クエリの中央値と信頼区間を比べた(Figure 19)。
- Query 82 は予算に鈍感で、繰り返しが増えると信頼区間が普通に狭まる。
- Query 65 は予算に強く依存し、繰り返しで予算が枯れると実行時間が伸び、最初の推定が外れる。信頼区間は繰り返しが増えても広がる。
原因は、トークンバケットが「各実験は独立」という前提を壊すことにある。 TPC-DS の全クエリのうち 80% が Query 65 と同じ影響を受け、予算を使い切るまでに中央値の推定が 10% 超ずれる。 したがって、繰り返しを増やせば正確になるという直観に頼れず、クラウド内に隠れた状態を既知の状態に戻して各回を独立にする必要がある。
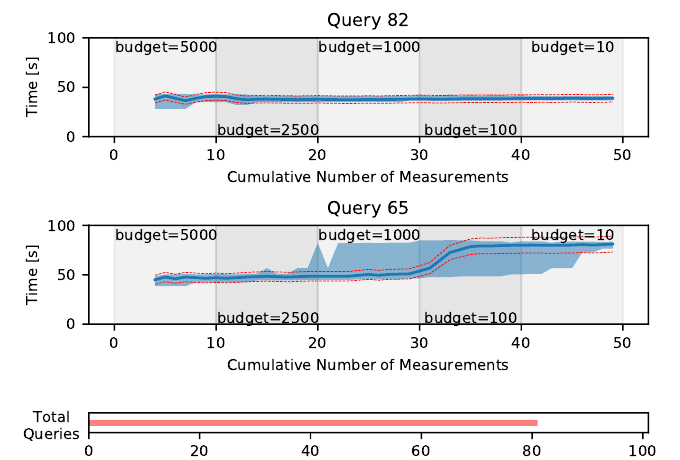
Figure 19: 2 つの TPC-DS クエリについて、5 つの予算にわたる中央値の推定(青太線)、95% 非パラメトリック信頼区間、10% の誤差境界(赤点線)。下の棒は、中央値の推定が悪いクエリの割合。
論文の指針(Section 5)
論文が挙げる 4 つの知見は次のとおり。
- F5.1:ネットワーク負荷の高い実験の結果は、異なるクラウド間で直接比較できない。同じクラウドで比べるか、複数のクラウドで感度分析をする。
- F5.2:同じクラウドでも、期待するネットワーク挙動のベースラインを事前に確立し、結果と一緒に公開し、新しい実験の前に確認する。マイクロベンチマークには、少なくとも基底レイテンシ、基底帯域、前景トラフィックによるレイテンシ変化、トークンバケットのパラメータ(あれば)を含める。論文はこれを「performance fingerprint」と呼ぶ。
- F5.3:隣接テナントなどの確率的な雑音は、信頼区間や ANOVA で扱える。ただし文献より多くの繰り返しが要る。中央値と裾の信頼区間が許容誤差(例:測定値の 5%)に収まるかで十分かどうかを判定する。
- F5.4:独立性や定常性などの統計的前提を壊す揺らぎがある。標本の正規性・独立性・定常性を検定し、必要なら非パラメトリック統計、定常な期間への限定、長期間の繰り返しを使う。
限界(論文自身の記述と、読み取れる範囲)
- 帯域の分布は Ballani らの四分位から一様サンプリングで作っており、サンプル間の相関は再現していない(論文が断っている)。
- 測定の対象は c5 系(EC2)、Google の数種のコア数、HPCCloud に限られる。
- Figure 7 のような 10 秒の切り出しでは、10 分スケールの切り替えは見えない。
- 2019 年 8 月以降の 5 Gbps 制限については、原因が分からないと論文が述べている。
関連研究との関係
このノートの時点で、他のノートへのリンクはない。 関連する Ballani らの研究(Figure 2 の元データ)と Maricq らの CONFIRM は、このリポジトリにまだノートがない。
Q&A
自分のコメント
- 測っているのはネットワーク帯域で、ディスクや NFS の書き込み・読み込み帯域ではない。ストレージに当てはめるには、同じ機構(トークンバケット的な絞り込み)が保存先側にもあるかを別に確かめる必要がある。この論文はそれを示していない。
- ElasticKernel の帯域プローブ(約 8 MB を 1 回書いて読み戻す)への含意としては、「短い測定は絞り込み前の帯域を見ているだけかもしれない」という警戒が得られる。ただし、保存先は Azure から medaka への NFS で、EC2 のインスタンス帯域とは別の経路である。トークンバケットの有無は測らないと分からない。
- 論文の F5.2(実験前にマイクロベンチマークで帯域ポリシーを測り、フィンガープリントとして報告する)は、「事前に正確に測る案」の裏づけになる。一方で、同じ c5.xlarge でも時期や個体で帯域の定数が違う(Figure 11、2019 年 8 月の変化)という報告は、「事前測定の値が実行時に通用するか」への反証にもなる。どちらに寄せるかの判断材料としては、両方の面を持つ。
- 論文のいう「繰り返しを増やすと逆に信頼区間が広がる」現象は、測定を何度も重ねる設計(連続測定)で、測定自体が状態を変える場合に注意すべき点になる。