AI解説
情報源:arXiv 版全文(https://arxiv.org/abs/2212.09290)を精読。図は同 PDF から抽出した。実装は公開されている(https://github.com/dfki-asr/xengine)。
一言で
Checkmate の MILP による最適な再計算(rematerialization)計画を、CPU と GPU が混在するヘテロジニアス環境に拡張した MIQP(混合整数二次計画)ソルバ。 どの演算子をどのタイムステップにどのデバイスで計算し、どのテンソルをチェックポイントとして保持し、どれを再計算するかを、デバイスごとのメモリ上限の下で一括して最適化する。 単一デバイスで最速の Checkmate スケジュールと比べて最大 22.5% 速いスケジュールを見つけ、GPU 単体ではメモリが足りず学習できないネットワークにも CPU/GPU 混合の実行可能スケジュールを与える。
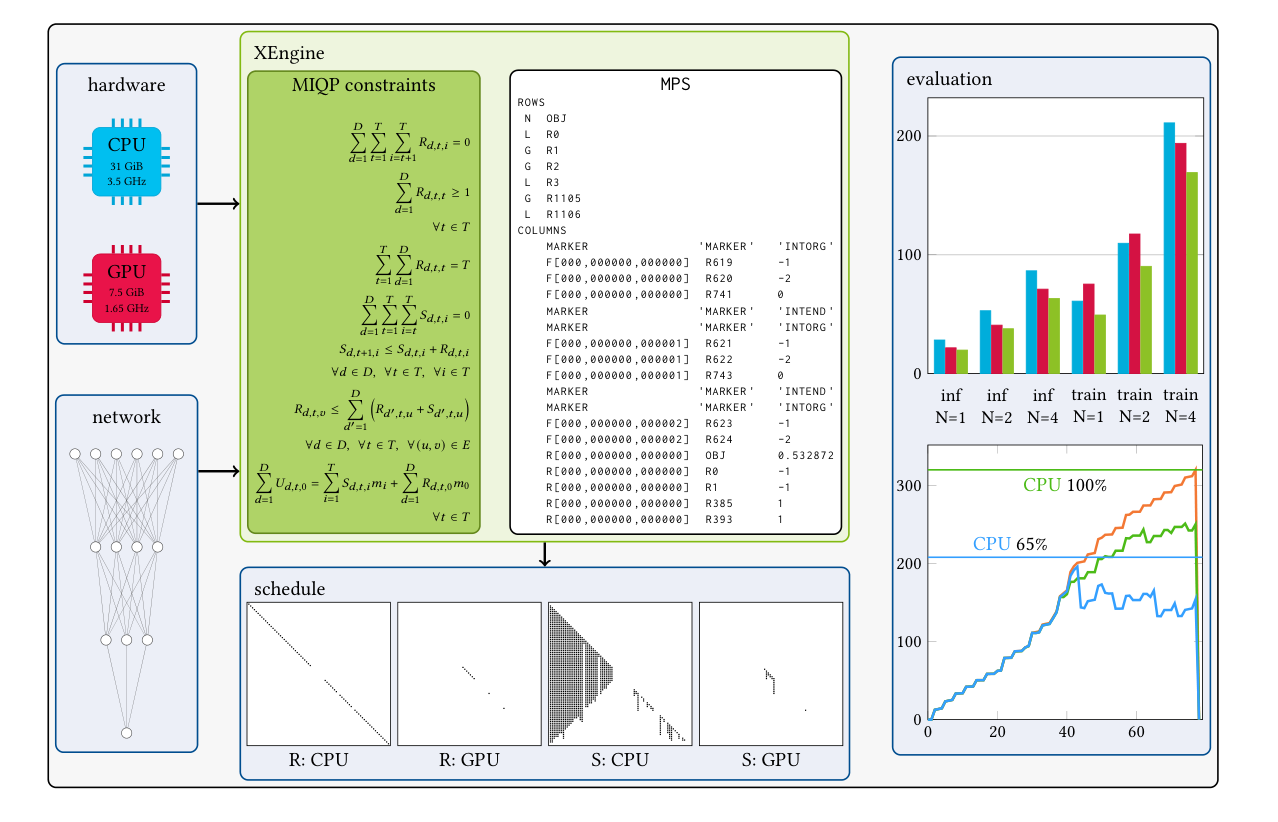
Fig. 1: XEngine の全体パイプライン。ハードウェアとネットワークのトポロジを読み込み、MIQP の制約を定義して MPS ファイルとして生成し、解いたスケジュール(中央下の R/S 行列)を出力する。右は実行時間とメモリ使用量の評価。
背景・問題
深層学習の学習では forward の活性を backward での勾配計算まで保持するのが普通だが、メモリが足りなければ一部のテンソルを破棄し、保存済みテンソル(チェックポイント)から後で再計算できる。 ここでの「チェックポイント」は、障害復旧のためにディスクへ保存するモデル重みのことではなく、破棄したテンソルを再計算するための起点として保持しておく forward テンソルを指す。
問題は、このチェックポイントの決め方が自明でないことに加え、既存の再計算手法(Chen らの分割法、Checkmate の MILP、DTR の貪欲オンライン法など)がすべて単一デバイスを前提にしていることである。 メモリも計算性能も限られた環境では、CPU を「テンソルの退避先」としてだけでなく計算デバイスとして使いたい。 しかし演算子を手動でデバイスに割り当てるのは、再計算を考えなくても難しい。 backward の依存構造は複雑で、単純に最速デバイスへ載せるとテンソルコピーのコストで損をする。
提案手法:MIQP による同時最適化
XEngine は Checkmate の MILP を出発点に、デバイス次元 d を全変数・全制約に追加する。
T 個の演算子を T タイムステップで、D 個のデバイスに割り当てる。
- R(compute 行列):
R[d,t,i] = 1なら演算子iをタイムステップtにデバイスdで(再)計算する。形状は|D|×|T|×|T|。 - S(save 行列):
S[d,t,i] = 1なら演算子iの出力をタイムステップtにデバイスdで保持する。 - F(free 行列):テンソル(エッジ
e=(u→v))をいつどのデバイスで解放するか。 - U(memory 行列):各タイムステップでの占有メモリ量(連続変数)。デバイスごとの予算
b_dを超えられない。 - Z(availability 行列):
Z[d,t,u] = 1ならuの出力がデバイスd上で利用可能(計算済みまたは保持中)。コピーコストを一度だけ数えるために導入する。
目的関数は計算コストとコピーコストの和である。
minimize  Σ_d Σ_t Σ_i c[d,i]・R[d,t,i]  +  W
W = Σ_t Σ_{e=(u→v)} Σ_{d'} Σ_d  w[e,d,d']・R[d',t,v]・Z[d,t,u]
c[d,i] は演算子 i をデバイス d で計算するコスト、w[e,d,d'] はテンソル e をデバイス d から d' へコピーするコストである。
コピーコスト項 W が決定変数の積 R・Z を含むため、Checkmate の MILP と違って二次(quadratic)の問題になる。
これが名前の由来である MIQP で、直感としては「v を d' で計算する(R)とき、依存テンソル u が別デバイス d にしかない(Z)ならコピー代を払う」という条件付きコストを表す。
制約は Checkmate のものにデバイス次元を加えた形で、主なものは次のとおり。
- 対角線制約:演算子
iの初回計算はタイムステップt=i(行列の対角線)。再計算は対角線より下でのみ許す。 - 各タイムステップで少なくとも1つの新しい演算子をいずれかのデバイスで評価し、全演算子を一度は評価する。
- 保存は「同じデバイスで前のステップに計算済みか保存済み」のときだけ許す(コピーしてから保存する、は不可)。
- 計算は「依存テンソルがどこかのデバイスで利用可能」なときだけ許す(別デバイスにあればコピーコストが目的関数に乗る)。
- メモリの初期化と漸化式:チェックポイントの合計サイズから始め、演算子の評価で確保し、以後使われないテンソルを解放する。
実行フレームワークとコスト計測
ネットワークは ONNX モデルとして読み込み、Intel oneDNN 上で実行する。 演算コストは全演算子を全デバイスで一度実行して計測し、デバイス間のテンソルコピーコストも双方向に計測する(oneDNN のメモリレイアウト変換は copy コストに含まれる)。 すべてのコストを事前に計測するオフライン方式なので、実行中の資源の増減には適応できず、静的グラフのみを扱う。動的グラフは対象外である。
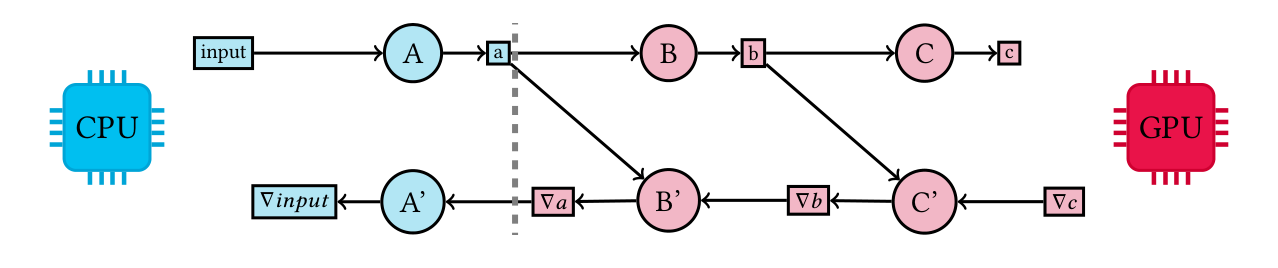
Fig. 2: forward 演算子 A, B, C とその backward 演算子 A’, B’, C’ の分配例。A と A’ を CPU(青)、残りを GPU(赤)に割り当てると、境界のテンソル a と ∇a のコピーが発生する。
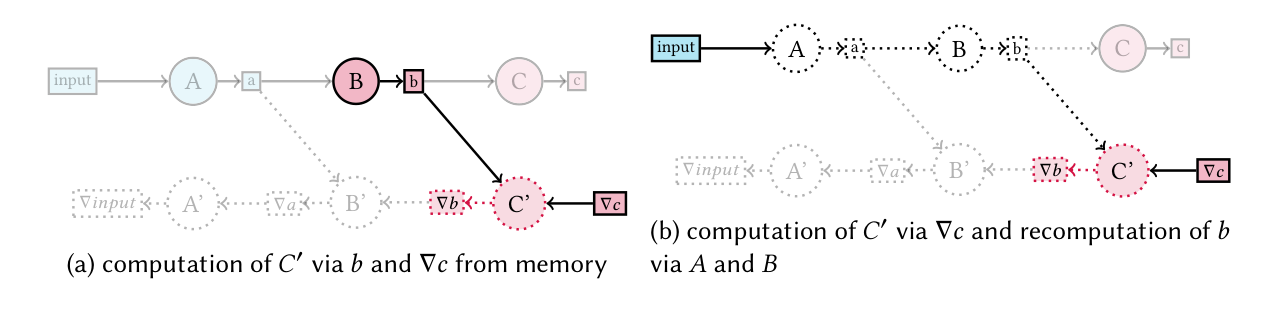
Fig. 3: 演算子 C’ の計算時に (a) 依存テンソル b と ∇c がメモリにあればそのまま計算でき、(b) b が破棄済みなら A と B の再計算が必要になる。再計算は CPU でも GPU でもよく、コピーコストとの兼ね合いで決まる。
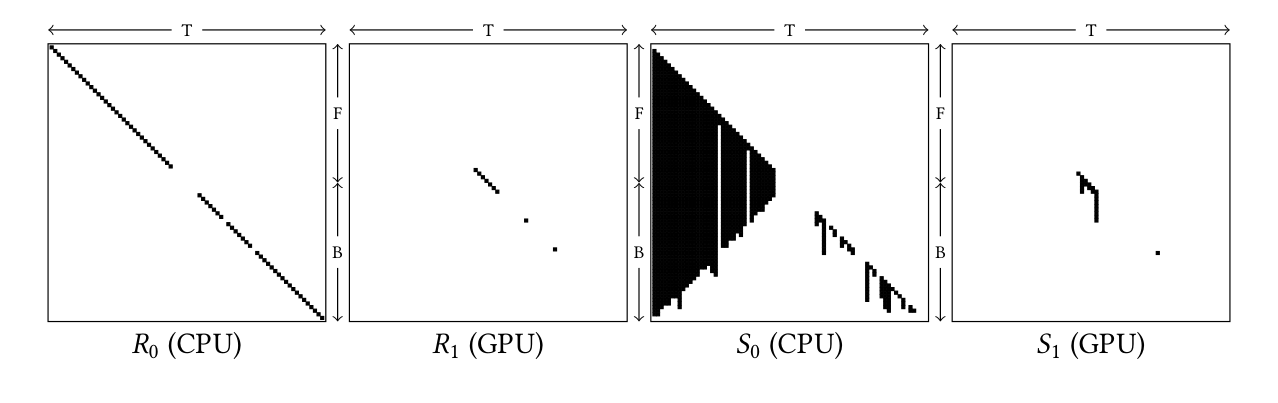
Fig. 4: メモリ予算 65%(208 MiB)で UNet(N=2)を学習する XEngine スケジュール。左から CPU の compute 行列 R0、GPU の R1、CPU の save 行列 S0、GPU の S1。列が演算子、行がタイムステップ。多くの演算子が CPU に載り、forward 終盤と backward 序盤だけ GPU に載っている。
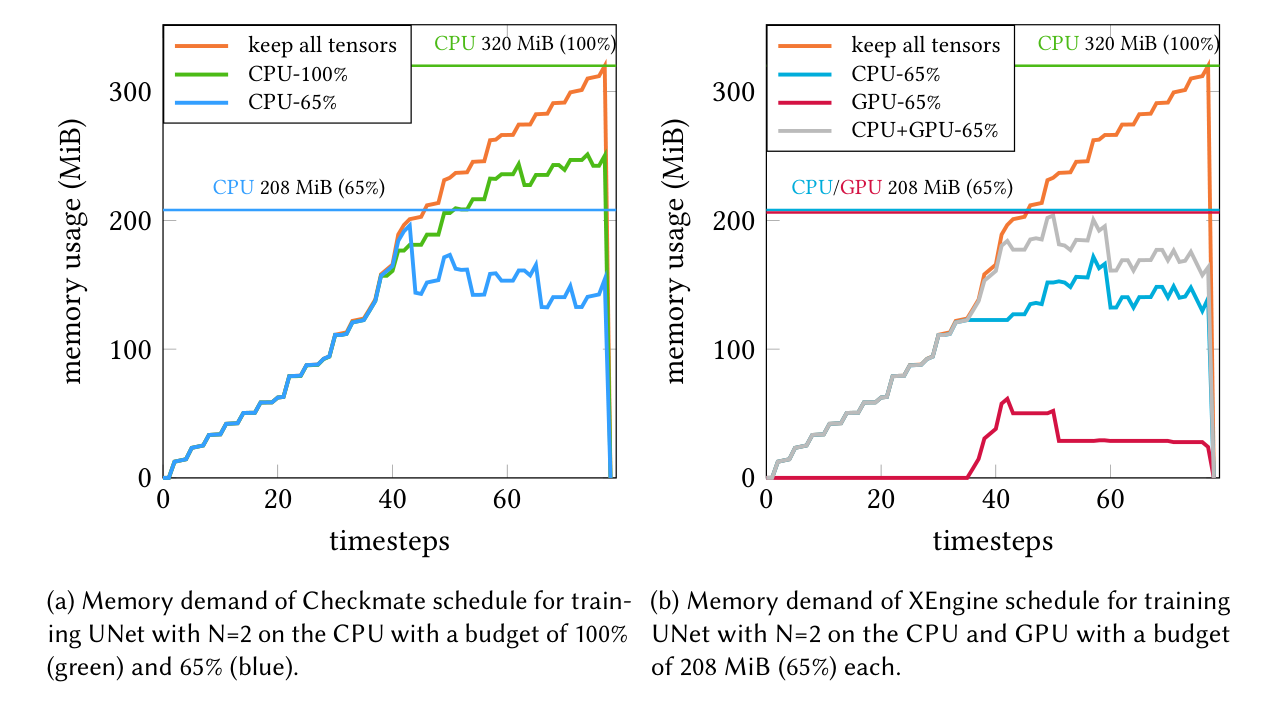
Fig. 5: UNet(N=2)学習のメモリ使用量。(a) Checkmate(CPU 単体)は予算 100%(緑)と 65%(青)。(b) XEngine は CPU(青)と GPU(赤)それぞれが 65% 予算を守り、灰色は両者の合計。オレンジは全テンソル保持の場合。
実験・結果
Intel DevCloud の2構成で評価している。 「Iris」は Core i9-10920X(24スレッド、31 GiB)と Iris Xe MAX GPU(7.5 GiB)、「Gen9」は Xeon E-2176G(12スレッド、50 GiB)と UHD Graphics P630(62.6 GiB)である。 CPU スレッド数を 4〜24 に変えて CPU と GPU の性能比を振り、VGG16/19、ResNet18/34、UNet を推論と学習の両モードで評価する。 メモリ予算は「全テンソルを保存するのに必要な量」を 100% とし、25% まで人工的に絞る。 比較対象は単一デバイス版の Checkmate(GPU だけでなく CPU 単体でも実行)である。
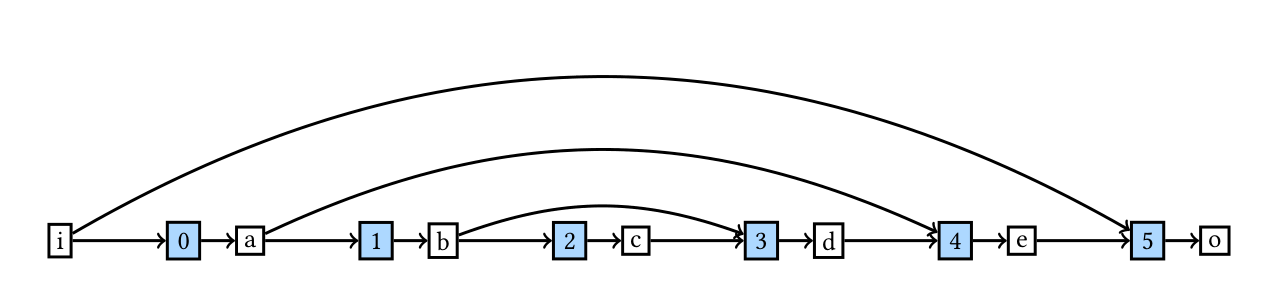
Fig. 6: 評価に使う UNet の構造。エンコーダ側のブロック出力がスキップ接続でデコーダ側の連結演算子につながるため、テンソルの生存期間が長く、メモリ要求が大きい。
結果の要点は次のとおり。
- CPU と GPU が拮抗するとき混合スケジュールが勝つ。UNet 学習で最大 19.2% 高速(Iris、N=1、12スレッド)、VGG19 推論で最大 22.5% 高速(Gen9、N=2)。UNet は平均でも推論 13.5%、学習 17% の短縮。
- GPU 単体で載らないモデルを救える。ResNet18 の N=128 学習は GPU 単体では動かないが、CPU/GPU スケジュールで CPU 単体 Checkmate より 18.1% 速く学習できる。VGG16 も N=8〜32 で同様。
- 予算を 25% まで絞っても追加コストは小さい。ResNet18/34 で +2.4〜4.0%、UNet で +8.2〜10.3% の計算コスト増で 75% のメモリ削減が得られる。
- 3デバイス(CPU+2GPU)への拡張も可能だが、2GPU が同性能の設定では CPU+GPU と比べて改善はほぼない(5.5% → 5.8% など)。
- ソルバ実行時間は問題サイズ次第で、VGG16 や UNet は数秒、ResNet18 は数時間かかる。ResNet34 推論のように 2% 以下しか縮まらない構成では、ソルバを回す価値がない場合もあると著者ら自身が述べている。
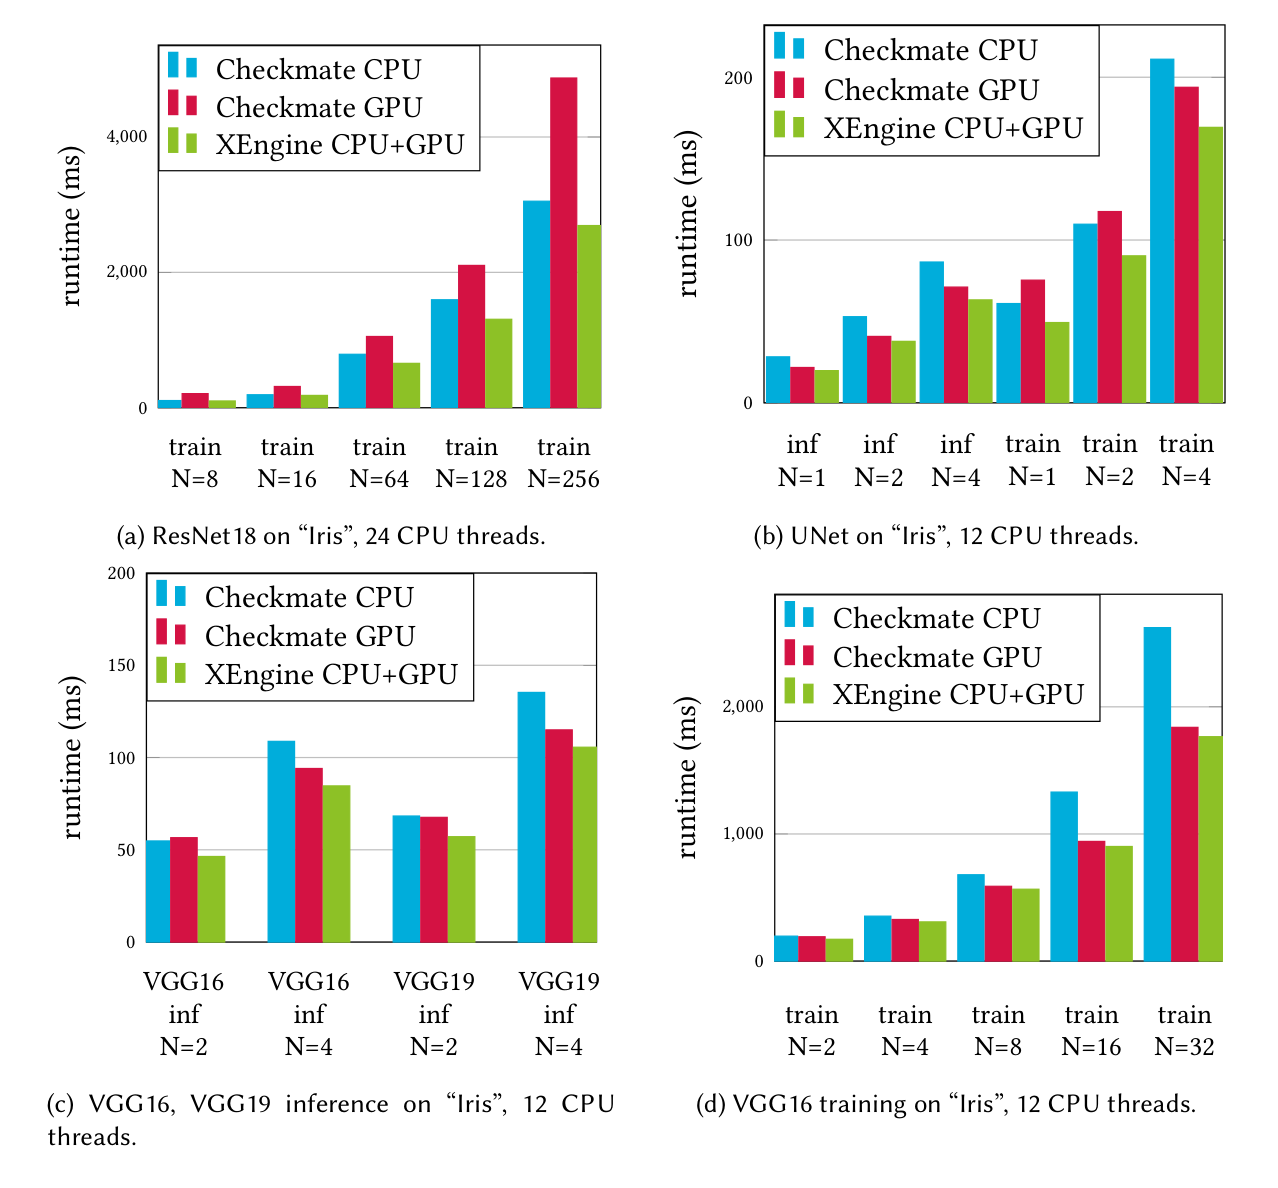
Fig. 7: 「Iris」での実行時間。(a) ResNet18 学習、(b) UNet、(c) VGG16/19 推論、(d) VGG16 学習。緑(XEngine CPU+GPU)が単一デバイスの Checkmate(青: CPU、赤: GPU)を一貫して下回る。
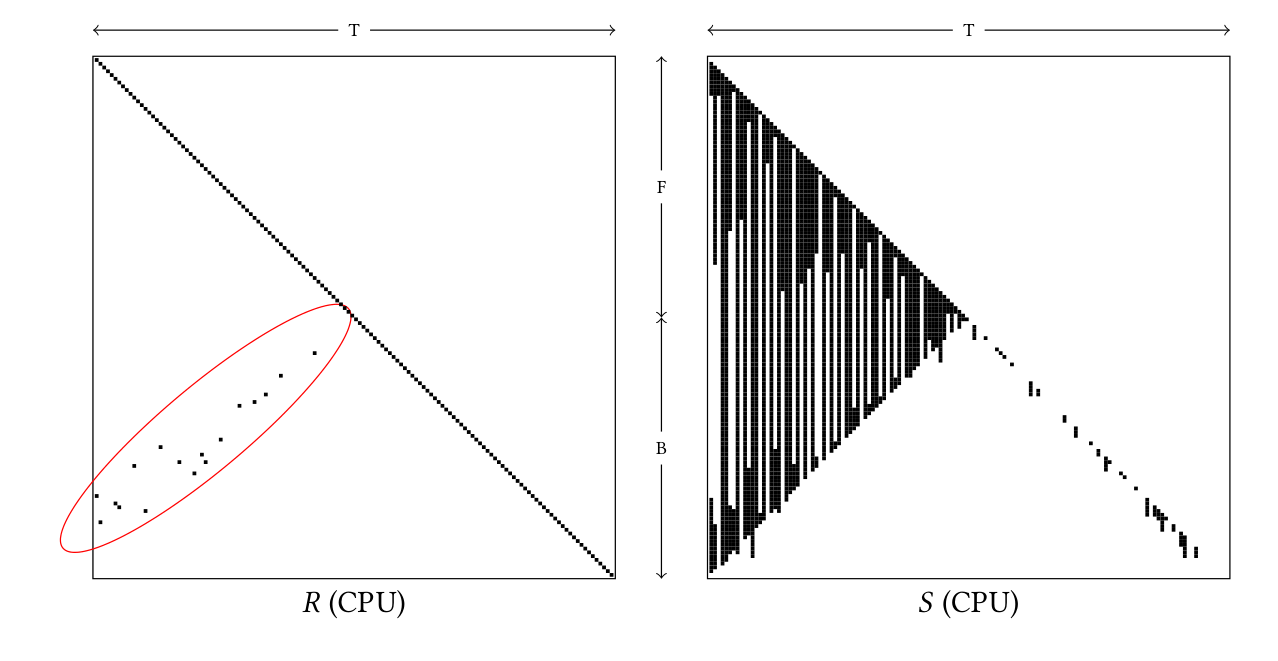
Fig. 8: 予算 25% で ResNet18(N=8)を CPU 単体で学習するスケジュール。R 行列の赤丸部分が backward 中の 17 回の再計算を示し、S 行列の白い縦筋がその出力を保存していなかったことを示す。
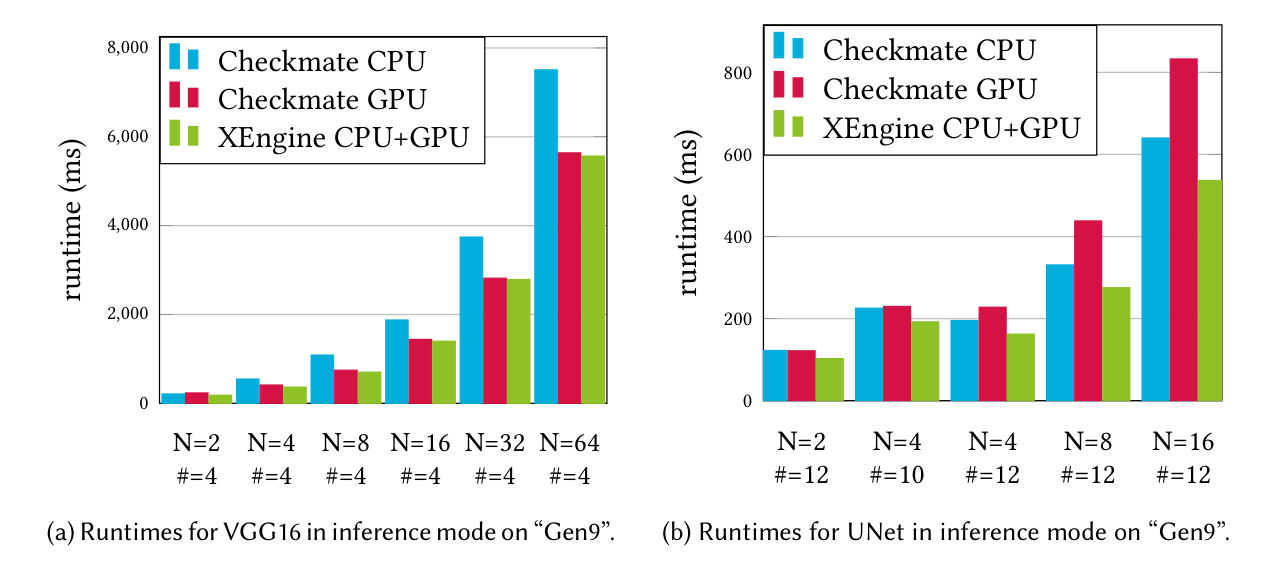
Fig. 9: 「Gen9」での推論の実行時間。(a) VGG16 はバッチが小さいほど混合スケジュールの利得が大きい(最大 14.2%)。(b) UNet は N=16 でも 16.2% の短縮を保つ。
エネルギー効率への拡張(議論)
MIQP は目的関数への重み付きコスト項の追加(+ αQ、Q は演算子ごとの消費エネルギーの和)か、デバイスごとのエネルギー予算というハード制約の追加で、エネルギー効率の最適化にも拡張できる。
ただし Intel DevCloud 上で消費電力を取得する手段がなく、実験はしていない。
モデル並列(ブランチの並列実行)は扱わない。演算子は逐次実行を仮定する。 スキップ接続の外側ブランチは計算が軽く、ボトルネックはメモリ転送になりがちなので、並列実行しても大きな短縮は見込めないという理由づけである。
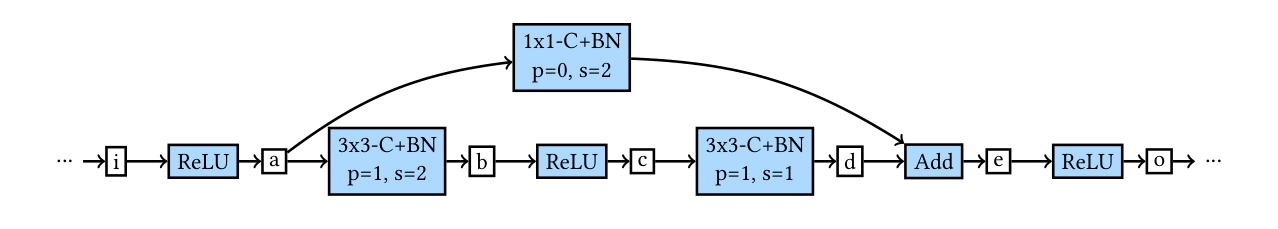
Fig. 10: ResNet18 の3番目のスキップ接続の部分グラフ。内側ブランチ(3×3 畳み込み×2)は外側ブランチ(1×1 畳み込み)の2倍以上の計算量を持つ。
関連研究との関係
本文の位置づけをまとめると次のようになる。
- Checkmate(Jain ら、MLSys 2020):単一デバイスの最適再計算を MILP で解く。XEngine はこれを出発点とし、全制約にデバイス次元を加えて MIQP 化した。「XEngine は Checkmate の多デバイス拡張」というのが最も正確な位置づけである。
- DTR(Kirisame ら):メモリ枯渇時に貪欲に親演算子を再帰的に再計算するオンラインヒューリスティック。XEngine はオフラインの厳密最適化で対照的。
- Capuchin・SuperNeurons:ランタイムシステムで情報を集め、再計算とスワップを組み合わせる。ただし計算は GPU のみで、CPU はテンソルの退避先にすぎない。XEngine は CPU を計算デバイスとして使う点が異なる。
- MegTaiChi(Hu ら、ICS 2022):動的グラフを扱えるオンライン手法(イテレーションごとに 5% 未満のオーバーヘッドを主張)。XEngine は静的グラフ専用のオフライン手法で、実行時オーバーヘッドがない代わりに動的グラフを扱えない、という表裏の関係。
- POET(Patil ら):エッジデバイス向けに MILP で再計算とページングを組み合わせ、エネルギー効率を狙う。Beaumont らは動的計画法で再計算とオフロードを組み合わせる。STR(Wen ら)はスワップ主導のテンソル再生成戦略。いずれも計算は単一デバイス前提。