AI解説
論文: 著者の公開 PDF(https://bigdata.uni-saarland.de/publications/SDQ10.pdf)。Proceedings of the VLDB Endowment, Vol. 3, No. 1。VLDB 2010(Singapore)で発表。 情報源: PDF 12 ページの全文(本文・図・表・付録 A・参考文献)を精読した。DOI とページ番号は PDF に印字されていないため、ここには書かない。 図について: 図は PDF のページを画像化して切り出した(
figures/fig*.png)。Figure 1〜13 を収録した。表(Table 1〜4)は本文の数値を文章に引用するにとどめ、画像にはしていない。 図番号とキャプションは原論文に対応する。AI 生成の補足図は付けていない。 Figure 3 の注意: 原論文の Figure 3 は、キャプションと縦軸ラベルが食い違っている。詳細は該当の図の直下に書いた。図からの数値の読み取りは行わない。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+robots.txtで検索除けされている。
一言で
Amazon EC2 の性能は、CPU・メモリ・ディスク I/O・ネットワークのどれもが大きく揺れる。 12 月中旬から約 1 か月(年は本文に記載なし)、毎時 2 回、新規に取り直した仮想マシン上で標準的なマイクロベンチマークを回して、その揺れを測った。 揺れの大きさは変動係数(COV)で表すと、EC2 では CPU 21〜24%、ディスク I/O 9〜20%、ネットワーク約 19% だった。 物理クラスタの COV(ディスク I/O で 0.6〜1.9%、ネットワークで 0.2%)より 1〜2 桁大きい。 測定値は 2 つの性能帯に分かれることが多く、少なくとも CPU とメモリでは、その主因は仮想マシンの下の物理プロセッサ(Xeon か Opteron か)の違いだった。 Availability Zone(AZ)の選択も、揺れに効く。
背景・問題
解くべき問題
クラウド上の性能が予測できないことは、2 つの立場に困りごとを生む。
- データベース研究者は、wall clock の実験を再現できない。
- アプリケーション提供者は、性能に基づく SLA を守れない。クラウド事業者の SLA は、サービスの可用性だけを保証していて、応答時間やスループットは対象にしていない。
論文は、先行研究が次の点で足りないと述べる。
- 性能を比較したり、コストを評価したりする研究はあるが、性能の揺れそのものを評価したものは無い。
- Dejun らは EC2 の揺れを調べているが、アプリケーション層(MySQL、Tomcat)に限られ、揺れの源までは調べていない。
- CloudClimate や CloudKick などの監視サービスも、揺れの評価や低減の助言までは扱わない。
したがって問題は、「EC2 の性能はどの資源で、どれくらい、何が原因で揺れるのか」が定量的に分かっていないことである。
動機を示す実例(Figure 1)
50 ノードの MapReduce ジョブを、EC2 のクラスタとローカルクラスタで繰り返し実行した結果が、導入部に示されている。 ローカルクラスタの実行時間はほぼ一定である。 EC2 では実行時間が大きく変動する。
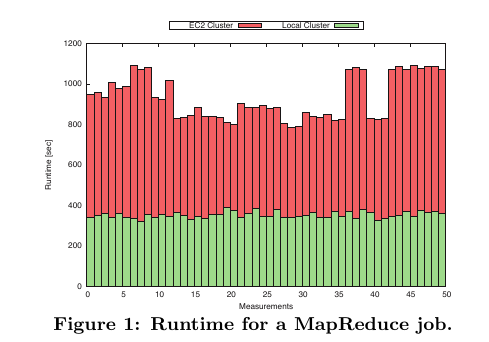
Figure 1: MapReduce ジョブの実行時間。EC2(赤)は大きく揺れ、ローカルクラスタ(緑)はほぼ一定。横軸は測定の回数、縦軸は実行時間(秒)。
測定設計
測った資源とベンチマーク
| 資源 | ベンチマーク | 内容 |
|---|---|---|
| インスタンス起動 | 独自 | 要求を送ってから状態が running になるまでの時間。2 秒間隔で状態を確認 |
| CPU | Ubench | 3 分間、整数・浮動小数点演算を並行実行。単一のスコアを出す |
| メモリ | Ubench | 3 分間、ランダムなメモリ確保とメモリ間コピー。単一のスコアを出す |
| ディスク I/O | Bonnie++ | シーケンシャル read/write とランダム read を報告 |
| ネットワーク | Iperf | 2 インスタンス間の最大 TCP 帯域 |
| S3 | 独自 | ローカルクラスタから、新規バケットへ 100 MB をアップロードする時間 |
ディスク I/O の測定対象は、インスタンスのローカルストレージ(standard instance のローカルストレージと mnt パーティション)である。 ネットワークストレージ(NFS など)ではない。 Bonnie++ と Ubench と Iperf は、すべてデフォルト設定で実行した。 Bonnie++ のファイルサイズや I/O サイズは、本文に記載が無い(本文未記載)。 論文は、シーケンシャル write と read の結果がほぼ同じだったとして、シーケンシャルについては read のみを図示している。
実行方法
- 期間は 31 日間(12 月 14 日〜1 月 12 日)。1 時間に 2 回、すべてのベンチマークを順番に実行した。
- small と large の 2 種類のインスタンスを、US と EU の 2 か所に 1 台ずつ使った。OS は Fedora 8。
- 各ラウンドの終わりに、インスタンスを 55 分で全部シャットダウンする。次のラウンドでは Amazon に新しいインスタンスを作らせる。狙いは、測定を複数の物理ノードに分散させ、全体としての分布を得ることである。
- 1 回のベンチマークが 30 分を超えることがあるため、その場合は 1 時間に 1 回だけ実行した。
- ベンチマーク同士が干渉しないよう、同時には 1 つだけ実行した。
- Iperf は 2 台が必要である。2 台が同じ AZ にあるか否かで結果が変わりうるため、AZ が同じ場合と違う場合を分けて実験した。
- 比較の基準(ベースライン)として、同じベンチマーク(起動と S3 を除く)を、Xeon 2.66 GHz 4 コア・メモリ 16 GB・SATA ディスク 6 台のローカルの物理クラスタで実行した。この物理クラスタには、実験中に他の負荷が無い。論文は、これを最良のケースとみなしている。
揺れの指標:COV
揺れの大きさは、変動係数(COV)で表す。
COV = (1/x̄) · sqrt( (1/(N−1)) · Σ (x_i − x̄)² )
ここで N は測定回数、x_i は各測定値、x̄ はその平均である。
標準偏差を平均で割ってあるので、単位や平均の異なる資源の間で揺れの大きさを比べられる。
標準偏差は標本標準偏差であり、N ではなく N−1 で割る。
論文は、N−1 個の差だけが独立だからだとしている。
COV は相対標準偏差(標準偏差を平均で割った値)と同じ量である。 論文は百分率でなく小数(0.21 など)でも、百分率(21%)でも書いている。
結果
ベースライン(物理クラスタ)
Table 1 によれば、物理クラスタの COV は次のとおりである。
| 資源 | COV |
|---|---|
| CPU | 0.001 |
| メモリ | 0.003 |
| シーケンシャル read | 0.006 |
| ランダム read | 0.019 |
| ネットワーク | 0.002 |
CPU とメモリ(Figure 2)
CPU のスコアは、2 つの帯に分かれる。 small では約 115,000〜120,000 と約 58,000〜60,000、large では約 450,000〜550,000 と約 180,000〜220,000 である。 ほとんどすべての測定が、どちらかの帯に入る。 COV は small で 21%、large で 24% であり、ベースラインより少なくとも 200 倍大きい。 large の平均(465,554)を small の平均(116,167)で割ると 4.0076 になり、公称の性能差(4 倍)にほぼ一致する。
メモリも 2 つの帯に分かれる。 COV は small で 8%、large で 10% で、物理クラスタの 0.3% より桁違いに大きい。
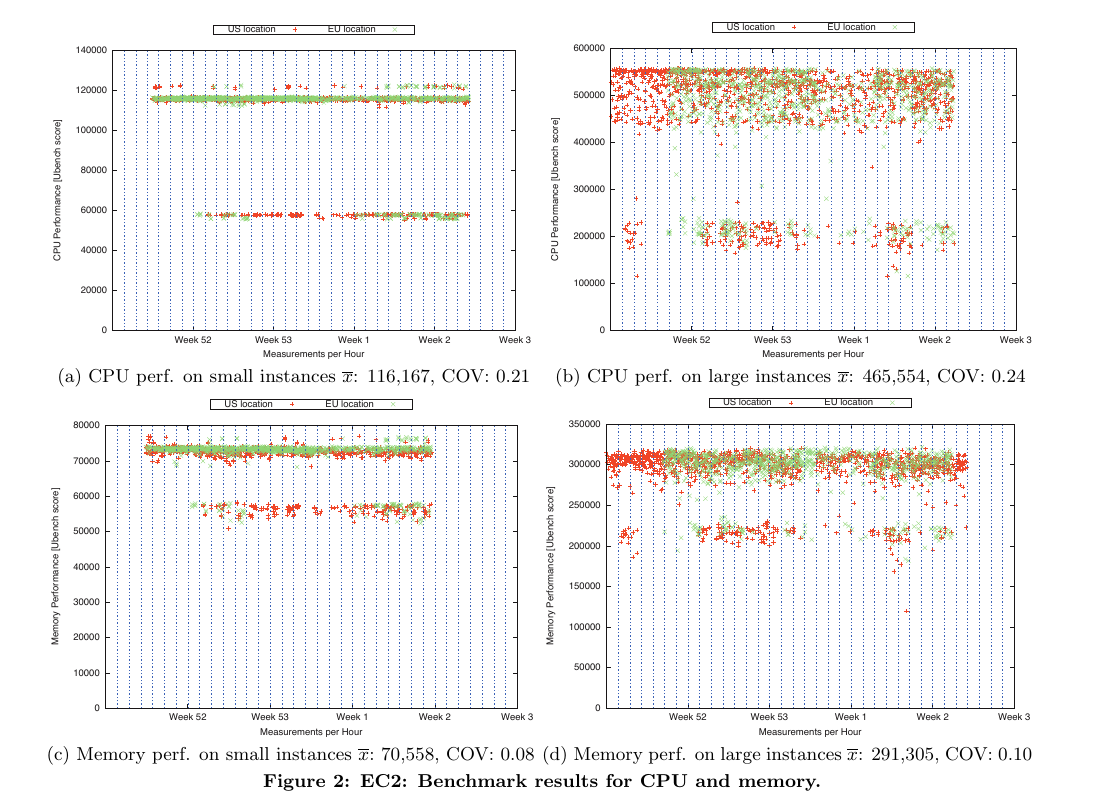
Figure 2: EC2 の CPU・メモリのベンチマーク結果。(a)(b) は CPU(small/large)、(c)(d) はメモリ(small/large)。どちらも 2 つの性能帯が見える。
ディスク I/O(Figure 3)
ディスク I/O の COV は、論文の本文によれば 9% から 20% である。 物理クラスタでは 0.6% から 1.9% であり、差は約 1 桁である。 シーケンシャル read の測定値は広い範囲にばらつき、small では約 55,000〜75,000 KB/s の帯に広がる、と本文は述べる。 large の EU のランダム I/O は、US と大きく違って見える。 論文は、データセンターごとにディスクの種類が違う可能性を挙げているが、検証していない。
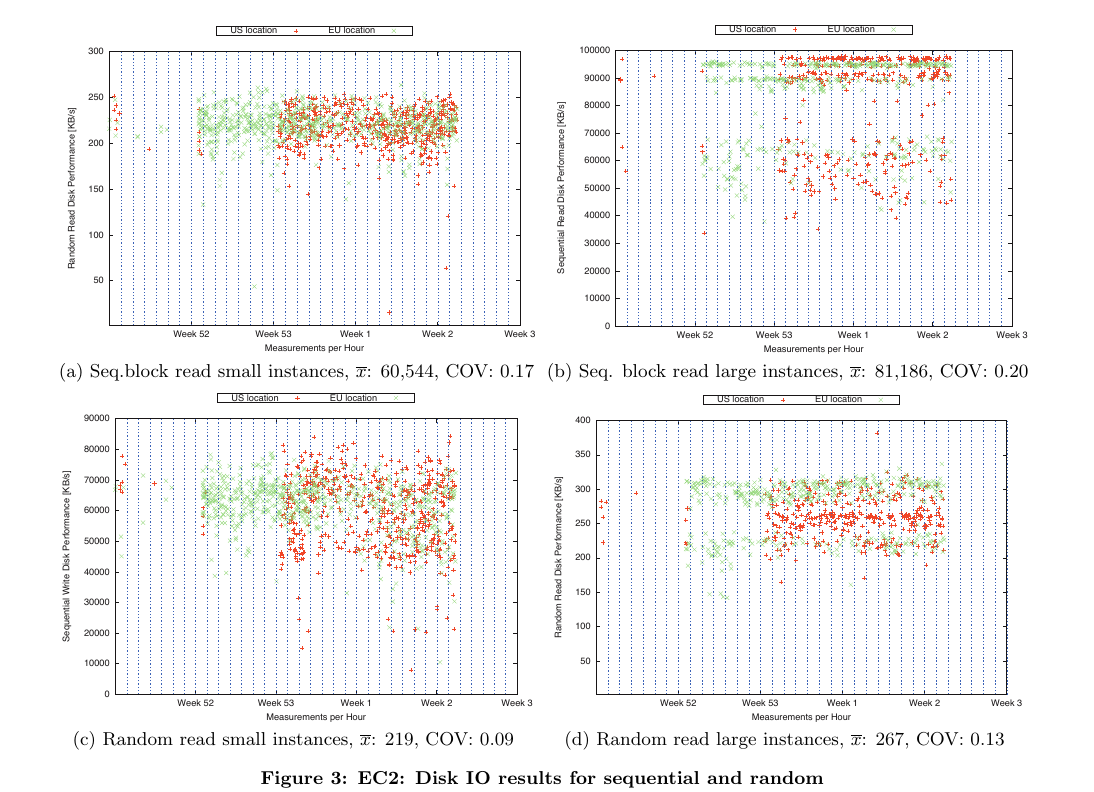
Figure 3: EC2 のディスク I/O(シーケンシャルとランダム)。測定値が 2 つの性能帯に分かれる様子が見える。原論文の図は、キャプションと縦軸ラベルが食い違っている。例えば (a) のキャプションは「Seq. block read small instances」だが、縦軸ラベルは「Random Read Disk Performance」である。(c) のキャプションは「Random read small instances」だが、縦軸ラベルは「Sequential Write Disk Performance」である。このため各パネルの数値(平均・COV)と図の対応は確定できず、本ノートでは図からの数値の読み取りも、パネルごとの COV の対応づけも行わない。
ネットワークと S3(Figure 4、5)
ネットワーク帯域の COV は約 19% で、物理クラスタ(0.2%)の約 2 桁上である。 範囲は、物理クラスタで 6 KB/s、EC2 で 728 KB/s であった。 US のほうが、EU より揺れがやや大きい。 論文は、EU は新しく利用者が少ないため共有が少ないのではないかと推測するが、Amazon の内部情報が無いので検証できないと書く。
S3 のアップロード時間は、平均 120 秒で COV は 54% である。 この測定にはローカルクラスタと Amazon のデータセンターの間の経路が含まれ、Amazon 外のトラフィックの影響も受ける。 論文は「完全性のために示す」としている。
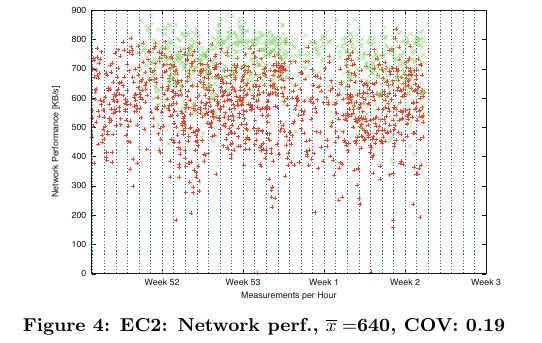
Figure 4: EC2 のネットワーク性能(平均 640、COV 0.19)。
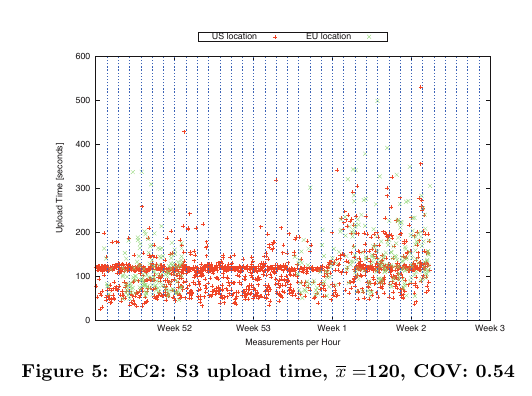
Figure 5: EC2 の S3 アップロード時間(平均 120 秒、COV 0.54)。
揺れの原因の分析
分布:2 つの性能帯(Figure 6、Table 2)
測定値の分布を見ると、US の small・large のランダム I/O(Figure 6(a)(b))と US のネットワーク(Figure 6(f))は、正規分布に見える。 それ以外は 2 つの帯に分かれる。 帯の多くは正規分布に従わない。 例えば、US large のシーケンシャル I/O(Figure 6(c))には、約 45,000〜70,000 KB/s の広い帯と、約 87,000〜97,000 KB/s の狭い帯がある。 論文はキャッシュ(warm と cold)を可能な説明として挙げたが、データの追加分析では確認できなかったと書く。
Table 2 によれば、低い帯に入る測定の割合は次のとおりである。
- CPU の large は 22%。この帯の性能は、高い帯の約 50% しかない。
- メモリは large で 27%、small で 36%。
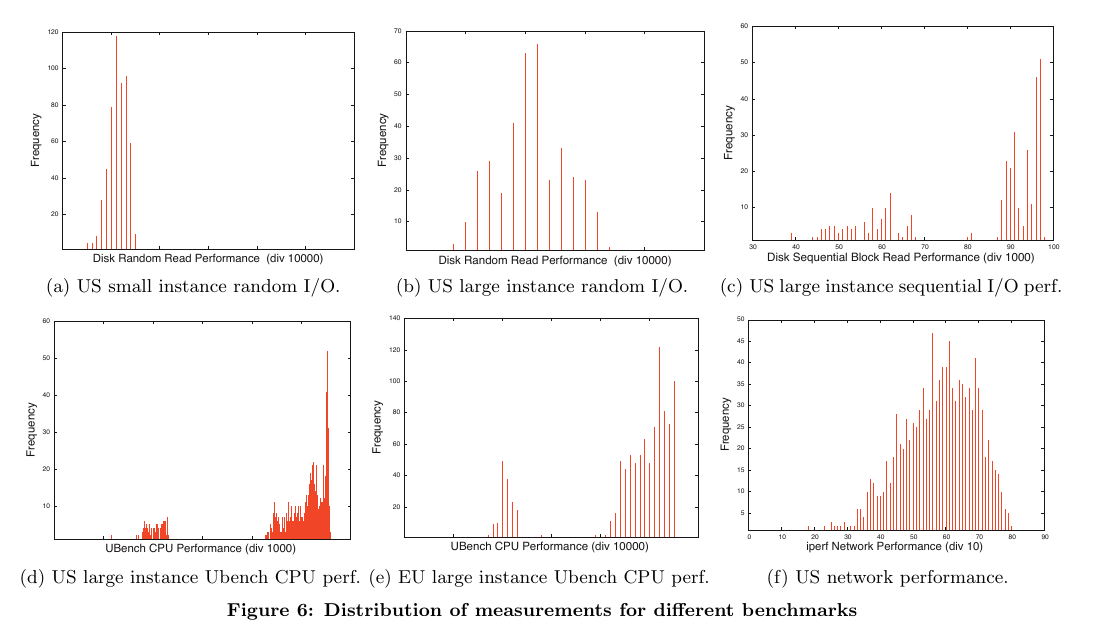
Figure 6: 各ベンチマークの測定値の分布。(a)(b) US のランダム I/O(small/large)、(c) US large のシーケンシャル I/O、(d)(e) US/EU large の Ubench CPU、(f) US のネットワーク。(a)(b)(f) は単峰、それ以外は 2 つの帯が見える。
要因 1:物理プロセッサの種類(Figure 7)
EC2 の下には、少なくとも 2 種類のプロセッサ(Xeon と Opteron)がある。
プロセッサの種類は、インスタンス内の /proc/cpuinfo で分かる。
各種類のインスタンスを 5 台ずつ作り、Ubench を 100 回ずつ実行した。
結果は、CPU の 2 つの帯をほぼ説明した。 Opteron が低い帯、Xeon が高い帯に対応する。 各帯の中の COV は、Xeon で 1%、Opteron で 2% であった。 両者を混ぜた COV は 35% であった。
メモリの COV も、混合では 13% だったものが、Xeon で 1%、Opteron で 6% に下がった。 ディスク性能でも、プロセッサに依存した 2 つの帯の証拠が見つかった、と書かれている。 ただし、ディスクについて数値は示されていない。
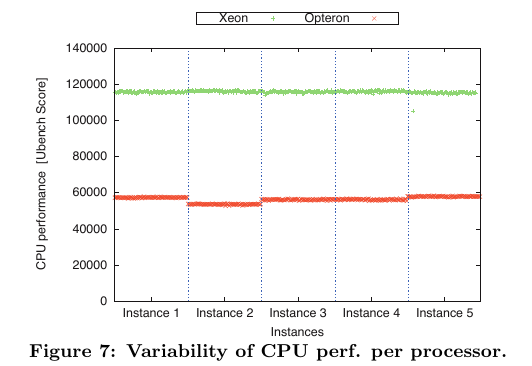
Figure 7: プロセッサの種類ごとの CPU 性能の変動。Opteron のインスタンス(低い帯)と Xeon のインスタンス(高い帯)が分かれる。横軸は各インスタンスの 100 回の測定。
要因 2:Availability Zone(Figure 8〜10)
ネットワーク。 2 台が同じ AZ にあるとネットワークが良くなる、という仮説を検証した。 EU では、ほとんどのインスタンスの組が同じ AZ に割り当てられるため、比較できない。 US では、同じ AZ の組の平均が 588、違う AZ の組の平均が 540 で、同じ AZ のほうが 9% 良かった。 t 検定で、帰無仮説は p = 1.1853 × 10⁻¹¹ で棄却された。
CPU。 US の large インスタンスは、実際には us-east-1c と us-east-1d にしか割り当てられなかった。 低い帯の測定は、すべて us-east-1c のものだった。 us-east-1d だけで測定していたら、すべての測定が 1 つの帯に入り、COV も下がっていたはずである。 論文は、AZ によってプロセッサの種類の比が違うことが理由の一部だろうと推測している。 これは論文の推測であり、検証はしていない。
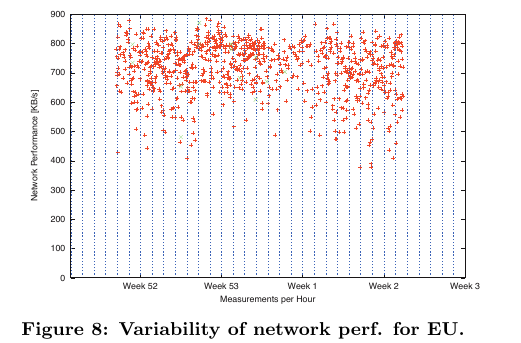
Figure 8: EU のネットワーク性能の変動。2 台が同じ AZ の場合を赤で示す。EU ではほとんどが同じ AZ の組である。
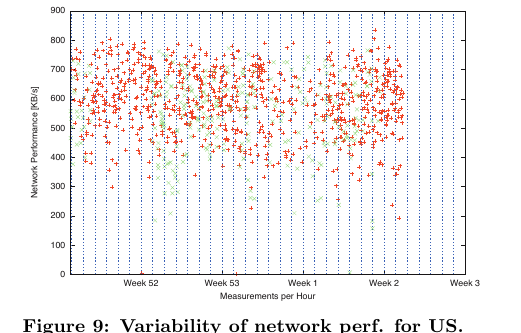
Figure 9: US のネットワーク性能の変動。同じ AZ か違う AZ かで、平均が異なる。
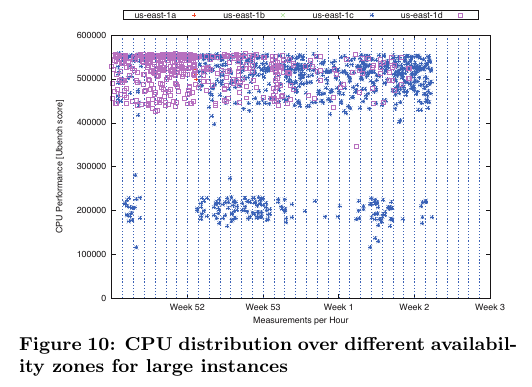
Figure 10: large インスタンスの CPU 性能を AZ 別に色分けした図。低い帯の測定はすべて us-east-1c のものである。
要因 3:インスタンスの種類(Figure 11)
large の標準偏差は small の約 4 倍だが、平均も約 4 倍なので、COV は同程度(small 21%、large 24%)になる。 ただし、small は 32 ビット、large は 64 ビットで、アーキテクチャが違うため、比較には限界があると論文は書く。 どちらの種類でも、CPU 性能が 50% 低い測定がある。
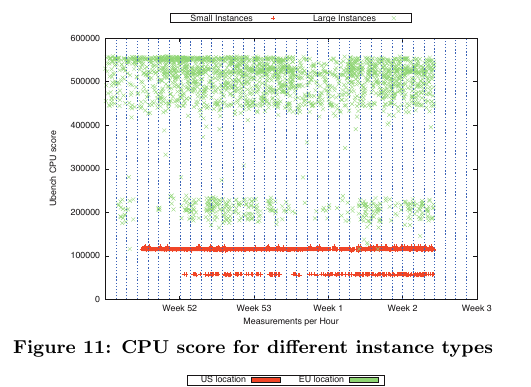
Figure 11: インスタンスの種類(small/large)ごとの CPU スコア。
要因 4:時間(Figure 12)
CPU 性能の COV を曜日別に見ると、US では月曜と週末が約 19% で、火曜〜金曜は 26% を超える。 EU では、この傾向が成り立たない。 CET で測定しているので、US ではまだ日曜にあたる月曜が低い。 論文は、利用者が勤務時間にアプリケーションを動かすからだと推測している。 別の説明として、Amazon の通販の利用が減って EC2 に資源が回るため、とも書いている。 どちらも検証はされていない。
付録 A では、日・時・時間帯・曜日の 4 つの粒度で、揺れを 2 通りに分解している。 1 つは「粒度間」の分析で、各グループの平均を出し、その平均の COV を取る。 もう 1 つは「粒度内」の分析で、各グループの COV を出し、その平均を取る。 前者で「平均が日ごとに変わるか」を、後者で「1 日の中での揺れ」を見る。 Table 3 と Table 4 に結果がある。
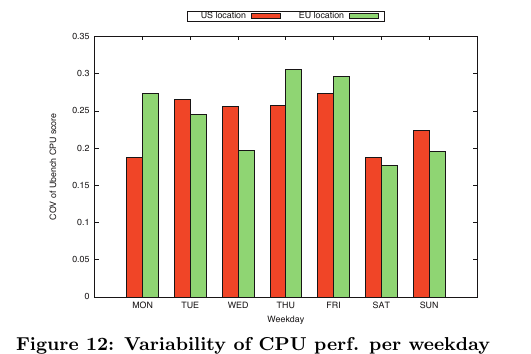
Figure 12: 曜日ごとの CPU 性能の COV(US/EU)。
実アプリケーションへの影響
クラスタを大きくすると揺れは平均化されるか(Figure 13)
50 ノードまで、仮想クラスタの大きさを変えて実験した。 ノード数と揺れの大きさに、有意な関係は見られなかった。 50 ノードで、クラスタを毎時作り直し、35 時間連続で測定した。 クラスタ全体の CPU の平均スコアは、それでも大きく揺れた。 クラスタ内の Xeon の割合が揺れるためだ、と論文は説明する。 数百ノードで揺れが減るかどうかは、将来の課題としている。
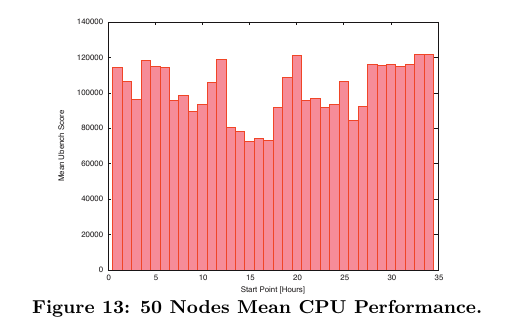
Figure 13: 50 ノードのクラスタの CPU 性能(平均 Ubench スコア)。横軸は開始時刻(時間)。平均を取っても揺れる。
MapReduce ジョブ
Hadoop 0.19.2 で、UserVisits の adRevenue を sourceIP ごとに合計するジョブを実行した。 データは 100 GB と 25 GB の 2 種類で、50 台の small ノードで実行した。 2 時間ごとに 3 回ずつ試行し、EC2 では試行の系列ごとに新しいクラスタを作った。 ローカルでは、10 台の物理ノード上の Xen で 50 台の仮想ノードを動かした。
large ジョブでは、Xeon が 80% を超えるクラスタの平均実行時間が 840 秒で、Xeon が 20% 未満では 1,100 秒だった。 全体の COV は 11% である。 同じ種類のプロセッサだけに限っても、揺れはローカルクラスタより 1 桁大きかった。
論文が示す対策
- EC2 の API ではプロセッサの種類を指定できない。したがって利用者は、結果と一緒に、使われたプロセッサの種類の割合を報告するとよい。
- クラスタを再割り当てすると種類の割合が変わりうる。アプリケーションを比べるときは、等価な仮想クラスタを使う。
- 再現性や予測可能性が重要なら、スケジューラに任せず、AZ を 1 つ指定する。us-east-1d は揺れが小さかった。
- クラウド事業者には、性能に基づく SLA を提供するべきこと、利用者が下の物理ハードウェア構成を指定できるようにするべきことを求める。
- 追加実験として、rackspace の CPU の COV が 2% だったと報告する。rackspace は単一のプロセッサ種類だけを使っているようだ、と論文は書く。これは EC2 を単一のプロセッサ種類に絞ったときの揺れに近い。
- 揺れが大きく、測定値が正規分布でないため、狭い信頼区間を定義するのが難しいかもしれない、とも述べる。システム A がシステム B よりかなり良いかどうかを判定する程度には、EC2 を使える、という立場である。
限界と未解決の点(論文の記述)
- 対象は Amazon EC2 の small と large のインスタンスだけである。他のクラウドは、rackspace の追加実験を除けば扱っていない。
- ディスク性能の 2 つの帯と、プロセッサの種類との関係について、数値は示されていない。
- Figure 3 は、キャプションと軸ラベルが食い違っている(上述)。
- AZ とプロセッサの種類の比の関係は推測である。
- 数百ノード規模でクラスタ平均の揺れが減るかどうかは、未検証である。
Q&A
自分のコメント
- 揺れの定義は COV(相対標準偏差)、対象はインスタンスのローカルディスクで、NFS のような共有ストレージではない。測定は VLDB 2010 論文時点の EC2 である。ストレージを跨いだ数値の比較には使えない。
- この測定は、毎ラウンドでインスタンスを取り直している。だから COV には、「どの物理ノードに当たったか」というインスタンス間の差が混ざる。同じインスタンスを連続で測った揺れとは別の量である。
- ElasticKernel の帯域プローブに引きつけると、この論文が言うのは「測るたびに別のホストに当たるなら、1 回の測定値はその揺れ幅の中のどこかの点にすぎない」ということである。NFS サーバーが固定されているなら状況は違う。この論文の数値は、そのまま当てはめられない。
- この論文は測定対象のサイズ(ファイルサイズなど)を扱っていない。サイズ依存の議論には使えない。