AI解説
DOI: https://doi.org/10.1145/3078597.3078605(HPDC ‘17, Washington DC, 2017-06-26〜30, 12 pages / 13 figures / 5 tables) 著者: Zhengchun Liu, Prasanna Balaprakash, Rajkumar Kettimuthu, Ian Foster(Argonne National Laboratory, 一部は University of Chicago) 情報源: 論文 PDF の全文(本文・図・表・式・参考文献)を精読した。付録は無い。 図について: 論文 PDF のページを画像化し、Figure 1〜13 を切り出した画像(
figures/fig*.png)。ベクタ図なので画質は元の PDF より劣る。 図番号とキャプションは原論文に対応する。AI 生成の補足図は付けていない。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+robots.txtで検索除けされている。 対象の注意: この論文が扱うのは 広域ネットワークを越える disk-to-disk のファイル転送(Globus / GridFTP)である。 単一ホストの NFS や、ローカルディスクへの書き込み単体の帯域を扱った研究ではない。
一言で
Globus の過去の転送ログ(数百万件)だけから、転送レートを予測する回帰モデルを作った研究。 転送ごとに「同じ端点で同時に走っていた他の Globus 転送の負荷」を特徴量として復元するのが核である。 頻繁に使われる 30 の端点ペア(edge)では、edge ごとのモデルで MdAPE が線形 7.0%、非線形(XGBoost)4.6% になる。 全 edge で 1 つの非線形モデルを使うと、論文の要旨と結論では 7.8% である。 現地での追加実験なしに、ログだけでモデルのパラメータを決められる点が主張である。
背景・問題
解くべき問題
広域の disk-to-disk 転送は、回線速度よりずっと遅くなることが多い。 論文は Globus の 2010〜2016 年の 390 万件超の転送を引き、平均転送速度は 11.5 MB/s にとどまるとする。 一方で、転送バイト数の 52% は 100 MB/s 超、14% は 1 GB/s 超で動いていた。 つまり、速い転送と遅い転送の差が非常に大きい。
個々の遅い転送は、手間をかければ原因を説明できる。 原因の候補は、設定ミス、およびストレージ・ファイルシステム・CPU・OS・NIC・中間ネットワーク機器・広域ネットワーク・転送ソフト・プロトコル・競合する処理の相互作用である。 しかし、「手軽に入手できる情報だけで、任意の環境の任意の転送を説明・改善する方法」が無かった。
既存の性能モデルは、サブシステムごとの特性を調べるために大量のオンライン実験を要し、一般には使いにくかった。 論文はこの「オンライン実験が必要」という点を問題とみなす。
取り組む課題
論文は貢献を 4 つ挙げる。
- 過去ログだけを使い、機械学習で転送性能モデルを作る方法を示す。
- 端点での競合負荷を表す特徴量を設計する。
- 競合負荷など、転送性能に非線形に効く特徴量を特定する。
- 競合負荷の情報を新しいデータ源で補うと、精度がさらに上がることを示す。
提案手法
対象のデータ(Globus ログ)
Globus は転送を仲介するクラウドサービスで、端点どうしを GridFTP(または HTTP)でつなぐ。 論文は GridFTP の転送だけを扱い、2015 年末までのログを使う。 端点は約 2.6 万、edge(転送が 1 回以上あった送信元と宛先の組)は 4.6 万である。 edge のうち、36,599 は 1 回しか使われていない。 100 回以上使われた edge は 2,496、1000 回以上は 182 である。
ログが持つ情報は、開始時刻 Ts、終了時刻 Te、総バイト数、ファイル数 Nf、ディレクトリ数 Nd、Globus の調整パラメータ、送信元と宛先の端点である。
フォールト数 Nflt もあるが、事前には分からないので、予測には使わず説明にだけ使う。
一方、端点やネットワークの性能、Globus 以外の競合負荷については、ほとんど情報が無い。
Figure 1: Globus による end-to-end のファイル転送の構造。両端のストレージ→GridFTP→ネットワークを、クラウドの Globus サービスが管理する。
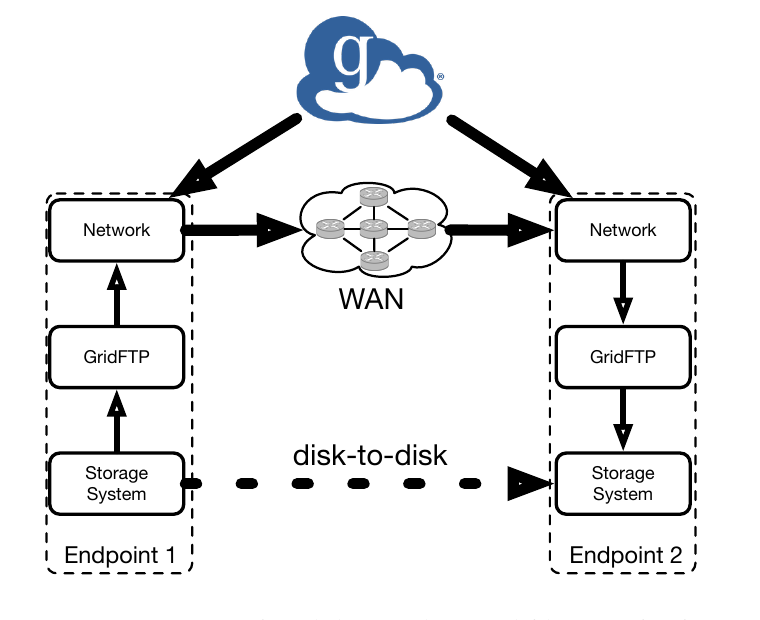
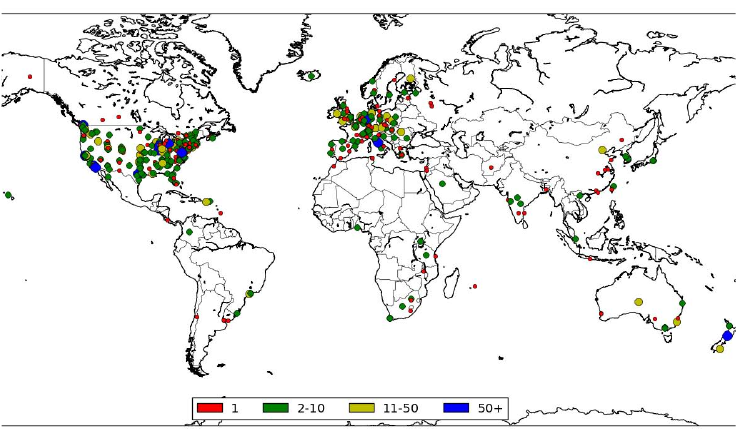
Figure 2: Globus 端点の地理分布。1 か所あたりの配備数で色分けしている。
上限を与える 3 項モデル(§3)
転送は送信元端点、ネットワーク、宛先端点の 3 つのサブシステムを通る。
最大転送レート Rmax は、各サブシステムの最大レートの最小値を超えない。
Rmax ≤ min(DRmax, MMmax, DWmax) (式1)
DRmax は送信元のディスク読み出しの最大レート、MMmax はメモリ間転送(ネットワーク込み)の最大レート、DWmax は宛先のディスク書き込みの最大レートである。
論文は ESnet のテストベッド(ANL, BNL, LBL, CERN の同一構成の DTN、10 Gb/s 回線)で式 1 を検証した。
/dev/zero→ディスクで DW、ディスク→/dev/null で DR、/dev/zero→/dev/null で MM、ディスク→ディスクで R を測る。
各実験は 5 回以上繰り返し、観測の最大値を max として採用している。
結果(Table 1)は、すべての edge が式 1 と矛盾しない。
ESnet 以外の端点では DRmax と DWmax を測れない。
そこで、その端点が送信元だった全転送の最大レートを DRmax、宛先だった全転送の最大レートを DWmax で近似する。
MMmax は perfSONAR 上の Iperf3 で、3 者間テストを許す 81 本の edge について数週間測った。
このうち 77 本を見ると、Rmax を式 1 で推定した値の 0.8〜1.2 倍に収まる edge は 38 本だった。
同時に走る他の Globus 転送の分を足すと、さらに 7 本が収まり、合計 45 本で式 1 が妥当である。
45 本の律速要因は、ディスク読み出しが 11、ネットワークが 14、ディスク書き込みが 20 である。
残りの 32 本は、式 1 の見積りより明らかに遅い。
特徴量(§4)
式 1 は上限だけを与える。実際の転送レートは競合負荷で下がる。
論文は、転送 k が走っていた間の端点の負荷をログから復元し、特徴量にする。
特徴量は 3 群、計 15 個(Table 2 の下 15 項)である。
| 群 | 特徴量 |
|---|---|
| ユーザーの調整パラメータ | 並行度 C(GridFTP プロセス数)、並列度 P(プロセスあたりの TCP 本数) |
| 転送の性質 | ファイル数 Nf、ディレクトリ数 Nd、総バイト数 Nb |
| 競合負荷 | 競合転送レート K、競合の GridFTP インスタンス数 G、競合の TCP ストリーム数 S |
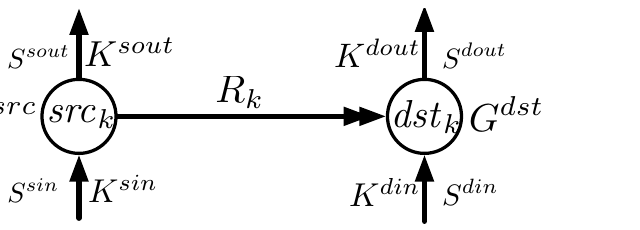
競合負荷は、他の転送 i が k と重なっていた時間の割合 O(i,k) / (Tek − Tsk) で重み付けして合計する(Figure 7)。
O(i,k) = max(0, min(Tei, Tek) − max(Tsi, Tsk))
K^x(k) = Σ_{i∈Ax} O(i,k)/(Tek − Tsk) · Ri            (式2)
G^x(k) = Σ_{i∈Ax} O(i,k)/(Tek − Tsk) · min(Ci, Fi)
S^x(k) = Σ_{i∈Ax} O(i,k)/(Tek − Tsk) · min(Ci, Fi) · Pi
Ax は、k を除く転送のうち、k の送信元または宛先と端点を共有するものの集合である。
x は sout(送信元の送出)、sin(送信元の受信)、dout(宛先の送出)、din(宛先の受信)を取る。
Ci は転送 i の並行度、Fi はそのファイル数である。
min(Ci, Fi) を使うのは、ファイル数が Ci より少ないと、使われる GridFTP インスタンスは Fi 個だけだからである。
C=4, P=4 と C=16, P=1 はどちらも TCP 16 本だが、GridFTP プロセス数は 4 と 16 で、後者は CPU 負荷が重い。
このため TCP ストリーム数とは別に、GridFTP インスタンス数を特徴量にしている。
Figure 7: 端点 src_k から dst_k への転送 k(レート Rk)が受ける、他の Globus 転送の負荷。(a) GridFTP インスタンス数、(b) TCP ストリーム数、(c) 競合トラフィックレート。
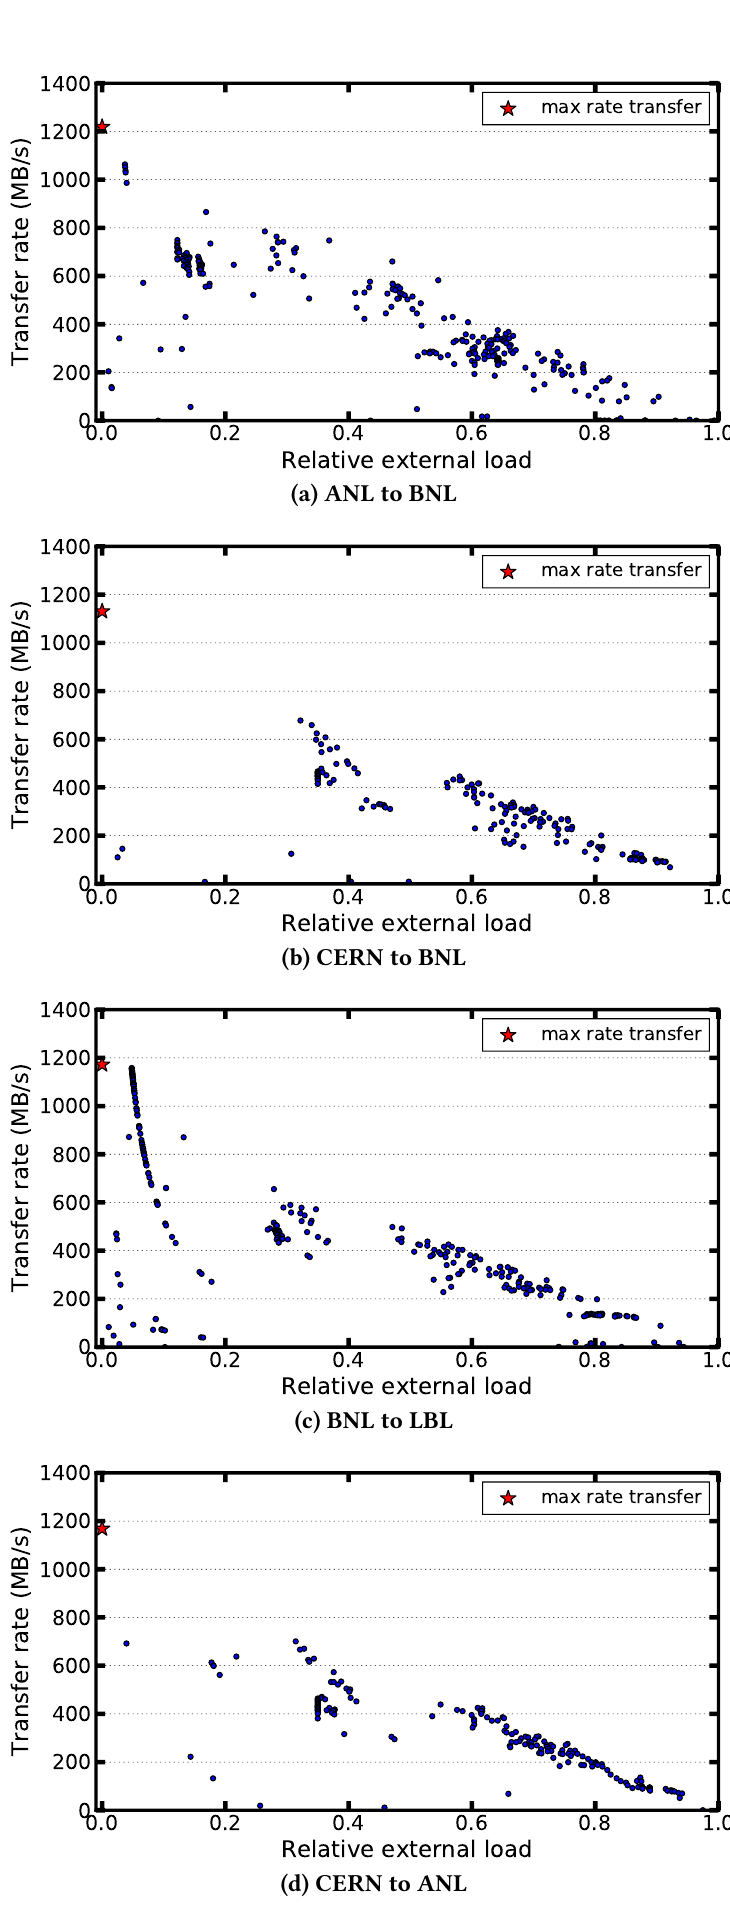
論文は、同時に走る転送の負荷を「相対外部負荷」とも定義する。
Ksout / (Rk + Ksout) と Kdin / (Rk + Kdin) の大きいほうである。
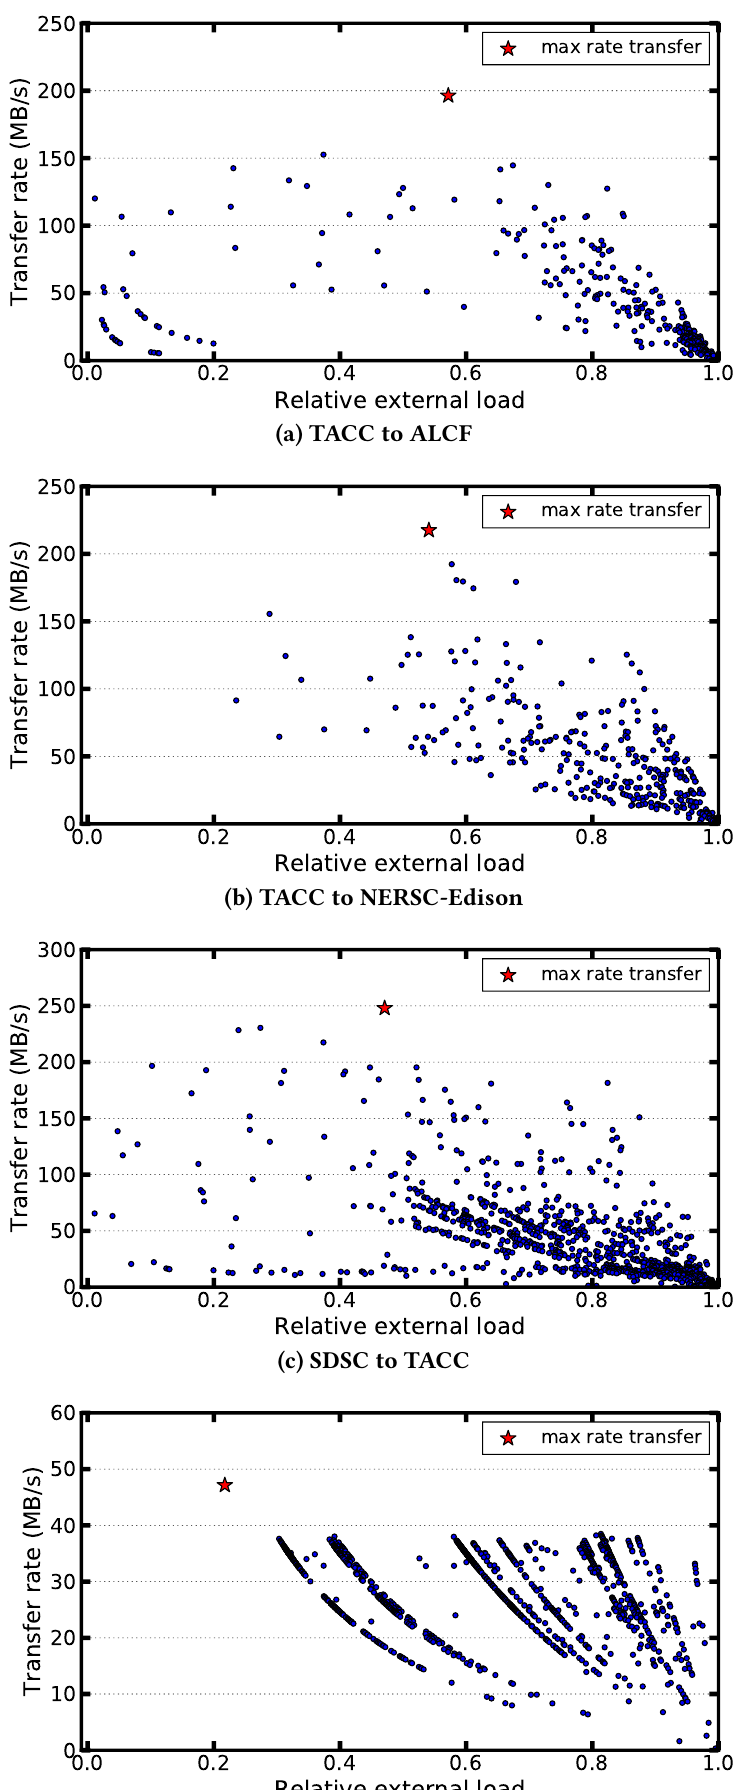
ESnet の 4 つの edge では、相対外部負荷が上がるとレートは単調に下がる(Figure 3)。
Figure 3: 相対外部負荷に対する転送レート(ESnet)。(a) ANL→BNL、(b) CERN→BNL、(c) BNL→LBL、(d) CERN→ANL。星は最大レートの転送。
ところが、TACC, ALCF, NERSC, SDSC, JLAB の edge では、最大レートが最小負荷の点では出ていない(NERSC-DTN→JLAB を除く)。
論文はその理由を、ログに現れない Globus 以外の競合(他ツールの転送、他のタスクのストレージ利用、他のネットワークトラフィック)と推測する。
この情報は得られないので、論文は edge ごとの最大レート Rmax(E) の T 倍(既定 T=0.5)未満の転送を、データから除く。
高い割合のレートが出た転送は、未知の競合負荷が小さいはずだ、という仮説に基づく。
論文自身が、この方法は理想的でないと述べている。
小さいファイルなど、転送の性質で遅くなった転送も除かれうるからである。
Figure 8: 相対外部負荷に対する転送レート。主要な端点を含む 4 つの edge。(a) TACC→ALCF、(b) TACC→NERSC-Edison、(c) SDSC→TACC、(d) NERSC-DTN→JLAB。
並行度と転送の大きさの影響(§4.1, §4.2)
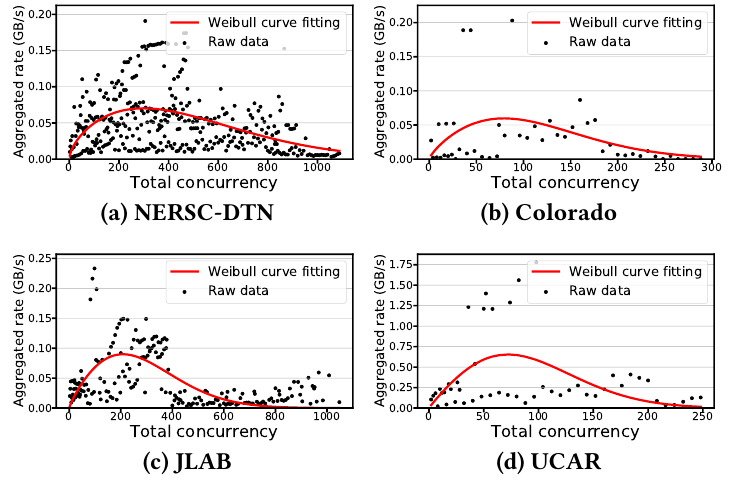
並行度と並列度は転送レートに大きく効くが、動的なネットワークで調整するのは難しい。 さらに、同じ端点を使う他の転送の並行度の影響も受ける。 論文は 4 つの端点で、端点全体の総並行度が増えると、合計レートが最初は増え、やがて減ることを示す(Figure 4)。 曲線は Weibull 分布で近似している。
Figure 4: 端点の総並行度(GridFTP サーバのインスタンス数)に対する、受信の合計レート。(a) NERSC-DTN、(b) Colorado、(c) JLAB、(d) UCAR。Weibull 曲線で近似。
転送の大きさについて、論文は次のように述べる。
開始時のコストのため、総サイズが比較的小さい転送は、大きい転送より低いレートになる。 (原文: Because of startup costs, a transfer with a relatively small total size achieves a lower rate than does a larger transfer.)
ファイル数が多い転送は調整のオーバーヘッドが増え、ディレクトリが多いと並列ファイルシステムでのロック競合でオーバーヘッドが増えうる、とも述べる。 ただし、この「開始時のコスト」を固定遅れとして測ったり、式にしたりはしていない。 論文が示す根拠は Figure 5 の観察だけである。
Figure 5 は、JLAB→NERSC という転送回数の多い 1 本の edge を使う。 転送を総バイト数で 20 グループに分け、各グループをさらに平均ファイルサイズの中央値の上下で 2 つに分ける。 読み取れることは次の 2 つである。
- 総バイト数が大きいグループほど、平均レートが高い傾向がある。
- 同じ総バイト数のグループでは、平均ファイルサイズが大きいほうが高いレートを出す。
この edge の平均レートは 0〜9 MB/s の範囲である(縦軸)。 総バイト数の軸は 0〜91 GB で、小さい側(数十 MB など)の転送は、このバケツの中に分けて描かれていない。 グループ間で平均ファイルサイズが揃っていないため、異なる総バイト数のバケツ同士の棒の比較は、必ずしも正確でないと論文自身が断っている。
Figure 5: ファイルの性質と転送性能(JLAB→NERSC の 1 edge)。総バイト数のバケツごとに、平均ファイルサイズが上位 50%(赤)と下位 50%(黄)の平均レート。
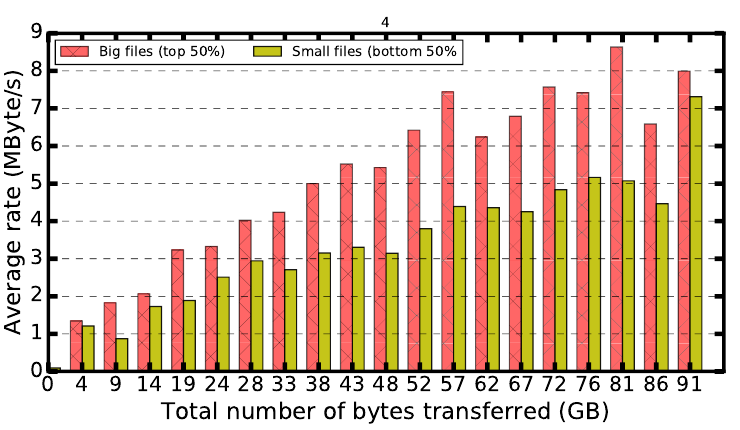
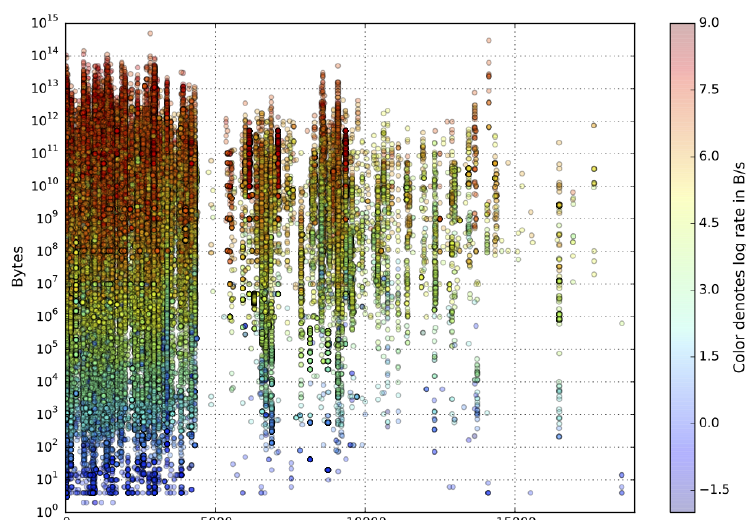
Figure 6 は、全 edge の転送を、転送サイズ(1 バイトから約 1 PB)と推定距離(大圏距離、下限)にプロットし、色でレートを示す。 論文は、レートが転送サイズと距離にある程度相関し、大陸内と大陸間で明確な違いがあると述べる。
Figure 6: 転送サイズと推定転送距離の関係。色は転送レート(log)。
回帰モデル(§5)
15 個の特徴量はゼロ平均・単位分散に正規化してから使う。
線形回帰(式 3, 4)は、Ri = β0 + β1 xi1 + … + βm xim を、残差二乗和の最小化で当てはめる。
edge ごとに別のモデルを作る。
対象は、Rmax の 0.5 倍を超える転送が 300 件以上ある 30 edge である。
この 30 edge の転送は 30,653 件(2,053 TB、4,660 万ファイル)で、これらの edge の生ログの 46.5% にあたる。
各 edge で 70% を学習に、30% をテストに無作為に分ける。
C と P は、ログ上でほとんど変動しないので、すべての edge で分散が小さく除外された(Figure 9 の赤い×)。
非線形モデルは、勾配ブースティングの実装 XGBoost(XGB)を使う。 Pearson 相関より最大情報係数(MIC)が大きい特徴量が複数あり(Table 5)、非線形な依存が示唆される。 これが XGB を使う動機である。
| 項目 | 内容 |
|---|---|
| 手法 | 線形回帰(LR)と XGBoost(XGB) |
| 対象 | 30 edge の、Rmax の 0.5 倍超の転送 |
| 分割 | 各 edge で、無作為に学習 70%・テスト 30% |
| 指標 | MdAPE(下記) |
MdAPE(median absolute percentage error)は、論文の名称どおり「予測の絶対パーセント誤差の中央値」である。 論文は数式を示していない。 図では「相対誤差」(Figure 10 の縦軸)も併用している。
Figure 9: 線形モデルでの特徴量の相対的な重要度(30 edge × 15 特徴量)。円の大きさが重要度、赤い×は低分散のため除外。edge 間では比較できない。
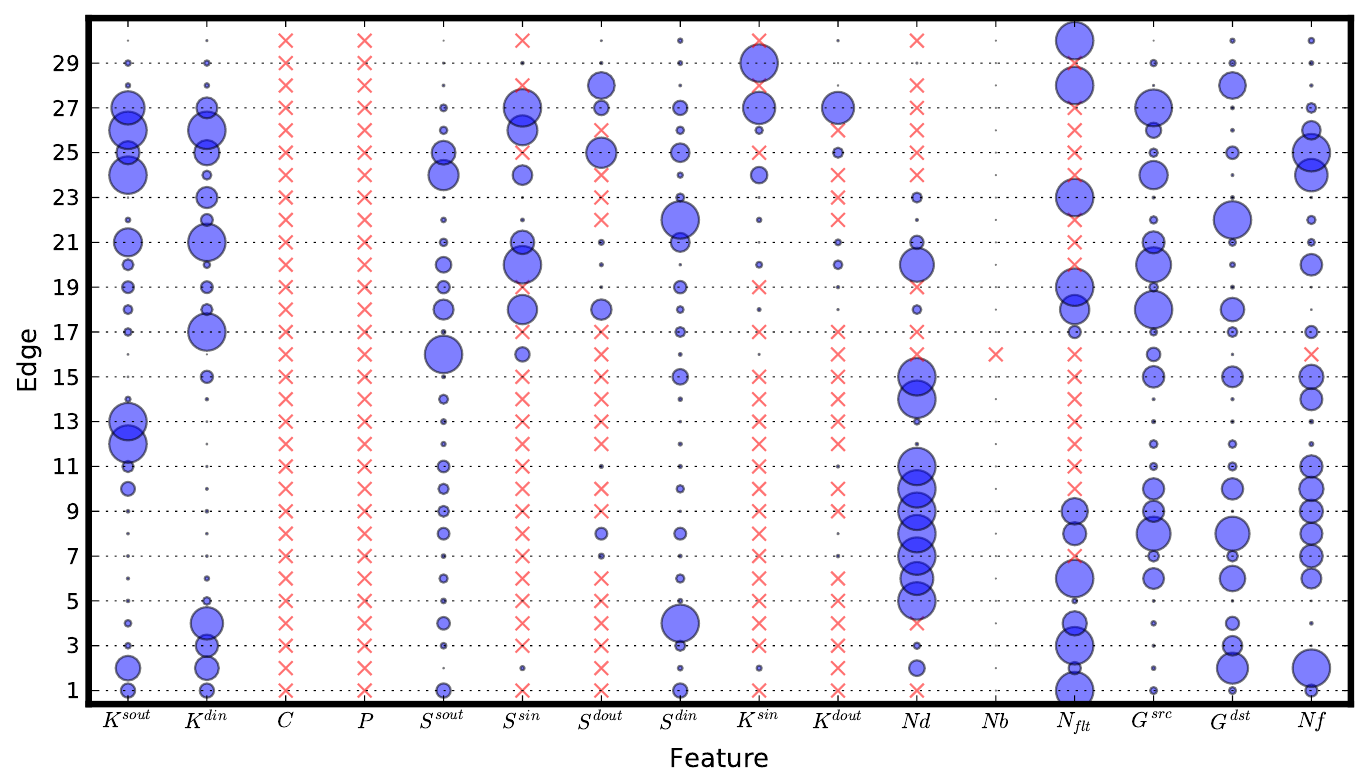
Figure 10: 線形回帰(左のバイオリン)と XGB(右)の予測誤差の比較(edge ごと)。
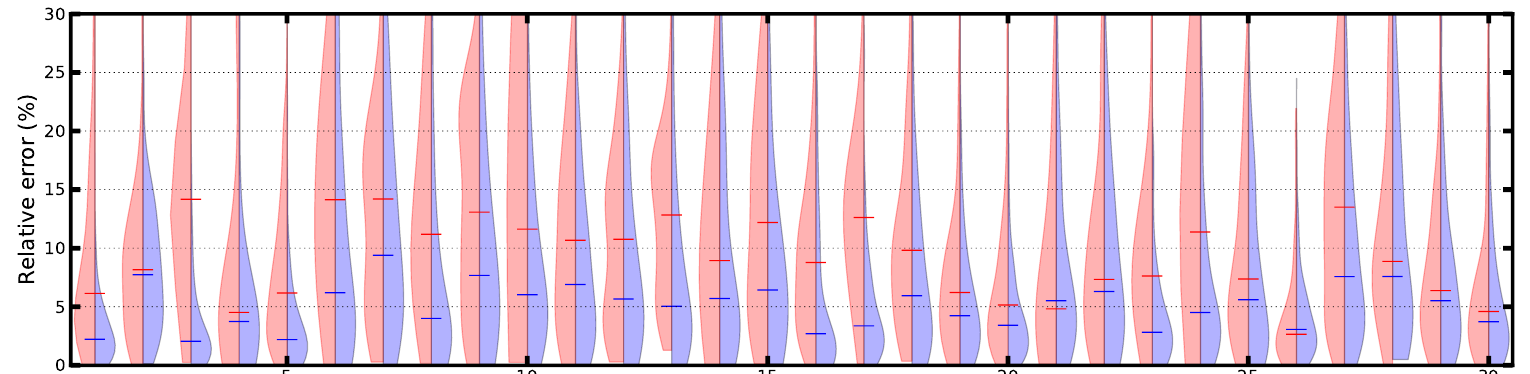
Figure 11: edge ごとの線形回帰と XGB の MdAPE と、使ったサンプル数。
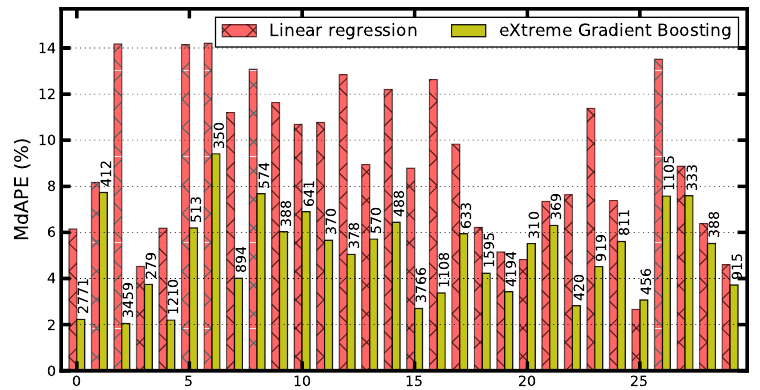
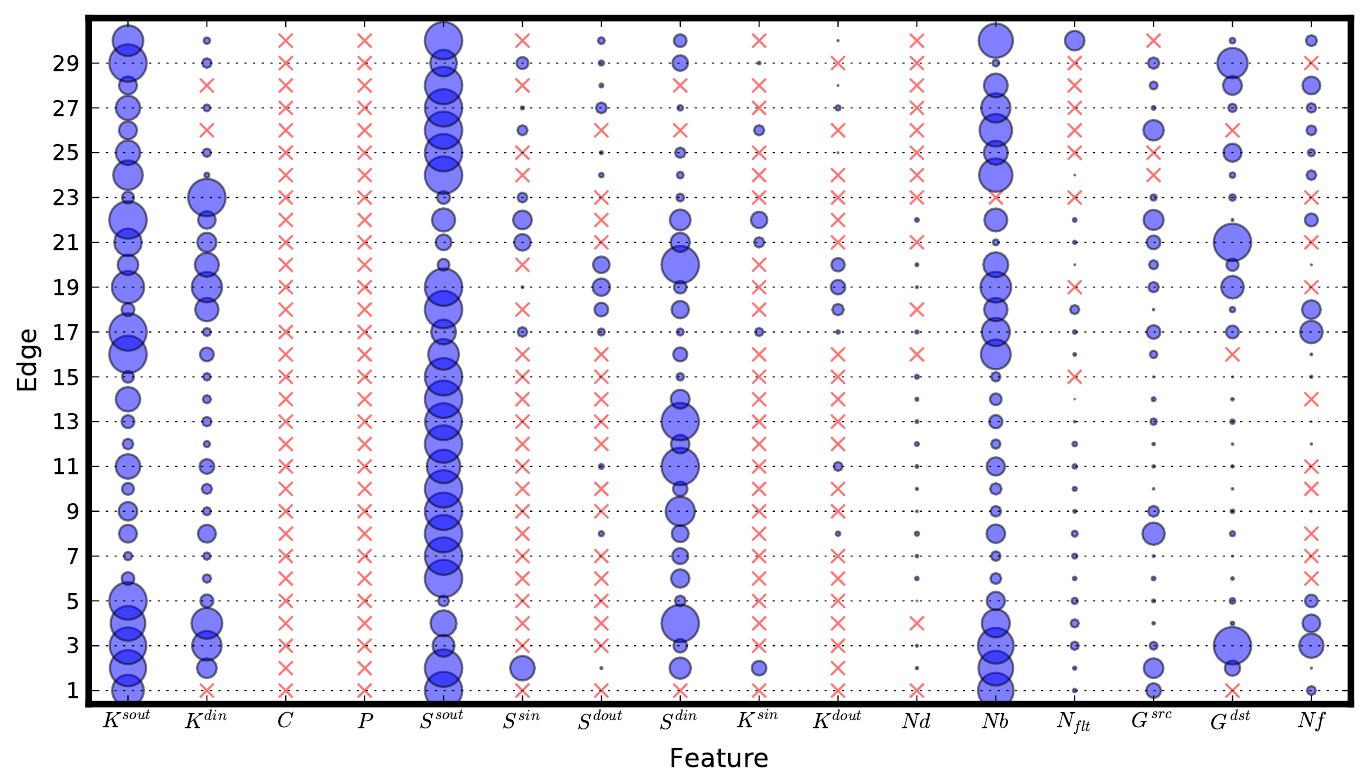
Figure 12: XGB モデルでの特徴量の相対的な重要度(30 edge)。
全 edge で 1 つのモデル(§5.4)
edge ごとの差を、端点ごとの 2 つの特徴量で吸収する。
端点 E の最大送出レートと最大受信レートを、ログから次のように定める。
ROmaxE = max_{x∈SrcE} ( Rx + Ksout(x) )
RImaxE = max_{x∈DstE} ( Rx + Kdin(x) )
Ri = β0 + β1 xi1 + … + βm xim + β(m+1) ROmax_si + β(m+2) RImax_di   (式5)
SrcE は E を送信元とする転送の集合、DstE は宛先とする転送の集合である。
si, di は転送 i の送信元と宛先である。
端点の NIC 容量や CPU、ストレージ帯域が不明なので、ログから得た最大レートで代用している。
式 6 は、これを 30 edge 全体の N 件で最小二乗法により当てはめる定義である。
実験・結果
予測精度
| モデル | 範囲 | MdAPE | 出典 |
|---|---|---|---|
| 線形(edge ごと) | 30 edge | 7.0% | 要旨、結論 |
| XGB(edge ごと) | 30 edge | 4.6% | 要旨、結論 |
| 式 5 の線形(全 edge で 1 つ) | 30,653 件 | 19% | §5.4 |
| XGB(全 edge で 1 つ) | 30,653 件 | 7.8%(要旨・結論)/ 4.9%(§5.4 本文) | 要旨と本文で値が異なる |
全 edge で 1 つの XGB の値は、要旨・結論が 7.8%、§5.4 本文が 4.9% で、論文の中で食い違っている。 論文は理由を述べていない。 引用するときは、どちらを使うかを明示する必要がある。
XGB は、ほとんどの edge で LR より誤差が小さい(Figure 10, 11)。
論文は、特徴量とレートの関係が非線形であることを示す結果だと解釈している。
一方、フォールト数 Nflt は線形モデルでは重要だが、XGB ではずっと重要度が低い。
論文は、フォールトが高負荷のときに起きるため、非線形モデルが負荷の関数でフォールトの影響を吸収したのだろう、と推測している。
未知の負荷を減らす/無くす(§5.5)
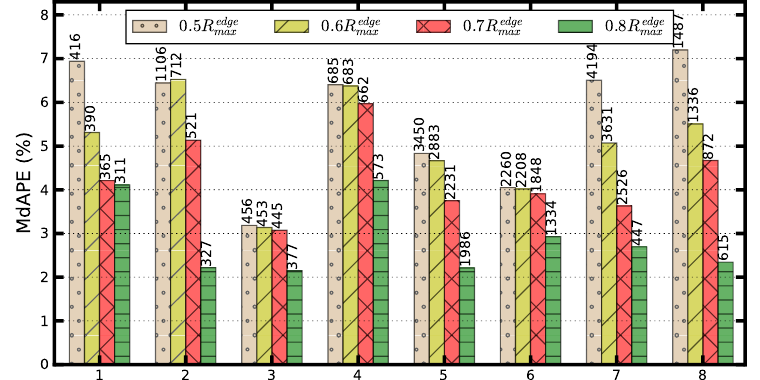
- しきい値を上げる: 学習に使う転送を
Rmaxの 0.5, 0.6, 0.7, 0.8 倍以上に絞ると、誤差は概して下がる(Figure 13、0.8 倍で 300 件以上ある 8 edge)。ただし、データ数は減る。なお、Figure 13 のキャプションは「線形モデル」だが、本文 §5.5.1 は XGB を適用したと書いており、記述が揃っていない。 - 未知の負荷を測る: NERSC の 2 つの Lustre ファイルシステム間で、同時に 10 本の Globus 転送を流し続けた状態で、666 回のテスト転送を行った。Lustre Monitoring Tool で 5 秒ごとに OST のディスク I/O と OSS の CPU 負荷を測る。既存の 15 特徴量だけの 95 パーセンタイル誤差は 9.29%、ストレージ負荷の 4 特徴量を足すと 1.26% になった。ただし、この実験は転送の性質(
Nb,Nf,Ndir)が全転送で同じで、NERSC 内部だけの転送なので、ネットワーク競合は扱っていない。
Figure 13: 学習に使う転送の Rmax しきい値を変えたときの MdAPE(8 edge)。各棒の上の数字はデータ数。
関連研究との関係
- 論文は、Vazhkudai and Schopf と Lu et al. を、ネットワーク・ディスク・アプリの個別の性能データに依存するモデルとして挙げる。Kim et al. と Arslan et al. は実時間のプロービングに依存するモデルとして挙げる。Kettimuthu et al. は外部負荷を考慮するが、本論文ほど広くは扱っていない、とする(書誌は論文の参考文献を参照)。
- §7 で、使った特徴量(TCP 数、プロセス数、データサイズ、ファイル数、競合負荷)は FTP、rsync、scp、bbcp、FDT、XDD にも一般化できると述べる。ただし、これは論文の期待であり、他ツールでの検証は無い。
- このリポジトリの既存ノートとの直接のつながりは無い。
限界(論文の記述に基づく)
- 評価の対象は 30 の頻繁に使われる edge と、
Rmaxの 0.5 倍以上の転送に限られる。 - 論文は、Globus 以外の競合負荷を観測できないことを限界として認めている。
- 全 edge で 1 つのモデルを作るときは、RTT の情報が無い。論文は今後 RTT を足すと述べる。
Q&A
自分のコメント
- 対象は広域の disk-to-disk 転送で、単一ホストの NFS ではない。ElasticKernel-GPU の issue #46(コストモデルの妥当性評価)で使うときは、NFS 書き込み帯域の予測根拠ではなく、転送サイズが小さいほど実効レートが低いことを示す第三者の記述として扱う。
- 「開始時のコスト」は §4.2 に 1 文あるだけで、固定遅れの値は測られていない。Figure 5 は 1 本の edge の観察で、総バイト数の軸も 0〜91 GB と大きい側しか見えない。ElasticKernel の 8 MB 程度の書き込みに当てはまるかどうかは、この論文からは言えない。
- この論文の手法は、過去ログから学習する方式である。「少ない測定で帯域曲線を決める」手法ではない。事前測定と実行時測定の判断材料としては、むしろ「ログがあれば測らずに済む」という対極の選択肢の例になる。
- 全 edge 1 モデルの XGB が、要旨の 7.8% と本文の 4.9% で食い違う。引用するなら要旨の数字を使い、本文の数字との差を注記する。