AI解説
arXiv: https://arxiv.org/abs/1411.2429(v2, 2016-01-19, 22 pages / 8 figures / 9 tables) 情報源: arXiv v2 の PDF の全文(本文・図・表 I〜IX・脚注)を精読した。参考文献の中身と、論文が公開するオンライン付録は読んでいない。 この版は ACM の組版テンプレートのままで、巻号欄が
Vol. V, No. Nのプレースホルダである。TOIT 16(3) の出版版は読んでいない。venueと巻号は、DOI 10.1145/2885497 の Crossref 登録情報(ACM TOIT, vol. 16, issue 3, 2016-04-19)で確認した。 図について: 2014 年の論文で arXiv HTML 版が無いため、図はすべて PDF のページから切り出した画像である(figures/)。Figure 1, 2〜4, 5, 6, 7, 8 の全 8 枚を貼った。Figure 4 は Figure 2 と 3 をまとめた見出しなので、1 枚の画像に並べた。 図番号とキャプションは原論文に対応する。表は画像にせず、本文に数値を書き起こした。AI 生成の補足図は付けていない。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+robots.txtで検索除けされている。
一言で
公開 IaaS クラウドの性能が、どの要因で、どれだけ変動するかを調べた研究である。 先行文献から 15 個の仮説を作り、EC2・GCE・Azure・SoftLayer の 4 社で 2014〜2015 年に集めた 53918 件の測定で検証した。 ディスク IO の性能は、EC2 と Azure で相対標準偏差が 20〜94% に達し、GCE と SoftLayer では 1〜13% に収まった。 ハードウェアの不均一性は先行研究の報告より小さく、時刻や曜日の影響は見つからなかった。 リージョンの影響は、統計的に有意だった。
背景・問題
解くべき問題
クラウドの性能測定の論文は多い。 しかし論文は、そこから使える知見を取り出すのが難しい理由を 3 つ挙げる。
- 結果に効くパラメータや生データが公開されておらず、同じ実験が食い違う結果で報告されている。食い違いの原因が、提供者の性能の経時変化なのか、未報告のパラメータなのか、測定の不正確さなのか、読者には判別できない。
- 論文が先行研究の結果と比較せず、毎回ゼロから始める。
- 2010 年に出た結果が今も成り立つのかが分からない。クラウド提供者は互いに競って改善を続けるので、測定対象は動く的である。
課題
論文の課題は、IaaS の性能変動の規則・パターン・仕組みを特定することである。 特に注目するのは予測可能性である。 論文の定義では、IaaS から取得した仮想マシンの性能を事前にどれだけ正確に見積もれるか、およびその性能がどれだけ安定しているかを指す。
進め方は 2 段階である。
- 体系的な文献調査で既存研究の結果を整理し、15 個の仮説にまとめる。
- 4 社のクラウドで実測し、仮説を検証する。
用語
- インスタンス: IaaS で取得する仮想マシン。リージョン、ベースイメージ、インスタンスタイプで構成を指定する。
- ハードウェア不均一性: 同じインスタンスタイプでも、裏の物理ハードウェアが異なること。
- マルチテナンシー: 複数の顧客のインスタンスが同じ物理マシン上で動くこと。ネットワークやディスク IO のような資源は、同じマシン上のインスタンスで共有される。他の借り手の挙動で遅くなる現象を、論文は noisy neighbour 問題と呼ぶ。
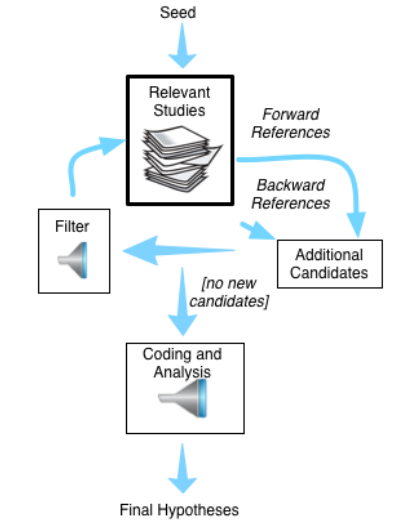
Figure 1: 文献調査の手順。種となる論文から前方・後方の引用をたどって候補を増やし、フィルタをかけて関連研究に加える。新しい候補が出なくなるまで繰り返し、残った集合をコーディングして 15 個の仮説にまとめる。
仮説(先行研究から作った 15 個)
仮説は 4 群に分かれる。 論文はこれらを「既存文献が主張している内容」として置き、実測で検証する。
| 群 | 仮説 | 内容 |
|---|---|---|
| H1 インスタンス間の予測可能性 | H1.1 | 同じ構成のインスタンスでも性能は有意にばらつく |
| H1.2 | CPU 律速の処理は、割り当てられた CPU モデルに強く依存し、ばらつきの主因はハードウェア不均一性である | |
| H1.3 | IO 律速の処理は、同居する他テナントの挙動に強く依存する | |
| H2 インスタンス内の変動 | H2.1 | IO 律速の処理は、同じインスタンスの中でも有意に変動する |
| H2.2 | CPU 律速の処理は、CPU を専有するインスタンスでは同一インスタンス内で変動しない | |
| H2.3 | バースト型のインスタンスタイプは、どの処理でも同一インスタンス内で変動する | |
| H3 時間・地理 | H3.1〜H3.4 | 時刻と曜日が、性能(H3.1, H3.3)と予測可能性(H3.2, H3.4)に影響する |
| H3.5, H3.6 | リージョンが、性能(H3.5)と予測可能性(H3.6)に影響する | |
| H4 インスタンスタイプ選択 | H4.1 | 高価なタイプほど、価格あたり性能が下がる |
| H4.2 | 高価なタイプほど、性能が安定する | |
| H4.3 | 特化型タイプは、特化した用途で価格あたり性能が良く、それ以外では悪い |
実験の方法
ベンチマーク
5 種類のベンチマークを使う(Table II)。 CPU 律速が CPU・MEM・Java、IO 律速が IO・OLTP である。
| 名前 | 内容 | 単位 |
|---|---|---|
| CPU | sysbench で 20000 までの自然数の素数判定にかかる時間を測る | 秒(小さいほど良い) |
| MEM | mbw で 64 MiB の配列 2 本を確保し、一方をもう一方へコピーする。これを 50 回行い、平均のメモリ帯域を測る | MiB/s |
| Java | jCloudScale(中規模の Java プロジェクト)を clone し、OpenJDK 7 でコンパイルして全体の所要時間を測る | 秒 |
| IO | sysbench で 5 GByte のファイルを 3 分間、繰り返し読み書きし、読み書きを合わせた平均のディスク帯域を測る | Mb/s(論文の表記) |
| OLTP | sysbench で 10000 行の MySQL に対し 3 分間 SQL を繰り返し実行し、平均の毎秒クエリ数を測る | Query/s |
IO ベンチマークは、インスタンスのディスクに対する sysbench のファイル読み書きである。
NFS などのネットワークファイルシステムは測っていない。
論文は、測定先のディスクがローカルか、ネットワーク接続のブロックストレージかを書いていない(本文に該当する記述が無い)。
単位は表では Mb/s と書かれている。論文はメガビットかメガバイトかを説明していない。
OS は EC2・Azure・SoftLayer で Ubuntu 14.04 LTS、GCE で Debian 7 である。 OLTP と MEM は EC2 だけで実行した。OLTP は IO との相関が強く、MEM は CPU との相関が強いので、他社で重ねて測る必要は無いと判断したためである。
2 種類の実験
論文は測り方の異なる 2 つの実験を行い、それぞれ別の指標で集計する。 この 2 つの数値は混ぜて比べてはいけない。
| 隔離テスト(isolated) | 連続テスト(continuous) | |
|---|---|---|
| 手順 | 指定のインスタンスタイプを取得し、ベンチマークを準備し、3 回連続で実行して、すぐにインスタンスを解放する | インスタンスを取得し、1 時間に 1 回ベンチマークを実行する。これを 72 回(3 日間)続けてから破棄する |
| 繰り返し | 82 構成を 1 日 6 回、約 1 か月。EC2 と GCE は 2014 年 7〜8 月、Azure と SoftLayer は 2015 年 6〜7 月 | 33 構成で、各構成 15 インスタンス |
| 件数 | 42371 件 | 11547 件 |
| 見ているもの | 別々のインスタンスのあいだのばらつき(毎回インスタンスを取り直すため) | 同じインスタンスの中の時間変動 |
| 指標 | cRSD = 構成内の全測定の標準偏差 ÷ 平均 × 100(%) |
iRSD = 1 インスタンス内の標準偏差 ÷ 平均 × 100(%)。構成ごとに 15 インスタンスの iRSD を算術平均したものが clRSD(Table VI) |
どちらの指標も相対標準偏差(標準偏差を平均で割った値、%)である。 論文は、相対標準偏差が 5% を超えると、ほとんどの用途で無視できないばらつきだと仮定している。 測定件数は合計 53918 件である(Table III。EC2 24795、GCE 11597、Azure 12401、SoftLayer 5125)。
隔離テストの cRSD は、同じ構成の全インスタンスの測定を 1 つの集合にして計算する。
この集合には、インスタンスごとの性能差と、各インスタンス内の変動の両方が入る。
論文はこの 2 つを分けて報告していない(連続テストの clRSD が、インスタンス内の分だけを与える)。
結果
H1: インスタンス間のばらつき(隔離テスト, Table IV)
82 構成のうち 63 構成で cRSD が 5% を超えた。
論文は H1.1 を支持されたと結論する。
IO ベンチマークの cRSD(Table IV, %)
| 提供者 | 構成ごとの値 | 範囲 |
|---|---|---|
| EC2 | eu: t1.micro 71.33, m1.small 88.49, m3.large 35.53, c3.large 58.88, i2.xlarge 20.07 / na: t1.micro 70.08, m1.small 94.47, m3.large 49.02 | 20.07〜94.47 |
| Azure | eu: ExtraSmall 61.92, Small 59.01, Medium 47.14 / na: ExtraSmall 49.01, Small 44.01, Medium 48.31 | 44.01〜61.92 |
| GCE | eu: f1-micro 3.06, n1-standard-1 3.36, n1-standard-2 1.33 / na: f1-micro 9.47, n1-standard-1 10.39, n1-standard-2 4.88 | 1.33〜10.39 |
| SoftLayer | na: 1 CPU/2048 MB 13.01, 2 CPUs/4096 MB 6.27 | 6.27〜13.01 |
対象は、2014 年(EC2・GCE)と 2015 年(Azure・SoftLayer)のインスタンスのディスクで、NFS ではない。
論文が挙げる観察は次の 4 点である。
- EC2 と Azure の IO(EC2 の OLTP も、程度は小さいが同様)はほとんど混沌としており、GCE と SoftLayer では同じベンチマークがはるかに予測しやすい。
- EC2 の us-east-1 の t1.micro は最も予測しにくく、全ベンチマークで
cRSDが 20% を超えた。 - IO 律速の 2 つ(IO, OLTP)は、EC2 と Azure で、CPU 律速のものよりずっと予測しにくい。SoftLayer と GCE ではこの差が小さい。
- CPU 律速のベンチマークは、Azure と、EC2 のバースト型(t1.micro)を除いて、おおむね予測しやすい。
ハードウェア不均一性は小さい(H1.2, H1.3)
GCE の VM は、実ハードウェアに関係なく標準の Intel CPU を名乗る。 EC2 は m3.large・c3.large・i2.xlarge に、固定の CPU モデルを割り当てる(論文の記述では AWS が保証している)。 SoftLayer も構成ごとにハードウェアが決まっている。 不均一性が理論上ありうるのは EC2 の t1.micro と m1.small だけで、eu-west-1 の m1.small でも 97% 以上の実行が同じ CPU モデルだった。 Azure だけが、全インスタンスタイプで幅広い CPU モデルを使う。 このため、CPU 律速のベンチマークのばらつきは Azure を除いて小さい。
不均一性が実際にあった構成(EC2 m1.small と Azure Small、北米)について、CPU モデルを固定して cpu_RSD を再計算したのが Table V である。
CPU 律速のベンチマークでは cpu_RSD がさらに下がり、H1.2 が支持される。
IO では、CPU モデルを固定しても下がり方がずっと小さい。
| EC2 m1.small(na)CPU モデル | 件数 | IO の cpu_RSD(%) |
|---|---|---|
| Intel E5-2650 | 1962 | 88.4 |
| Intel E5430 | 364 | 31.53 |
| Intel E5645 | 293 | 22.82 |
| Intel E5507 | 84 | 21.02 |
| Intel E5-2651 | 32 | 2.27 |
最も件数の多い E5-2650 では、CPU モデルを固定しても IO の cpu_RSD は 88.4% のままである。
論文はこの結果を H1.3(IO のばらつきの主因は同居テナントであり、ハードウェアを知っても予測可能性はあまり上がらない)の支持と解釈する。
ただし論文は、同居テナントの状況を直接観測してはいない。マルチテナンシーが原因だという結論は、ハードウェア要因を除いてもばらつきが残ることからの解釈である。
H2: 同一インスタンス内の変動(連続テスト, Table VI)
clRSD(%)。1 時間ごとに 72 回、15 インスタンスの iRSD の平均。いずれも eu(SoftLayer のみ na)
| 提供者 | 構成 | CPU | MEM | IO |
|---|---|---|---|---|
| EC2 | t1.micro | 40.17 | 40.86 | 22.78 |
| m1.small | 1.69 | 1.66 | 27.28 | |
| m3.large | 0.89 | 0.49 | 17.92 | |
| GCE | f1-micro | 3.24 | 6.85 | 2.65 |
| n1-standard-1 | 0.76 | 2.43 | 4.42 | |
| n1-standard-2 | 0.86 | 2.01 | 1.46 | |
| Azure | ExtraSmall | 2.41 | 3.39 | 27.08 |
| Small | 1.65 | 2.33 | 93.47 | |
| Medium | 1.30 | 1.98 | 0.14 | |
| SoftLayer | 1 CPU / 2048 MB | 0.22 | 0.39 | 2.94 |
| 2 CPU / 4096 MB | 0.13 | 0.14 | 2.25 |
対象は 2014 年(EC2・GCE)と 2015 年(Azure・SoftLayer)のインスタンスのディスクである。NFS ではない。
論文の結論は次のとおりである。
- CPU 律速のベンチマークは、バースト型でないインスタンスタイプなら、全提供者で同一インスタンス内の変動が非常に小さい(H2.2 が全提供者で支持)。
- IO は EC2 と Azure で変動し、GCE と SoftLayer では非常に安定している。H2.1 は EC2 と Azure でのみ支持される。
- Azure の Small を除く全構成で、同一インスタンス内の変動は、同じ構成の別インスタンスのあいだの変動より小さい。
- EC2 の t1.micro は、特に CPU 律速のベンチマークでも大きく変動する。GCE はバースト型の f1-micro でも安定している。H2.3 は EC2 でのみ支持される。
Azure の IO で、Small(93.47%)と Medium(0.14%)が大きく離れている点は、論文がこの表の範囲では説明していない。
Figure 2 は、EC2 eu-west-1 の m3.large(同一構成)の 2 インスタンスの IO の時系列である。
インスタンス 9097 の平均 IO 帯域は、インスタンス 14704 のほぼ 2 倍である。
iRSD は 9097 が 12.25%、14704 が 30.12% で、どちらにも明確な増減の傾向は無い。
つまり、同じ構成でもインスタンスごとに速い・遅い、安定している・不安定という個性がある。
Figure 3 は CPU ベンチマークの時系列である(値が小さいほど高性能)。
m1.small(インスタンス 12978)は、iRSD が 0.57% でほとんど変動しない。
t1.micro(インスタンス 12544)は iRSD が 34.82% で、時間とともに遅くなる。
論文はこれを、クレジット制のバースト型で、測定中にクレジットを回復させる時間を与えなかったためと説明している。
t1.micro は、クレジットが尽き始めるまでは m1.small より速い。
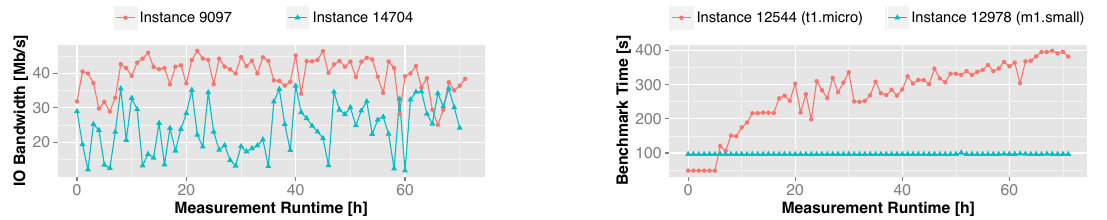
Figure 4(Figure 2 と 3 の合成): 左(Figure 2)は EC2 eu-west-1 の m3.large 2 インスタンスの IO 帯域 [Mb/s] の 72 時間の時系列。インスタンス 9097 は平均が高く、14704 は低く大きく振れる。右(Figure 3)は同リージョンの t1.micro(12544)と m1.small(12978)の CPU ベンチマーク時間 [s]。t1.micro は時間とともに遅くなる。
H3: 時刻・曜日・リージョン
隔離テストのデータを、曜日(月〜日)と 4 時間枠(0:00〜3:59 が枠 1)に分けて比べた。 目視では、絶対性能にも予測可能性にも、時刻と曜日の影響を示す強い兆候が見つからなかった。
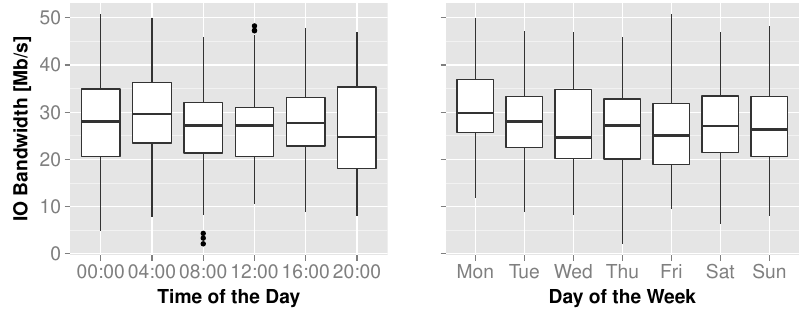
Figure 5: EC2 eu-west-1 の m3.large の IO 性能を、時間帯別(左)と曜日別(右)に並べた箱ひげ図。時間帯や曜日による系統的な差は見えない。
統計検定は、各構成で時間枠の全ペア(15 組)と曜日の全ペア(21 組)を比べ、計 2460 個(時間枠)と 3444 個(曜日)の p 値を出した。 データが正規分布でないため、性能の差には Wilcoxon の符号順位検定、ばらつきの差には Levene の分散検定を使い、Holm 補正をかけ、有意水準は 0.01 とした。 Table VII の集計では、有意差が出たペアは、性能の比較(H3.1, H3.3)で 3.92〜9.55%、ばらつきの比較(H3.2, H3.4)で 7.32〜24.4% だった。 大半のペアで有意差は出ず、有意だったペアにも系統性が見つからなかったため、論文はそれらを統計的な偶然や外れ値だと見なし、H3.1〜H3.4 は支持されないと結論した。
一方、リージョンでは結果が異なる(Figure 6, Table VIII)。 有意差は、性能(H3.5)で 33 構成中 26、予測可能性(H3.6)で 33 構成中 23 に出た。 EC2 の m3.large では、us-east-1 のほうが eu-west-1 より、性能が低く、ばらつきが大きい傾向だった。 論文は、これが欧州リージョンの価格が北米よりやや高いことと整合するかもしれないと述べる(推測として)。 EC2 の OLTP と Azure の CPU では、有意差が一貫して見つからなかった。Azure のリージョン差は EC2 より小さい。
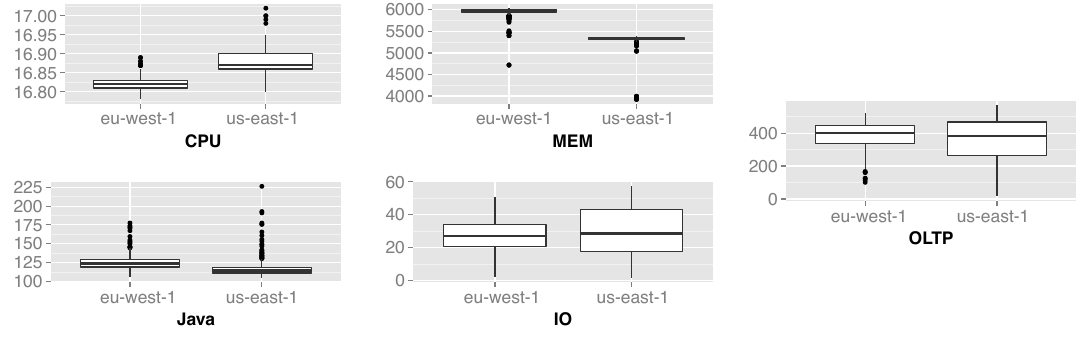
Figure 6: EC2 の m3.large の各ベンチマーク(CPU, MEM, OLTP, Java, IO)の性能分布を、eu-west-1 と us-east-1 で比べた箱ひげ図。CPU と Java は小さいほど良い。
H4: インスタンスタイプの選択
性能と価格の比を cpr(cost-performance ratio)とし、各提供者・リージョン・ベンチマークで、small 型の値を 1 に正規化した。 1 未満なら small 型より費用効率が悪く、1 超なら良い。 この値は、提供者・リージョン・ベンチマークをまたいで比べられない。
- H4.1(高価なほど価格あたり性能が悪い)は Azure と SoftLayer でのみ支持された。EC2 と GCE では、m1.small と n1-standard-1 が最も効率が悪いことが多い。
- H4.2(高価なほど安定する)は、CPU 律速のベンチマークの EC2 と GCE では支持された。IO 律速や他の 2 社では強い支持が無い。
- H4.3(特化型は特化用途で有利)は、CPU 最適化型の c3.large では、CPU 律速のベンチマークで少し良かった。IO 最適化型の i2.xlarge は、IO ベンチマークでも全タイプのなかで効率が悪かった。時間単価が高く、性能向上で相殺しきれないためである。
論文はここから、タイプ選択に決まった経験則は無く、使う用途で実測が必要だと結論する。
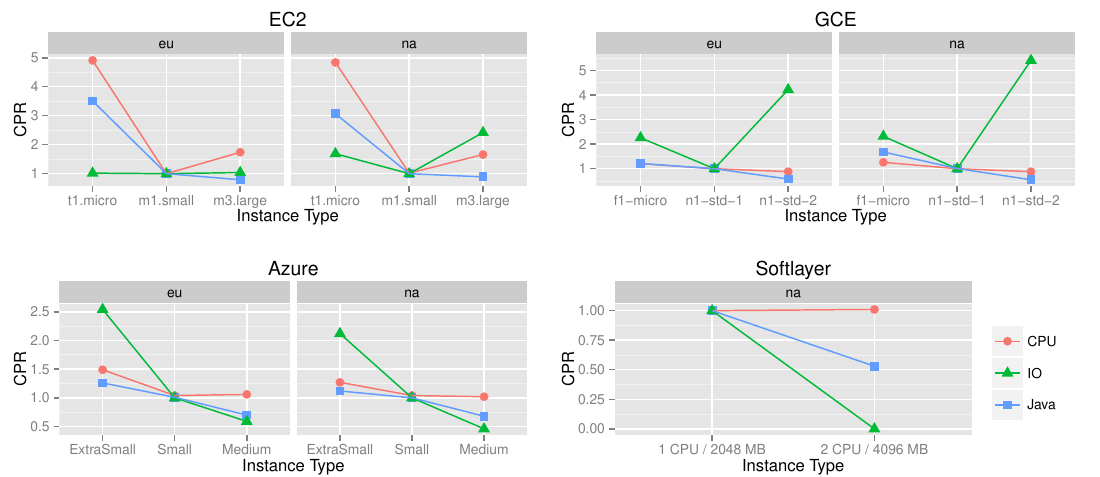
Figure 7: 提供者(EC2, GCE, Azure, SoftLayer)、リージョン、インスタンスタイプ、ベンチマーク(CPU, IO, Java)ごとの正規化したコスト性能比(CPR)。
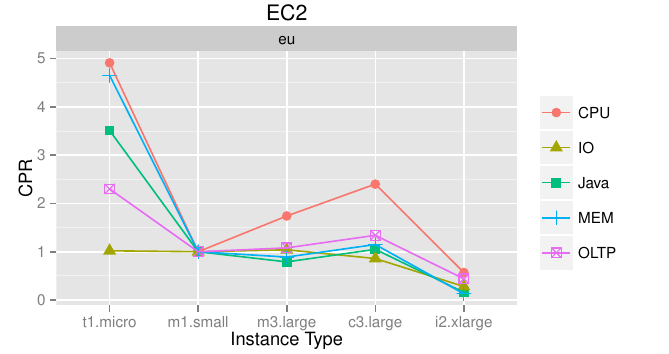
Figure 8: EC2 の欧州リージョンで、全ベンチマーク(CPU, IO, Java, MEM, OLTP)について、t1.micro から i2.xlarge までの CPR を並べたもの。
論文の結論(Implications)
論文が結論として挙げる点を、そのまま整理する。
- 提供者による差が大きい。 EC2 と Azure は先行研究の予想どおりに振る舞い、GCE と SoftLayer はそれよりずっと安定していた。論文は、EC2 の測定に研究が偏りすぎていると述べ、他の提供者でも既存の結果を検証すべきだと主張する。
- ハードウェア不均一性は、先行研究の報告より小さい。 論文は理由を推測しかできないとし、提供者が価格に見合う安定性を出すよう商業的に圧力を受けたからではないか、と述べる。Azure だけが全インスタンスタイプで不均一性を採用していた。
- マルチテナンシーは重要だが、提供者によって影響が異なる。 EC2 と Azure では IO 律速の全ベンチマークが非常に予測しにくく、GCE と SoftLayer は IO でもかなり予測できた。論文は、前者のインフラ利用率が高いからではないかと推測している。
- リージョンは効き、時刻と曜日は効かない。
- インスタンスタイプの選択に経験則は無い。
測定対象が動く的であるため、科学コミュニティは定期的に理解を再検証する必要があると論文は述べる。
妥当性への脅威(論文の自己評価)
- 内部妥当性: データ収集が比較的短期間だった。夏の EC2 の高負荷のような外的要因が結果に影響した可能性がある。長期の研究が必要だと論文は書く。
- 外部妥当性: 提供者・タイプ・リージョン・設定の一部しか測っていない。ただし EC2 と Azure(市場のリーダー)、GCE(新興)、SoftLayer(ニッチ)を含むので、結論を支えるには十分だと論文は主張する。
- 構成の妥当性: 文献検索は種論文から引用をたどる方式なので、別分野の関連論文を取りこぼす恐れがある。ACM Digital Library で見つけた 10 本の論文が研究対象集合に含まれていることを確認して、この恐れを下げたと書く。ベンチマークは、既製のツールと設定を使い、最適化の偏りを避けた。
関連研究との関係
論文は、Li et al. による IaaS ベンチマーク研究の体系化(評価方法論、指標のカタログ、概念モデル)に触発されたと書く。 Li et al. は既存研究を分類するが、結果を要約・検証しない。本論文はそこを埋める。 本リポジトリに、これらの論文のノートは無い。
この論文は、ストレージ帯域のサイズ依存を扱わない。 測定は、5 GB のファイルを 3 分間読み書きする単一の条件だけである。
Q&A
自分のコメント
(以下は、ElasticKernel-GPU の issue #46 向け調査の一環で、別セッションの依頼により AI が書いた作業メモである。ユーザー自身の意見ではない。)
ElasticKernel の帯域コストモデルとの関係(作業メモ)
この論文は、帯域プローブの設計に使える材料と、使えない材料の両方を含む。
- 使える点(論文が示す事実): クラウドの IO 性能は、提供者によって相対標準偏差が 1〜94% と大きく変わる。同じ構成でも、インスタンスごとの性能差(隔離テストの
cRSD)が、同一インスタンス内の時間変動(連続テストのclRSD)より大きいことが多い。時刻と曜日の系統的な影響は、論文の範囲では見つからなかった。 - 使えない点: 対象は 2014〜2015 年のインスタンスのディスクで、NFS ではない。測定条件も、5 GB の読み書きを 3 分間という単一条件で、サイズ依存や頭打ちを調べていない。Azure(クラウド)から medaka(オンプレ)への NFS 書き込みのような、クラウドからオンプレへのネットワーク越しの経路は対象外である。
- 混ぜない: 隔離テスト(インスタンスを毎回取り直す、Table IV)と連続テスト(同じインスタンスを 3 日間、Table VI)は測り方が違う。例えば Azure の「IO が 44〜62%」は前者の値、「Small が 93.5%」は後者の値で、同じ土俵では比べられない。
- 推論(論文の主張ではない): 「インスタンス間の差が大きい」という知見を、そのまま「プローブを 1 回だけ測ると外れた値を引く確率が高い」に結びつけるには、測る対象(ローカルディスクか NFS か)の違いを考慮する必要がある。この結びつけは、論文の裏づけがない推論である。