AI解説
実装: https://github.com/zRollman/Autocheck.git 情報源: arXiv v3(2024-11-05)の全文(arXiv HTML 版)を精読して記述。本文に書かれていない事項は書いていない。arXiv 単独公開で、学会や論文誌への掲載は確認できていない。
一言で
HPC アプリケーションの実行トレースを解析して、チェックポイントすべき変数を自動で特定するツール。人手による変数選定が持つ「専門知識が要る」「巨大なコードのネストした依存関係を追うのは試行錯誤で誤りやすい」という問題に対し、動的命令トレースからデータ依存グラフ(DDG)を構築・縮約し、ヒューリスティックで臨界変数を絞り込む。14個の HPC ベンチマークすべてで正しく再開でき、システムレベルの BLCR と比べてチェックポイントサイズを最大7桁削減する。
背景・問題
Checkpoint/Restart(C/R)は HPC で最も広く使われる耐障害技術で、ほぼすべての本番 HPC システムや商用データセンターに標準搭載されている。FTI や VeloC のようなアプリケーションレベルの C/R ライブラリは強力だが、どの変数をチェックポイントすべきかはプログラマ自身が判断しなければならない。
この判断には二重の困難がある。プログラマは耐障害性の専門知識を持たないことが多く、逆にドメイン知識を持つ科学者側は耐障害性の専門知識を欠くことが多い。加えて実世界の HPC アプリケーションは、ネストした関数呼び出し、複雑なデータ構造、込み入ったデータ依存から成り立っており、変数選びは専門家にとってさえ試行錯誤にならざるを得ず、誤りや一貫性の欠如、主観的な解釈のばらつきを生みやすい。AutoCheck はこの「臨界変数の特定」を自動化することで問題を解こうとする、著者らの言葉では「この種として初めての」試みである。
提案手法
AutoCheck は動的命令実行トレースを入力とし、前処理、データ依存解析、臨界変数の特定という3つのモジュールから成る。
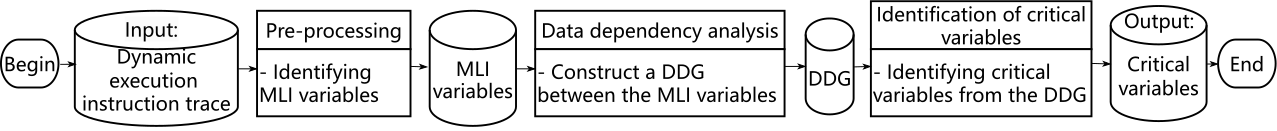
Fig. 2: AutoCheck design overview(3モジュールの全体構成)。
前処理 — Main-Loop’s Input(MLI)変数の特定
チェックポイント候補となる変数は、MLI 変数(main-loop’s input:主計算ループに入る前に定義され、ループ内で使われる変数)と、ループの帰納変数(induction variable)に限られる。ループ内だけで定義・使用されるローカル変数は毎回のイテレーションで再初期化されるためチェックポイント不要と判断される。
MLI 変数の特定は、主計算ループの前後それぞれで使われる算術変数(算術演算に関わる変数)を集め、両者を突き合わせることで行う。ポインタ代入が起きた場合は、代入先ではなく代入元の変数を再帰的にたどって収集する。
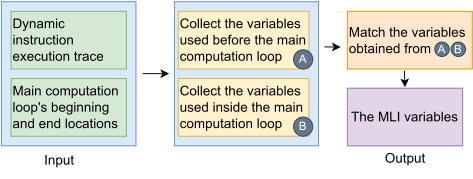
Fig. 3: Pre-processing workflow(算術変数の収集とマッチングの流れ)。
例えば次のようなコード(a、b を主計算ループ前に定義し、ループ内で sum、s、r を更新する)では、a、b、sum、s、r が MLI 変数として特定される。
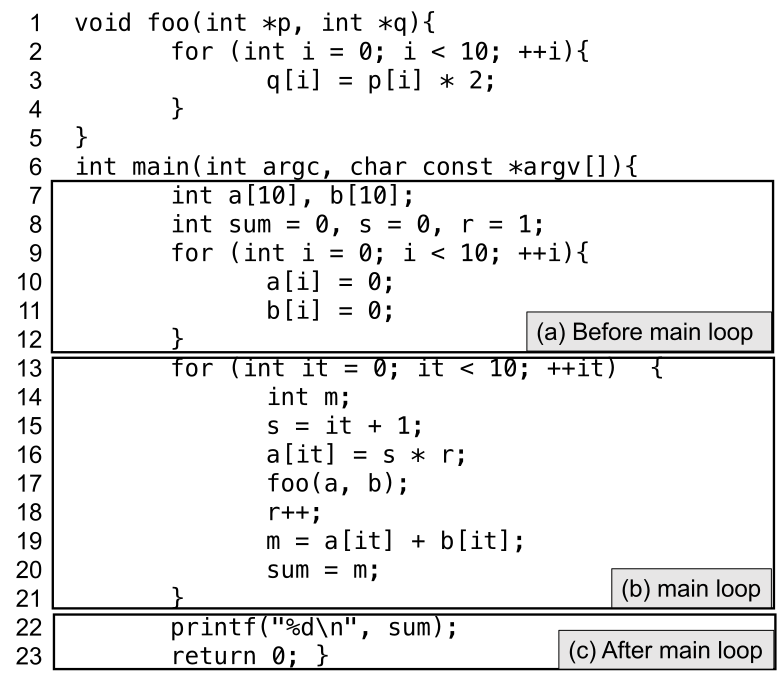
Fig. 4: Example code(本ノート中の説明で参照する主計算ループの例)。
データ依存解析 — 完全DDGの構築と縮約
主計算ループの実行では、変数の値は一時レジスタに読み込まれてから演算に使われ、結果が変数へ書き戻される。そのためレジスタと変数の対応を追わないと DDG を作れない。AutoCheck は動的命令列から次の2つの表を維持する。
- reg-var map:
Load/Store/BitCast/GetElementPtr命令から、一時レジスタと算術変数の対応を追跡する。SSA(静的単一代入)の性質上、変数が再利用されるたびに新しいレジスタへ再ロードされるため、この表を命令の実行順に逐次更新することで、レジスタが実際にどの変数に対応するかを正しく識別できる(複数の算術変数が同じレジスタ番号を共有する「mutable-register」問題への対処でもある)。 - reg-reg map:
Add/Sub/Mul/Div系の算術命令から、入力レジスタと出力レジスタの対応を記録する。関数呼び出し(Call命令)も、単純呼び出しならこの reg-reg map に、引数と仮引数を結びつける呼び出しなら reg-var map への追記として扱う。
これらの表を Store 命令のたびに DDG へ反映することで、MLI 変数だけでなくローカル変数や一時レジスタまで含む完全 DDG が得られる。次に、目的である MLI 変数だけの 縮約 DDG を得るため、各 MLI 変数の親が MLI 変数でない限り、親を祖父母(親の親)へ置き換える操作を繰り返す縮約アルゴリズムを適用する。
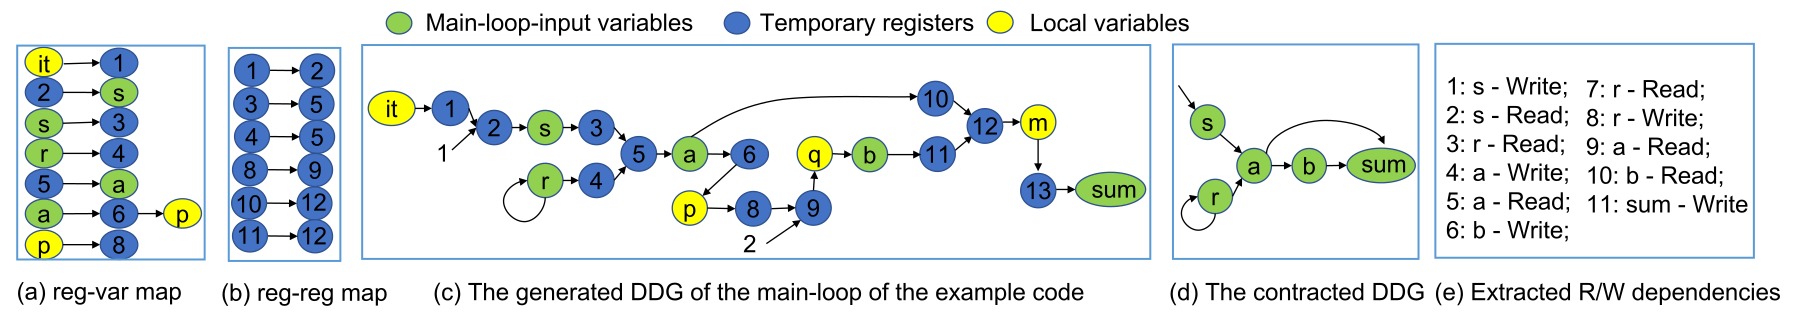
Fig. 5: Data dependency analysis(reg-var map、reg-reg map、完全DDG、縮約DDG、実行時系列順のread/write依存の一連の流れ)。
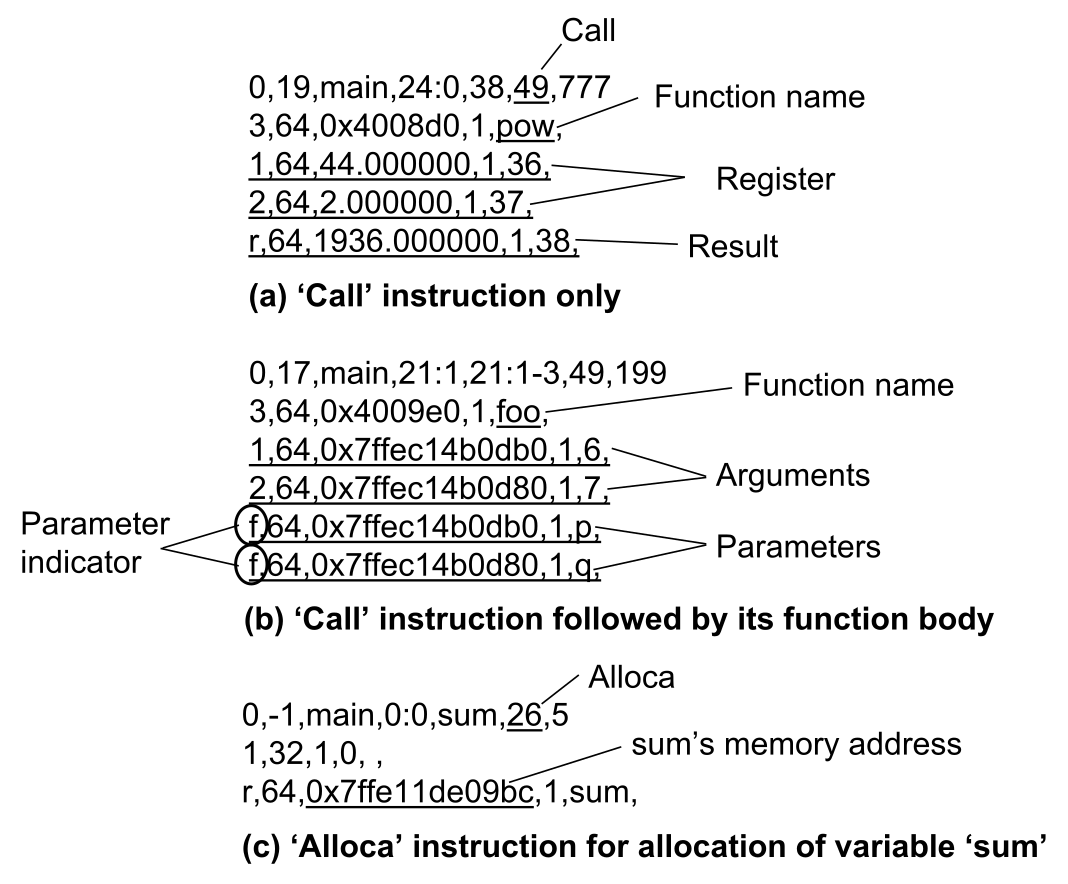
Fig. 6: Critical instructions(2種類の Call 命令と Alloca 命令の扱い)。
臨界変数の特定 — 4種類のヒューリスティック
縮約 DDG を実行時系列順の read/write 依存列に変換したうえで、次の4パターンのいずれかに該当する変数を臨界変数と判定する。
- Write-After-Read (WAR):あるイテレーションで読み出された変数が、後で新しい値に上書きされ、次のイテレーションではその新しい値が使われるパターン。イテレーションをまたいで値が持ち越されるため、失われると復元できない。
- Outcome:主計算ループの出力で、ループ後の処理で入力として使われる変数。
- Read-After-Partially-Overwritten (RAPO):配列変数で、要素の一部だけが上書きされてから読み出されるパターン。上書きされなかった要素は再起動時に復元できないため、配列全体をチェックポイントする必要がある。
- Index:主計算ループ(最も外側のループに限る)の帰納変数。これは
llvm-pass-loopAPI で特定し、再起動時にどのイテレーションから再開すべきかを示すために別枠で扱われる。
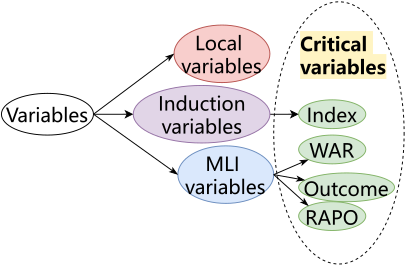
Fig. 7: Identifying critical variables for checkpointing(4種類のヒューリスティックの整理)。
ケーススタディ:共役勾配法(CG)
論文は具体例として CG の疑似コードを示し、main 関数のループ内で x(Line 3 で読み、Line 19 で書く)が Write-After-Read パターンに該当するためチェックポイントが必要と判定し、z、p、q、r、A にはチェックポイントを要する依存が見つからなかったと報告する。加えて帰納変数 iter もチェックポイント対象になる。
数式・アルゴリズム
DDG 縮約アルゴリズムは次の疑似コードで与えられる(論文 Algorithm 1)。
Function ContractedDDG(complete_DDG):
    for n in main_loop_input_variables:
        NP = 親頂点の集合(n)
        for np in NP:
            if np が main_loop_input_variable でない:
                Contract(np)
        NP = 更新後の親頂点の集合(n)
        for np in NP:
            if np が main_loop_input_variable でない:
                np を n との依存を保ったまま縮約
    return contracted_DDG

Function Contract(p):
    PP = p の親頂点の集合
    p を自分の親頂点群で置き換える
    if PP が全て main_loop_input_variable であるか空:
        終了
    else:
        for pp in PP:
            if pp が main_loop_input_variable でない:
                Contract(pp)   // 各親頂点を再帰的に縮約
実験・結果
評価環境は Intel Xeon E5-2678 V3 CPU2基(合計24物理コア)、32GB RAM の Linux サーバ。トレース生成は LLVM-Tracer 1.2 / LLVM-Clang 3.4.2、依存解析部分は gcc-7.5 + OpenMP-4.5(-O3)でコンパイル。
- 対象ベンチマーク:HPCCG、Himeno、NAS Parallel Benchmarks 全種、ECP のプロキシアプリケーション(CoMD、miniAMR、AMG)、実世界の宇宙論シミュレーション HACC を含む14種。単一のベンチマーク集合に偏らないよう意図的に多様な分野から選んだとしている。
- 正しさの検証:AutoCheck が特定した変数に FTI(L1 モード)で実際にチェックポイントを実装し、
raise(SIGTERM)で人為的に異常終了させて再起動を試したところ、14ベンチマークすべてで、再起動後の出力が障害なし実行の出力と一致した。さらに検出変数を1つずつ無効化しても正しく再起動できないことを確認し、不要な(偽陽性の)変数は見つからなかったと報告している。 - 依存パターンの内訳:チェックポイント対象の変数は合計102個特定され、依存タイプの内訳として WAR76、Outcome2、RAPO2、Index15(原文の記載通りだが、この内訳の合計は102ではなく95になっており、本文中の数値の整合性は確認できていない)が報告されている。この内訳から、WAR が最も支配的な依存パターンだとしている。
- 解析コスト:解析時間は並列化なしで平均169.37秒(最小0.14秒、最大823.43秒)、OpenMP による前処理の並列化(評価では48スレッド、前処理段階で平均16倍の高速化)を使うと平均70.16秒(最小0.04秒、最大340.51秒)に短縮される。最もコストの大きい部分はLLVMトレースファイルの前処理読み込みで、トレースサイズは2.6MBから12.7GBまで幅がある。
- ストレージコスト比較:同一入力で14ベンチマークすべてについて、システムレベルの BLCR と比べてチェックポイントの保存容量を最大7桁削減できたと報告している。
関連研究との関係(メモ)
- FTI(cite key
bautistagomez2011fti):AutoCheck 自身が検証用の C/R ライブラリとして採用しており、AutoCheck が特定した変数を FTI の L1 モードで実際にチェックポイントすることで正しさを検証している。「アプリケーションレベルの C/R ライブラリは強力だが、どの変数を保存すべきかはプログラマが決めねばならない」という AutoCheck の問題設定は、FTI や VeloC のような既存ライブラリを前提にした上で、その手前の工程(変数選定)を自動化するものだと位置づけられている。 - C3 / CCIFT(cite key
bronevetsky2003c3):C3 はコンパイラでアプリケーション全体の状態を自動的に保存・復元する(変数選定を利用者に残しつつ、保存・復元コード生成を自動化する)のに対し、AutoCheck は「どの変数を保存すべきか」という選定そのものを自動化する。両者は自動化の対象が異なる、補完関係にある。 - ElasticNotebook(
li2023elasticnotebook):MLI 変数を「主計算ループへの入力」として特定し、それ以外は再計算可能とみなす発想は、ElasticNotebook が Application History Graph 上で保存すべき変数と再計算すべき変数を最小カットで分ける発想と、解いている問題の構造が近い。詳細は アプリケーションレベルのチェックポイント の §5(橋)を参照。
Q&A
(自分がAIに実際に質問したことだけをQ/A形式で残す。まだなし。)
自分のコメント
(ここは自分で都度書く欄。)