AI解説
実装: Pegasus WMS。https://pegasus.isi.edu/ 情報源: Future Generation Computer Systems 2015 論文本文(自己アーカイブ版 PDF、全21頁)を精読して記述。本文に書かれていない事項は書いていない。
一言で
12年以上にわたり天文学・地震学・バイオインフォマティクス・物理学など幅広い分野の科学者に使われてきたワークフロー管理システム Pegasus の設計・開発・進化を包括的にまとめた論文。資源に依存しない抽象ワークフロー記述を分散計算基盤へマッピングし、データ再利用によるワークフロー簡約、複数レベルの障害対応、タスククラスタリングによって、キャンパスクラスタから国家サイバーインフラ、商用クラウドまで多様な計算資源にまたがる信頼性の高いワークフロー実行を実現する。
背景・問題
現代の科学はしばしば、仮説として立てられた現象を探索したり、複雑なシステムの振る舞いや相互作用のシミュレーションを通じて基本原理を検証したりするために、膨大な量のデータの処理と解析を必要とする。データは複数のリポジトリに分散し、利用可能な計算資源はキャンパスクラスタから国家サイバーインフラ、クラウドまで異種混在で、結果は遠隔の共同研究者と交換する必要がある。こうした科学分野のニーズと、拡大し続けるサイバーインフラの能力とを橋渡しするワークフロー技術が必要とされてきた。
提案手法
抽象ワークフロー記述(DAX)とコンパイル時の変換
Pegasus のワークフローは、資源に依存しない抽象ワークフロー記述(DAX、Directed Acyclic graph in XML)として与えられる。DAX は計算を行う全タスク、タスク間の実行順序(DAG の辺として表現)、各タスクが必要とする入力・期待される出力・呼び出し引数を記述する。全ての入出力データセットと実行ファイルは論理識別子で参照される。
Mapper(コンパイラに相当するコンポーネント)は、この抽象ワークフローを一連の精錬(refinement)ステップを通じて実行可能ワークフローへ変換する。精錬パイプラインはプラガブルなアーキテクチャを持ち、各ステップに複数のバックエンドや戦略を差し替えられる。
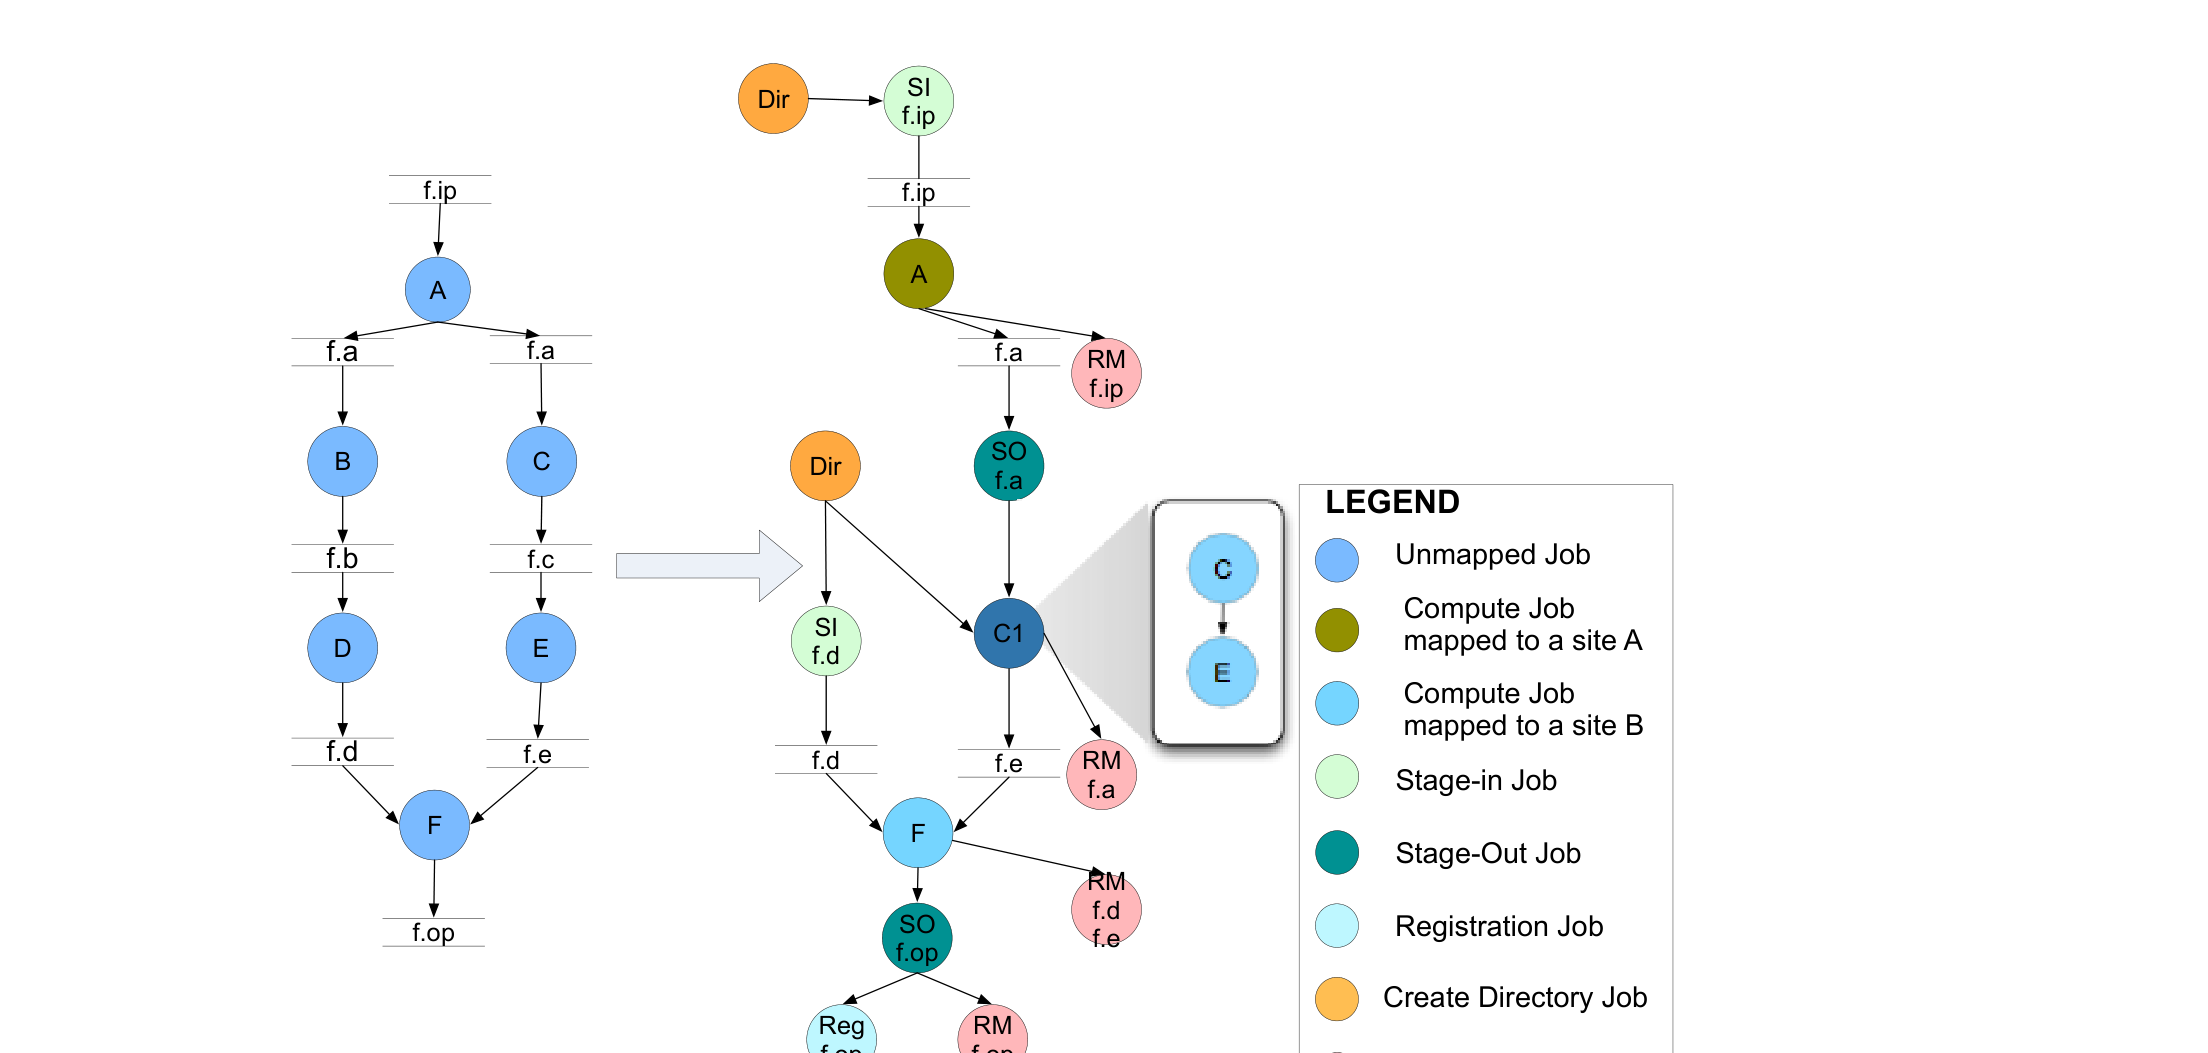
Figure 8: Translation from Abstract to Executable Workflow。
データ再利用/ワークフロー簡約
Pegasus は virtual data という概念に起源を持つ。そのため、ワークフロー記述を受け取ると、求められているデータが既に計算され利用可能かどうかを確認する。Mapper は Replica Catalog に問い合わせてこれらのファイルの所在を調べ、ファイルが既に存在すれば、そのデータを生成するはずだったジョブをワークフローから取り除く。さらに、あるノードの削除が他の親ノードの連鎖的な削除につながるかどうかも推論できる。これは、ソースコードから実行ファイルをコンパイルするツール “make” に似た仕組みである。ワークフローの出力そのものが既にどこかに存在する場合、Mapper は全ての計算ノードを取り除き、データのステージアウトと登録ノードだけを追加する。データ再利用は任意であり、場合によっては再アクセスするより再計算する方が効率的なこともある。
障害対応 — 複数レベルの信頼性機構
Just-in-time なプランニングを行っていても、分散基盤上での実行では障害が起こりうる。Pegasus は DAGMan と HTCondor の信頼性機能を土台に、複数のレベルで動的に障害へ対処する。
- Job Retry:ワークフロー中のノードが失敗すると、対応するジョブは HTCondor DAGMan によって自動的に再試行・再投入される。これは、ワークフローの DAGMan ファイル中で各ジョブに紐付けられたリトライ回数によって実現され、リモートクラスタの故障ノードへスケジュールされた、あるいはネットワーク障害によるジョブの切断といった一過性のエラーを自動的に処理できる。
- Data Movement Reliability:低レベルの転送は
pegasus-transferサブシステム/コマンドラインツールが扱う。pegasus-transferは転送の再試行を実装しており、転送のグループ化やプロトコル固有コマンドラインツールへ渡す引数を変えられる。例えばglobus-url-copyを使うサードパーティでない転送では、最初の試行で並列転送のために-parallel 6を渡すが、並列接続はファイアウォールがあると失敗しやすいため、最初の転送が失敗すると以降の転送ではこの引数を外し、より安全だが遅い単一接続の転送を試みる。 - Failed Workflow Recovery / Rescue DAGs:あるジョブの失敗回数が設定されたリトライ回数を超えると、そのジョブは致命的な失敗としてマークされ、ワークフロー全体が最終的に失敗する。DAG が失敗すると、DAGMan は元の DAG に似た rescue DAG を書き出すが、成功したノードには完了の印が付いている。これによりユーザは、元のエラーの原因を解決した後にワークフローを再投入でき、ワークフローは失敗した地点から再開する。これは、誤ってコンパイルされたコード、故障したアプリケーション実行ファイル、ネットワーク障害やメンテナンスでアクセスできないリモートクラスタといったエラーに対処するのに役立つ。
- Workflow Replanning:ワークフローが失敗した場合、ユーザはワークフローを再プランニングして残りの計算を別の資源へ移す選択肢も持つ。ワークフロー再プランニングは、前述のデータ再利用の機能を活用する。出力が生成されるたびにデータカタログへ登録されるため、データ再利用アルゴリズムは、データカタログに存在する既存の出力・中間ファイルに基づいて、”make” が行うのと同様にワークフローを刈り込む。中間ファイルは、再プランニング時にプランナが追加するデータのステージインノードによって、新しいクラスタ/ロケーションへ運ばれる。ワークフロー再プランニングは、ユーザが入力ワークフロー記述の生成時に誤り(アプリケーションコードへの誤った引数、入力が全て揃う前にジョブが起動されるような誤った DAG 構造など)を犯した場合にも役立つ。階層的なワークフローでは、サブワークフローが失敗して自動的に再試行されると、マッピングのステップも自動的に再実行され、新しいマッピングが行われる。
サイト選択とタスククラスタリング
簡約されたワークフローは、Site Selector によってユーザが指定した候補実行サイトへマッピングされる(Random、Round Robin、HEFT などの戦略、外部サイトセレクタのプラグインも可能)。分散計算基盤では通信オーバーヘッドとキューイング時間が問題になりやすいため、Pegasus は数分から数秒で終わる短時間タスクを粗粒度のタスクへまとめるタスククラスタリング技術を持つ。クラスタリングされたタスクが入力データを共有していればデータ転送のコストを減らせ、資源が限られている場合はキューイング時間を節約できる。この技術はワークフロー完了時間を最大97%改善できるとされる。
関連研究との関係(メモ)
- Nextflow(cite key
ditommaso2017nextflow):どちらもタスク(プロセス)粒度で、完了済みの成果物を再利用してまだ終わっていない部分だけを実行し直すという発想を共有するが、Pegasus はデータカタログへの登録と “make” 風のワークフロー刈り込みで、Nextflow はタスクの入力・スクリプト・環境から計算したハッシュとキャッシュ台帳の照合で、それぞれ再利用の判定を行うという違いがある。 - 分野横断的な位置づけは アプリケーションレベルのチェックポイント の §3.7 を参照。
Q&A
(自分がAIに実際に質問したことだけをQ/A形式で残す。まだなし。)
自分のコメント
(ここは自分で都度書く欄。)