AI解説
実装: Apache Flink(本アルゴリズムが Flink 本体へ組み込まれている)。https://flink.apache.org/ 情報源: arXiv v1(2015-06-29、全8頁)の全文を精読して記述。本文に書かれていない事項は書いていない。
一言で
分散ストリーム処理で障害から復旧するための、Asynchronous Barrier Snapshotting(ABS)という軽量なスナップショット手法。非循環な実行グラフでは伝送中のレコード(チャネル状態)を一切保存せず、オペレータの状態だけでスナップショットを構成する。循環グラフでも、逆辺(back-edge)を通るレコードだけを選択的にログすることで、追加のチャネルブロッキングなしに対応する。Apache Flink に実装され、頻繁なスナップショットでも実行への影響が小さく、線形にスケールすることを示す。
背景・問題
分散ステートフルストリーム処理は低レイテンシと高スループットを両立させたクラウド上の継続的計算を可能にするが、障害時の処理保証をどう与えるかが根本的な課題である。既存手法は周期的な大域状態スナップショットに頼るが、これには二つの欠点がある。
第一に、多くの手法は大域スナップショットを取るために計算全体を止める(同期的スナップショット)。Naiad の方式が代表例で、実行グラフ全体の計算をまず止め、スナップショットを取り、大域スナップショットが完了してから各タスクに実行再開を指示する、という3段階を踏む。この方式はスループットとストレージ要件の両方に大きな影響を与える。
第二に、既知の分散スナップショットアルゴリズムはいずれも、チャネル内を伝送中のレコードや未処理のメッセージをスナップショット状態の一部として含めており、多くの場合必要以上に大きい状態を保存することになる。Chandy-Lamport に由来し多くのシステムで使われているもう一つの方式は、非同期にスナップショットを取りつつ積極的にアップストリームバックアップ(送信側でのメッセージログ)を行う方式だが、これもバックアップ分の追加ストレージと、バックアップレコードの再処理による復旧時間の増大という欠点を持つ。
提案手法
問題の定式化
実行グラフを G = (T, E) として、タスク T を頂点、データチャネル E を辺とする有向グラフで表す。大域スナップショットは G* = (T*, E*) と定義され、T* は全タスクの状態、E* はチャネル状態(伝送中のレコード)の集合である。スナップショットアルゴリズムが満たすべき性質は、有限時間で必ず終わるterminationと、スナップショット中に計算の情報が失われない(記録された因果順序が保たれる)feasibilityの2つである。
非循環グラフ向け ABS(Algorithm 1)
実行を「ステージ」に区切れば、チャネル状態を保存せずにスナップショットが取れる、というのが核心のアイデアである。あるステージの終わりにおけるオペレータ状態の集合は、それまでの実行履歴全体を反映しているため、それだけでスナップショットとして使える。
ABS はこのステージを、入力データストリームへ周期的に注入され実行グラフ全体をシンクまで伝播する「バリア」マーカーで模倣する。central coordinator が全ソースへステージバリアを注入する。ソースタスクはバリアを受け取るとただちに自分の現在状態をスナップショットし、バリアを全出力へブロードキャストする。複数の入力を持つ非ソースタスクは、あるバリアを1つの入力から受け取るとその入力をブロックし、全ての入力からバリアが揃うまでブロックを保つ。全入力が揃った時点で自分の状態をスナップショットし、バリアを出力へブロードキャストしてから、すべての入力チャネルのブロックを解除する。
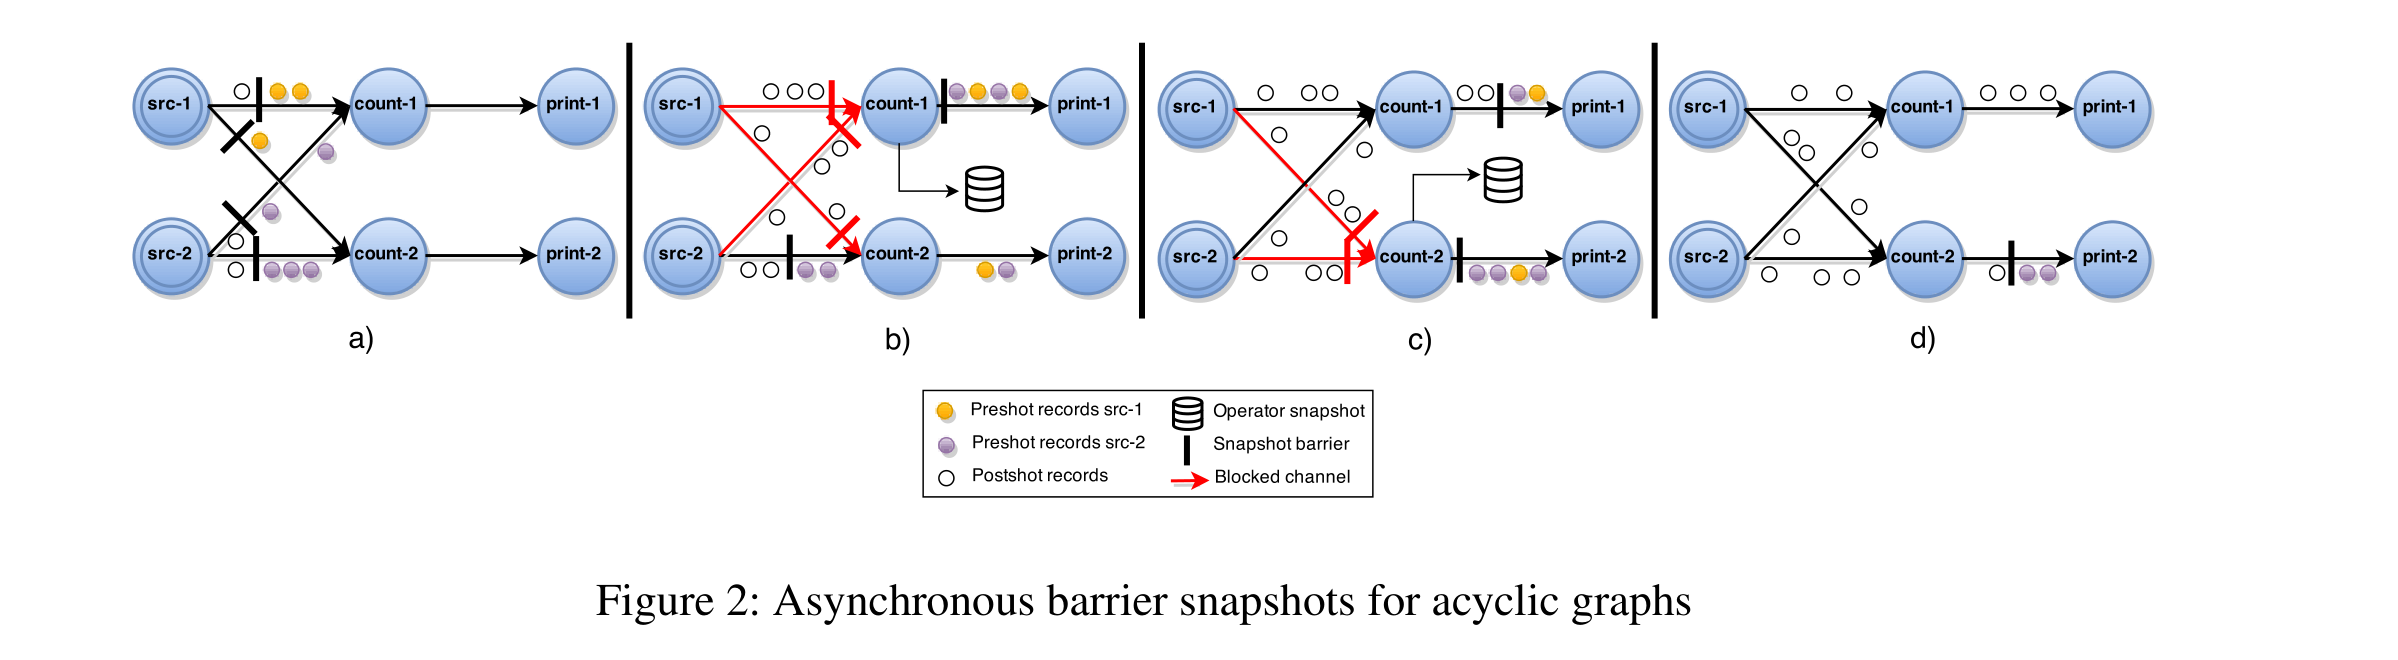
Figure 2: Asynchronous barrier snapshots for acyclic graphs。オレンジ・紫の丸はバリア前後(preshot/postshot)のレコード、赤い矢印はブロック中のチャネルを表す。
この手続きの結果、完全な大域スナップショット G* = (T*, E*) は E* = ∅、すなわちオペレータの状態だけで構成される。論文はこれを、チャネルが FIFO 順序を守り信頼できる(quasi-reliable)という前提と、非循環グラフでは必ずソースからのパスが存在するという性質から、termination と feasibility の両方を満たすと証明している(形式的な証明は誌面の都合で省略され、証明のスケッチのみが与えられている)。
循環グラフ向け ABS(Algorithm 2)
実行グラフに有向閉路があると、非循環版のアルゴリズムはデッドロックする。閉路内のタスクは、閉路を構成する入力からバリアを受け取るのを永遠に待つことになるためである。加えて、閉路内を任意に巡回しているレコードはスナップショットに含まれず、feasibility が破られる。
そこで、静的解析によって実行グラフ中の逆辺(back-edge)を特定する(制御フローグラフの用語で、深さ優先探索で既に訪問済みの頂点へ戻る辺)。逆辺を除いたグラフ G(T, E\L) は DAG になり、この DAG に対しては非循環版と同じ手続きが動く。加えて、逆辺を消費するタスクは、バリアを通常の入力全てから受け取った時点で自分の状態のローカルコピーを作り、その時点から逆辺経由でバリアを受け取るまでの間に届いたレコードだけを別途バックアップログへ記録する。これにより追加のチャネルブロッキングを一切増やさずに、閉路内を巡回するレコードだけを選択的にログできる。
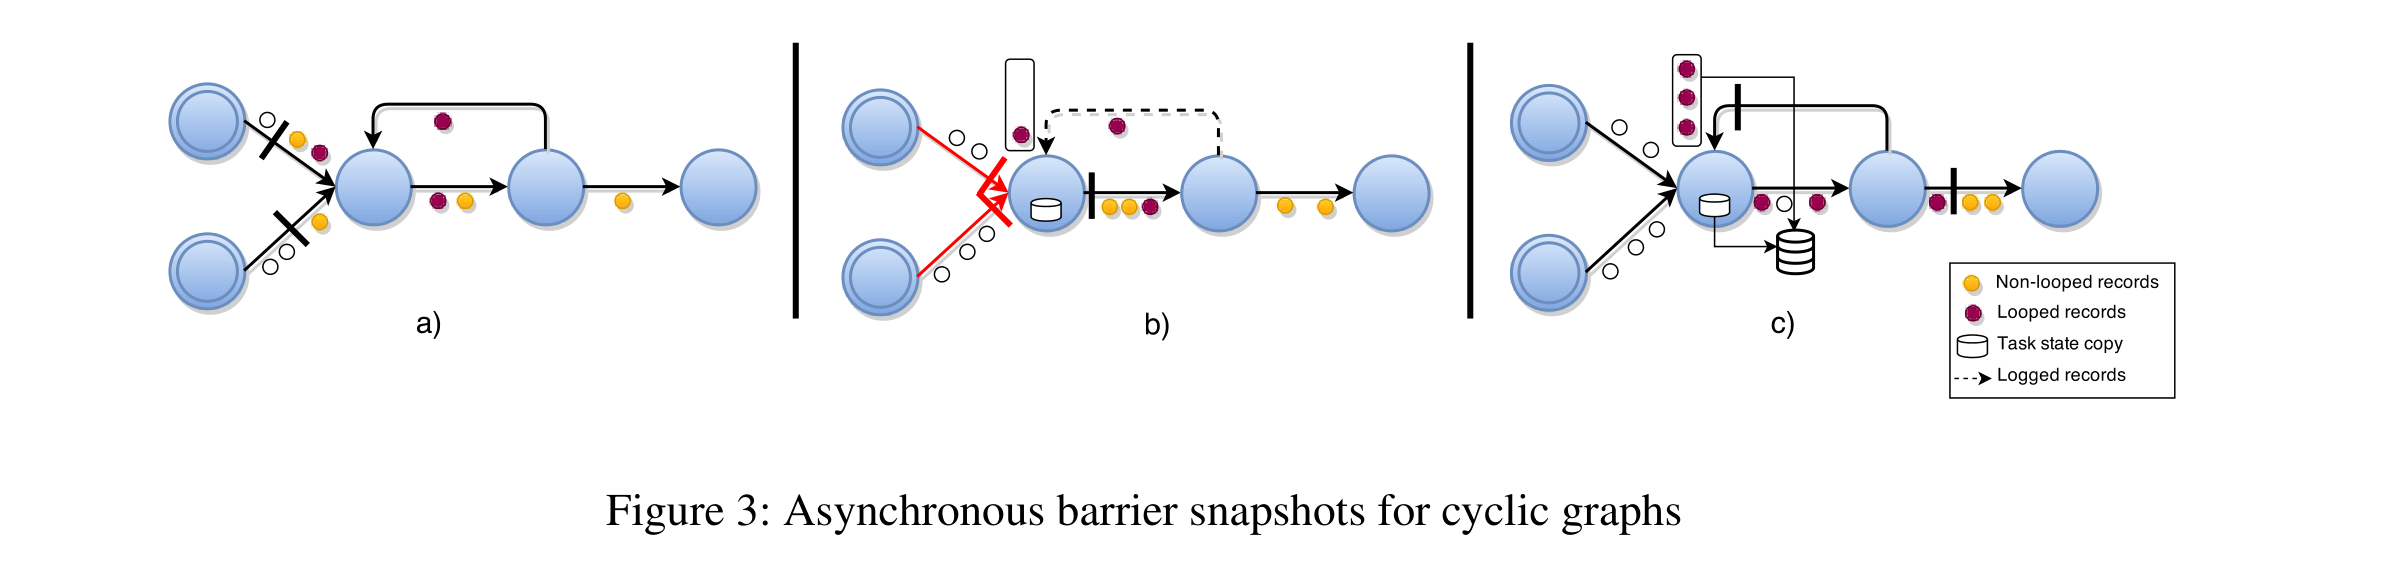
Figure 3: Asynchronous barrier snapshots for cyclic graphs。紫の丸はログ対象の「ループレコード」、円柱アイコンは状態コピーとログを表す。
最終的な大域スナップショットは G* = (T*, L*)(L* ⊂ E* は逆辺上の伝送中レコードのみ)となり、非循環部分については引き続きチャネル状態を持たない。
復旧の概略
本論文の主眼ではないと断りつつ、動作を裏付ける復旧手順の概略が示される。最も単純な形では、実行グラフ全体を最後の大域スナップショットから再起動し、各タスクが自分の状態とバックアップログを永続ストレージから取り出して初期状態とし、ログ済みレコードを処理してから入力の取り込みを再開する。TimeStream に類似した部分グラフ復旧(失敗したタスクへ出力を持つ上流タスクだけを再スケジュールする)の可能性にも触れ、正確に一度だけ(exactly-once)の意味論を保証するには、SDGs と同様にソースからのシーケンス番号でレコードに印をつけ、下流ノードが既に処理済みの番号より小さいレコードを破棄する必要があるとしている。
実装
ABS は Apache Flink に実際に組み込まれた。ブロックされたチャネルは、スケーラビリティを高めるためメモリではなくディスクへレコードを保存する実装になっており、これが頑健性を高める一方で実行時への影響も増やすとしている。オペレータの状態とデータを区別するため、状態の更新とチェックポイントのメソッドを持つ OperatorState インタフェースが導入され、オフセットベースのソースや集約など Flink のステートフルなランタイムオペレータに実装が提供された。スナップショットの調整は job manager 上の actor プロセスとして実装され、ジョブ全体の実行グラフの大域状態を保持する。
実験・結果
評価環境は最大40台の Amazon EC2 m3.medium インスタンス。評価トポロジは6種類のオペレータをクラスタノード数と同じ並列度で持ち(合計 6 × クラスタサイズ のタスク頂点)、ABS へのチャネルブロッキングの影響をあえて際立たせるため3回の完全なネットワークシャッフルを含む。ソースから合計10億レコードを均一に生成し、オペレータの状態はキーごとの集約とソースオフセットとした。
- スナップショット間隔を変えた比較(10ノードクラスタ):Naiad 方式の同期スナップショットを Flink 上に実装して比較した結果、間隔が短いほど同期方式の性能影響が大きく現れた(頻繁に計算全体を止めてスナップショットを取るため)。ABS は実行を止めずに継続的に動くため、実行時間への影響がはるかに小さく、スループットも比較的安定していた。間隔が長くなると同期方式の影響は相対的に小さくなる(実験では1〜2秒のバーストで動作する)が、そうしたバーストは侵入検知パイプラインのようなレイテンシに厳しいアプリケーションの SLA に違反しうる、と論じている。
- スケーラビリティ:3秒間隔のスナップショットを使い、クラスタサイズを5から40ノードへ増やしながら固定量(10億レコード)の入力を処理したところ、ベースライン(耐障害性なし)と ABS の両方が線形にスケールした。
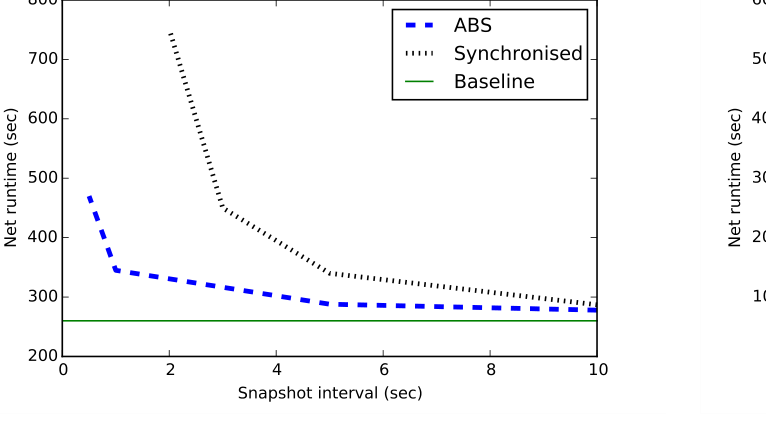
Figure 6: Runtime impact comparison on varying snapshot intervals。
関連研究との関係(メモ)
- Chandy-Lamport の分散スナップショット:論文自身が「Chandy と Lamport のオリジナルの非同期スナップショットのアイデアを拡張したもの」と明言する出発点。マーカーメッセージによる大域状態の記録という発想を受け継ぎつつ、非循環グラフではチャネル状態の記録を一切不要にし、循環グラフでも選択的なバックアップに限定する点で異なる。
- Naiad:本論文が性能比較のベースラインとして採用する同期スナップショット方式。実行全体を止めてスナップショットを取る点が ABS との主な対比点になっている。
- C3 / CCIFT(cite key
bronevetsky2003c3):同じくアプリケーションレベルでの非ブロッキング協調チェックポイントを目指す研究だが、対象がMPIプログラムの停止故障という点で制約が異なる。両者とも Chandy-Lamport 由来の発想を、それぞれ異なる制約(MPI プログラムのPotentialCheckpoint呼び出し位置 vs 継続的なストリーム処理)のもとで作り直している。詳細は アプリケーションレベルのチェックポイント の §3.3 を参照。
Q&A
(自分がAIに実際に質問したことだけをQ/A形式で残す。まだなし。)
自分のコメント
(ここは自分で都度書く欄。)