AI解説
公開先: https://hdl.handle.net/10919/82857(Virginia Tech のリポジトリ。PDF は 23 ページ、日付は 2018-04-19) 情報源: PDF の全文(本文・図 1〜9・表 1〜3・関連研究・結論)を読んだ。数式の詳細(第 5 章の LSP・MARS・Delaunay の定式化)は要点のみ拾っている。 テクニカルレポートの番号は、PDF の本文から読み取れなかったため書いていない。 本文に「This work has been submitted to IEEE TPDS」とあり、査読を経た版ではない。 図について: 図 1〜9 は PDF のページから切り出した画像(
figures/fig*.png)。図番号とキャプションは原論文に対応する。AI 生成の補足図は付けていない。 図はコミットして公開サイト(GitHub Pages)にも表示する。サイトは noindex メタ+robots.txtで検索除けされている。
一言で
並列共有メモリ計算機のローカルディスク I/O について、性能のブレを「構成ごとの標準偏差」として予測する手法 MOANA の論文。 IOZone で約 9.5 万構成を各 40 回測り、標準偏差を目的変数にした回帰モデル(variability map)を作る。 非線形な補間手法(LSP、Delaunay)の平均相対誤差は、学習に 9 割を使うと約 10〜11% で、線形回帰(約 323%)の 1/30 程度に収まる。 測定回数と 90% 信頼区間の収束の関係も予測でき、「あと何回測ればよいか」を見積もれる。 予測対象は帯域の平均ではなくブレである。
背景・問題
解くべき問題
HPC の I/O 性能は繰り返し測っても値がばらつく。 著者らは、ブレがスケールとともに増え、エクサスケールで性能最適化の障害になると述べる。 ブレが大きいと、何回測れば信頼できる結論が出るかが分からない。 著者らは 1 年以上かけて I/O コードを繰り返し測り、統計的信頼度を確保してきたと書く。 総当たりで測る方法は、構成の数が増えると現実的でない。
課題(この論文がやること)
- 構成(CPU 周波数、スレッド数、ファイルサイズ等)からブレの大きさを予測する非線形モデルを作る。
- 予測したブレを使い、信頼区間が収束するのに必要な繰り返し回数を見積もる。
測定条件
測定対象は、ノード内(intra-node)の I/O のブレである。 ネットワークや NFS は対象に含まれない。
| 項目 | 内容 |
|---|---|
| 計算機 | 2 ソケット・4 コア(2 HT/コア)Intel Xeon E5-2623 v3、32 GB DDR4 |
| 環境 | ゲスト Linux(Ubuntu 14.04 / Xen 4.0)、専用の 2 TB HDD |
| ベンチマーク | IOZone(最大 6 台の同一構成機に振り分け) |
| ファイルサイズ | 64、256、1024 KB の 3 水準 |
| レコードサイズ | 32、128、512 KB の 3 水準(ファイルサイズとの有効な組み合わせは 6 通り) |
| スレッド数 | 1、2、4、…、256 の 9 水準 |
| CPU 周波数 | 1.2〜3.0 GHz の 15 水準 |
| I/O スケジューラ | ホストと VM それぞれ CFQ、DEAD、NOOP |
| I/O 操作モード | fread、fwrite、initial write など 13 種 |
- 全構成は 15 × 9 × 6 × 3 × 3 × 13 = 94,770 通り(本文は「95K 超」)。
- 各構成を 40 回実施する。正規性を仮定すると 95% の統計的信頼度になる、と著者は書く。
- ブレの指標は 40 回の標準偏差(スループットの絶対値、単位は KB/s)。相対標準偏差ではない。
- 母集団の分布は正規と仮定している。著者は、この仮定を将来検討すると結論に書く。
ファイルサイズは 64〜1024 KB に限られる。 1 MB 以上のサイズは測られていない。
実測で分かったこと(第 2 章)
ファイルサイズとスループット
図 1 は、レコードサイズ 32 KB、スレッド数 256 で、ファイルサイズを変えた結果である。
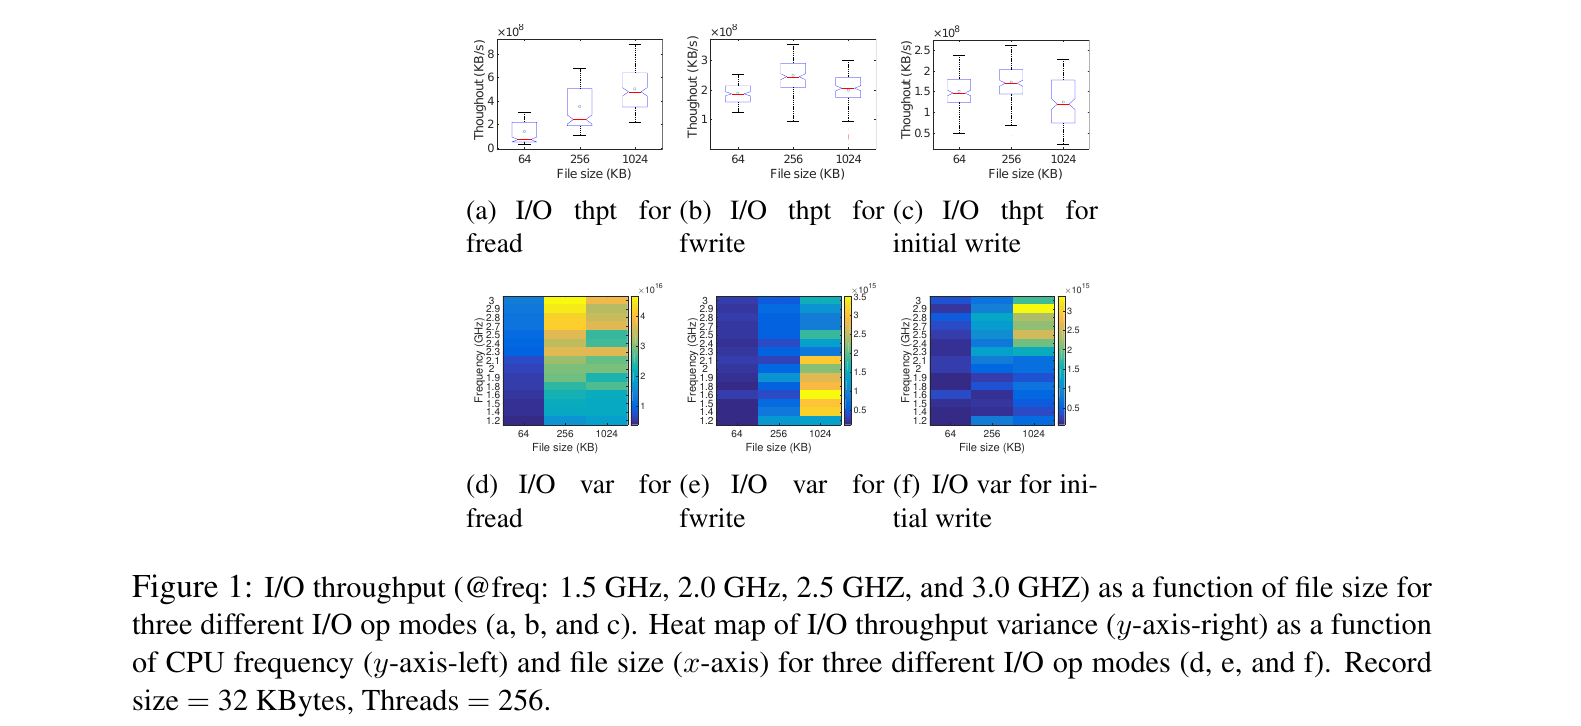
Figure 1: ファイルサイズに対する I/O スループット((a)〜(c)、CPU 周波数 1.5〜3.0 GHz)と、CPU 周波数×ファイルサイズに対するスループット分散のヒートマップ((d)〜(f))。(a)(d) が fread、(b)(e) が fwrite、(c)(f) が initial write。
- fread のスループットはファイルサイズとともに増える。著者の説明は、時間の大半がシークで、サイズが大きいほど 1 回のシークの後に長い逐次読み出しが続くから、というもの。
- fwrite と initial write は、最初は増え、のちに減る(図 1(b)(c))。著者の説明は、書き込みは最初キャッシュに吸収されるが、キャッシュが満杯になるとディスクへのフラッシュが効いて全体のスループットが下がる、というもの。
- ここでのサイズは 3 水準しかない。「増えてから減る」は 64→256→1024 KB の 3 点で見えた形である。山の位置を特定したわけではない。
- この説明は著者の解釈であり、キャッシュ容量やフラッシュ量を直接測って確かめてはいない。
ブレ(分散)の傾向
- fread の分散は中程度のサイズで最大になる(図 1(d))。著者の説明は、シークの寄与が減ると、CPU 周波数やスケジューリングによる I/O サブシステム間の相互作用が目立つため。
- fwrite の分散は、低い周波数で大きいファイルほど大きい(図 1(e))。initial write は、高い周波数で大きいファイルほど大きい(図 1(f))。後者の理由として、ディスクフラッシュの増加と、高周波数での速いスケジューリング判断による非決定的な相互作用を著者は挙げる(「potentially」と留保)。
- レコードサイズは、fread のスループットを下げ、書き込み系ではほぼ変えない(図 2)。分散は複雑に変わる。
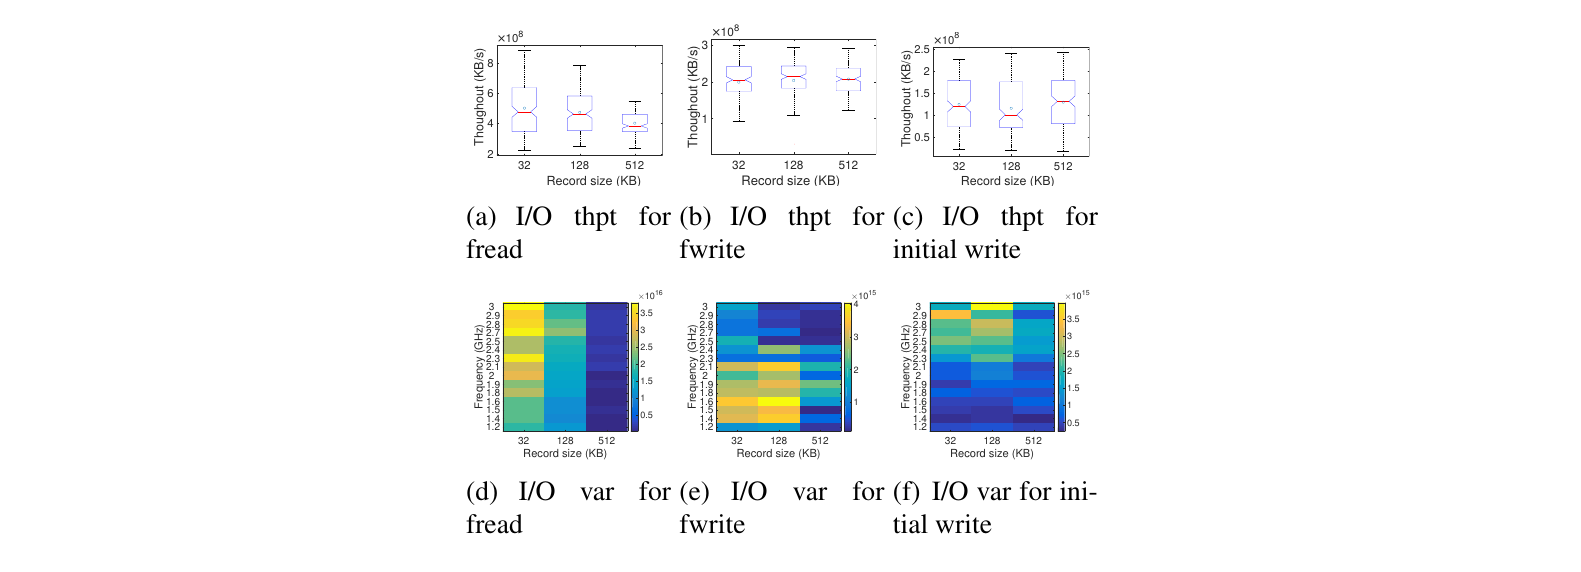
Figure 2: レコードサイズに対する I/O スループット((a)〜(c))と、CPU 周波数×レコードサイズの分散ヒートマップ((d)〜(f))。ファイルサイズは 64〜1024 KB の水準、スレッド数は 256。
- スレッド数を増やすと、3 モードともスループットが増え、分散も増える(図 3)。
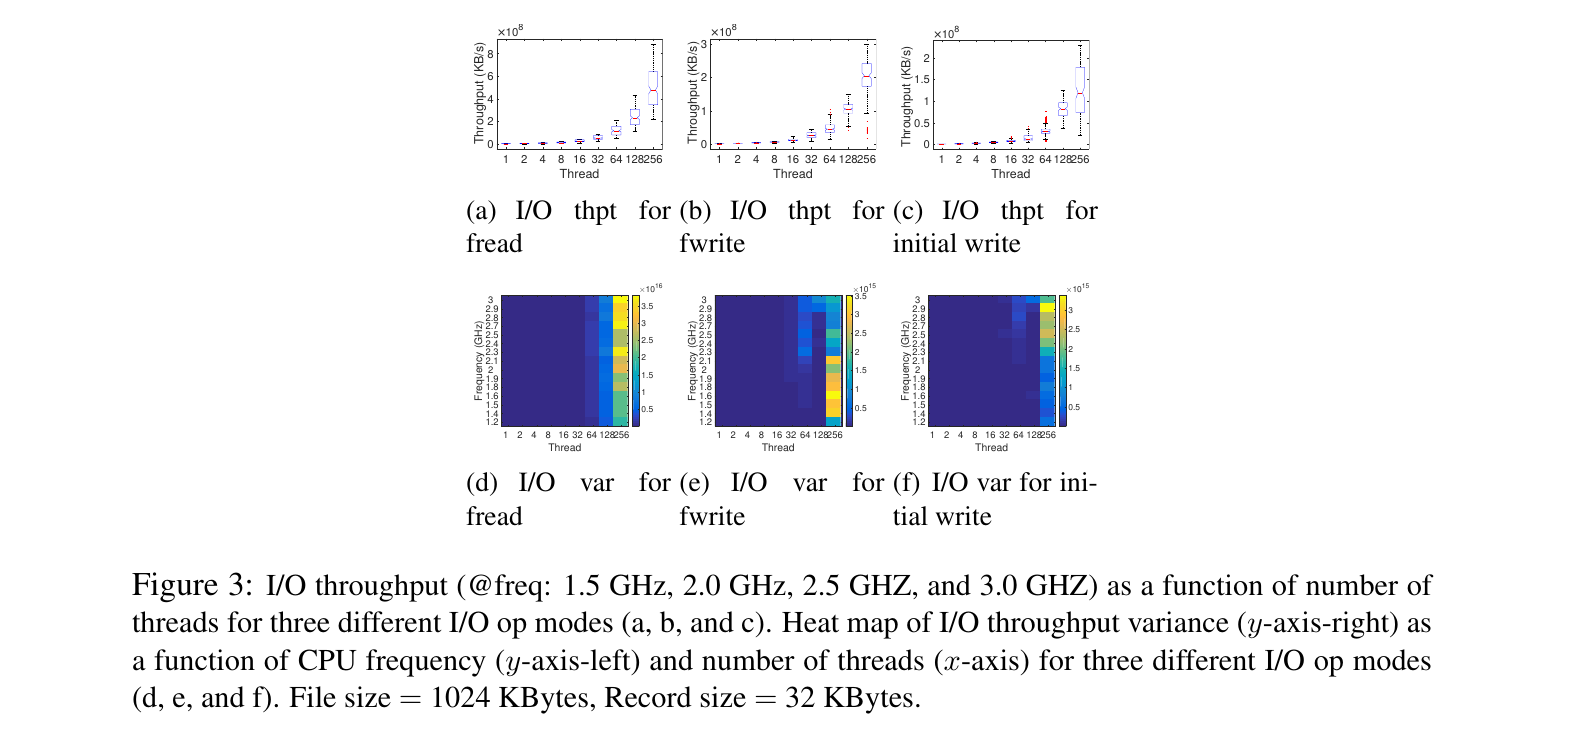
Figure 3: スレッド数に対する I/O スループット((a)〜(c))と、CPU 周波数×スレッド数の分散ヒートマップ((d)〜(f))。ファイルサイズ 1024 KB、レコードサイズ 32 KB。
- 図 4 は、スレッド数を 256 から 64 に減らしたときの分散の変化を示す。この変化は CPU 周波数に敏感である。ファイルサイズを変えたときの分散の変化は、最高周波数だけが効いている。
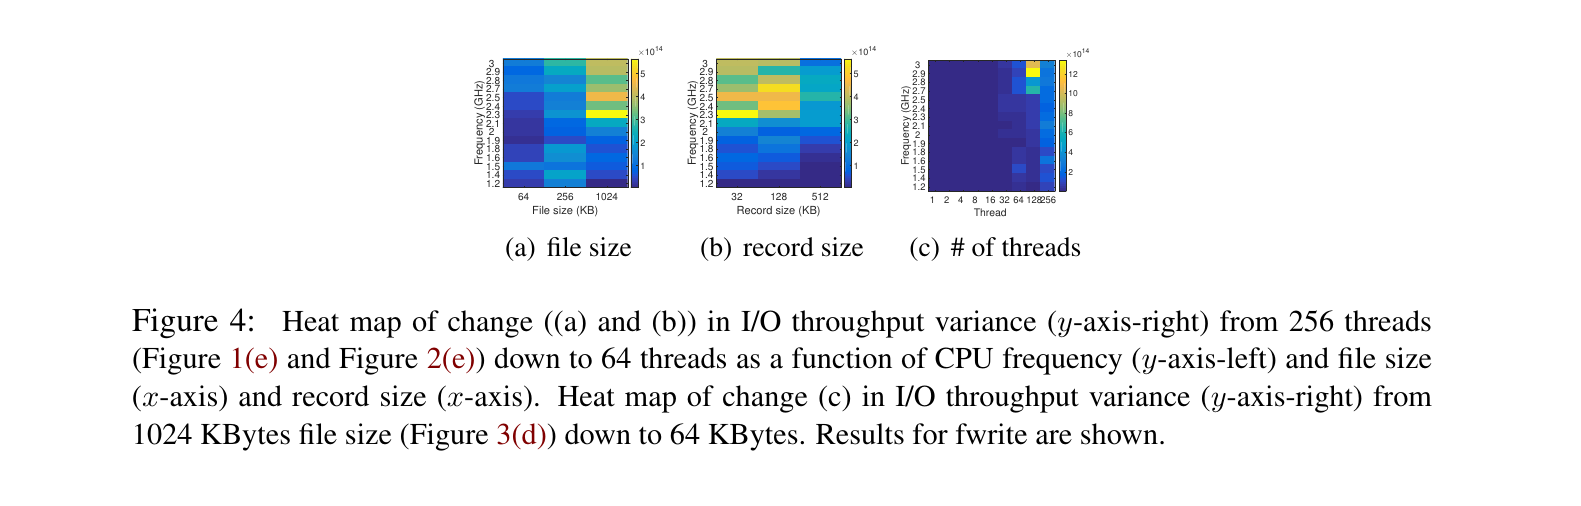
Figure 4: 分散の変化のヒートマップ。(a)(b) は 256 スレッドから 64 スレッドへ、(c) は 1024 KB から 64 KB へ変えたときの変化。fwrite の結果。
- 図 5 は、スレッドあたりのスループットがスレッド数でどう変わるかを示す。著者は、左右の列(1.2 GHz・64 KB と 3.0 GHz・1024 KB)の間に強い対比がある一方、変動に見て取れる規則は無いと書く。
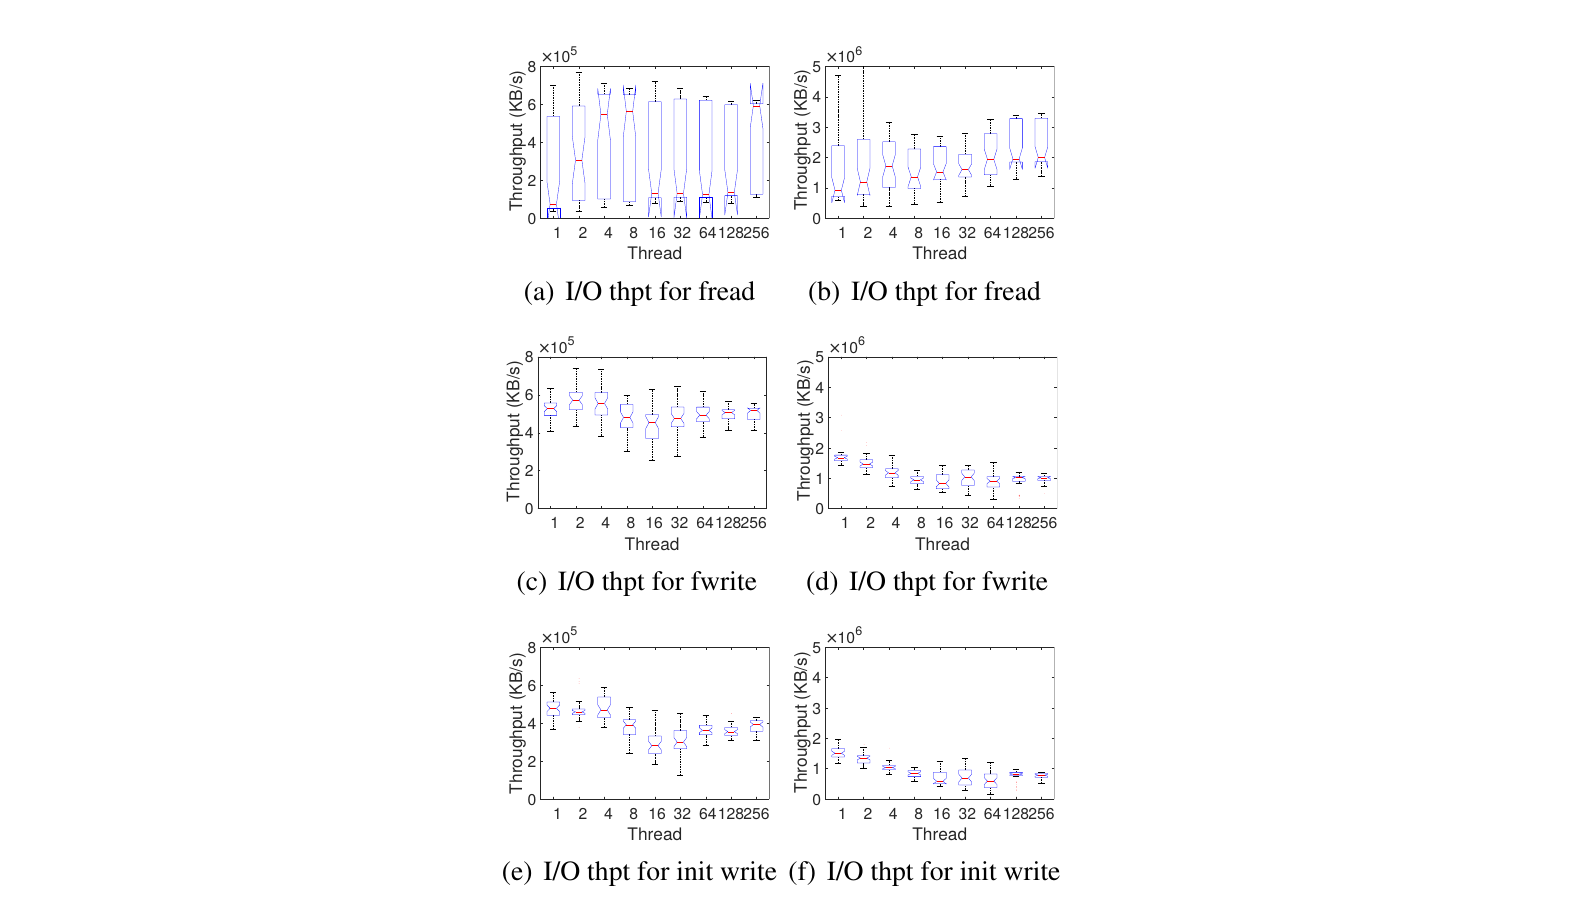
Figure 5: スレッド数に対するスレッドあたりの I/O スループット。左列は 1.2 GHz・ファイル 64 KB、右列は 3.0 GHz・ファイル 1024 KB。ホストスケジューラ CFQ、VM スケジューラ NOOP、レコード 32 KB。
著者は、観測できたのは 9.5 万構成のうち数百にすぎず、これらの傾向から一般的な結論は出せないと限界を書く。
提案手法 MOANA
線形解析の限界
- ANOVA で、ほぼ全パラメータと 2 次の交互作用が分散に有意に効くことは分かる。ただし各変数の寄与の大きさは分からない。
- 線形回帰(LR)は、分散の非線形な効果の予測で 300% 超の平均相対誤差(ARE)になる(表 2)。
variability map
- 構成
xを m 次元ベクトルとし、ブレの測度(標準偏差)を返す関数f(x)を variability map と呼ぶ。 - 実測から近似
f~(x)を作り、未測定の構成のブレを予測する。 x = (周波数, スレッド数, ファイルサイズ, レコードサイズ)で、1 マップあたり 15 × 9 × 6 = 810 構成。- スケジューラ 3 × VM スケジューラ 3 × 操作モード 13 = 117 通りの組ごとに、別のマップを作る。
3 つの予測手法
- LSP(modified linear Shepard): 各測定点まわりの局所線形近似を、距離に応じた重みで混ぜる。
- MARS(multivariate adaptive regression splines): 区分線形のスプラインの和で近似する。
- Delaunay 三角形分割: 区分線形の補間。
どれも高次元の非線形関係を近似できる手法として選ばれている。
評価指標
相対誤差は r = |f~ - f| / f で、f~ が予測した標準偏差、f が実測の標準偏差である。
ARE はその平均である。
ARE は標準偏差(ブレの大きさ)の予測誤差で、スループットの予測誤差ではない。
結果
学習割合を変えたランダム分割(表 2)
810 構成のうち割合 p を学習に使い、残りを予測する。117 マップの平均で、200 回繰り返す。
| 学習割合 p | LR | LSP | MARS | Delaunay |
|---|---|---|---|---|
| 0.9 | 323.09% | 11.13% | 56.61% | 9.97% |
| 0.5 | 324.59% | 12.22% | 62.35% | 11.42% |
| 0.2 | 329.56% | 19.33% | 79.27% | 16.13% |
| 0.1 | 339.32% | 30.44% | 100.14% | 23.39% |
- 本文は「非線形手法は線形回帰より桁違いに正確」と書く。表では LSP と Delaunay がこれに当たる。MARS は LR の約 1/6 である。
- LSP は学習 2 割で ARE 約 20% に収まる。少ない学習データでも教師あり学習が成立する、と著者は書く。
学習に無い 585 構成の予測(第 4 章)
周波数 2.5 GHz、128 スレッドに固定し、ファイルサイズ 512 KB と 768 KB の 5 組(表 3)で、学習データに無い構成を予測する。 5 × 3 × 3 × 13 = 585 構成である。
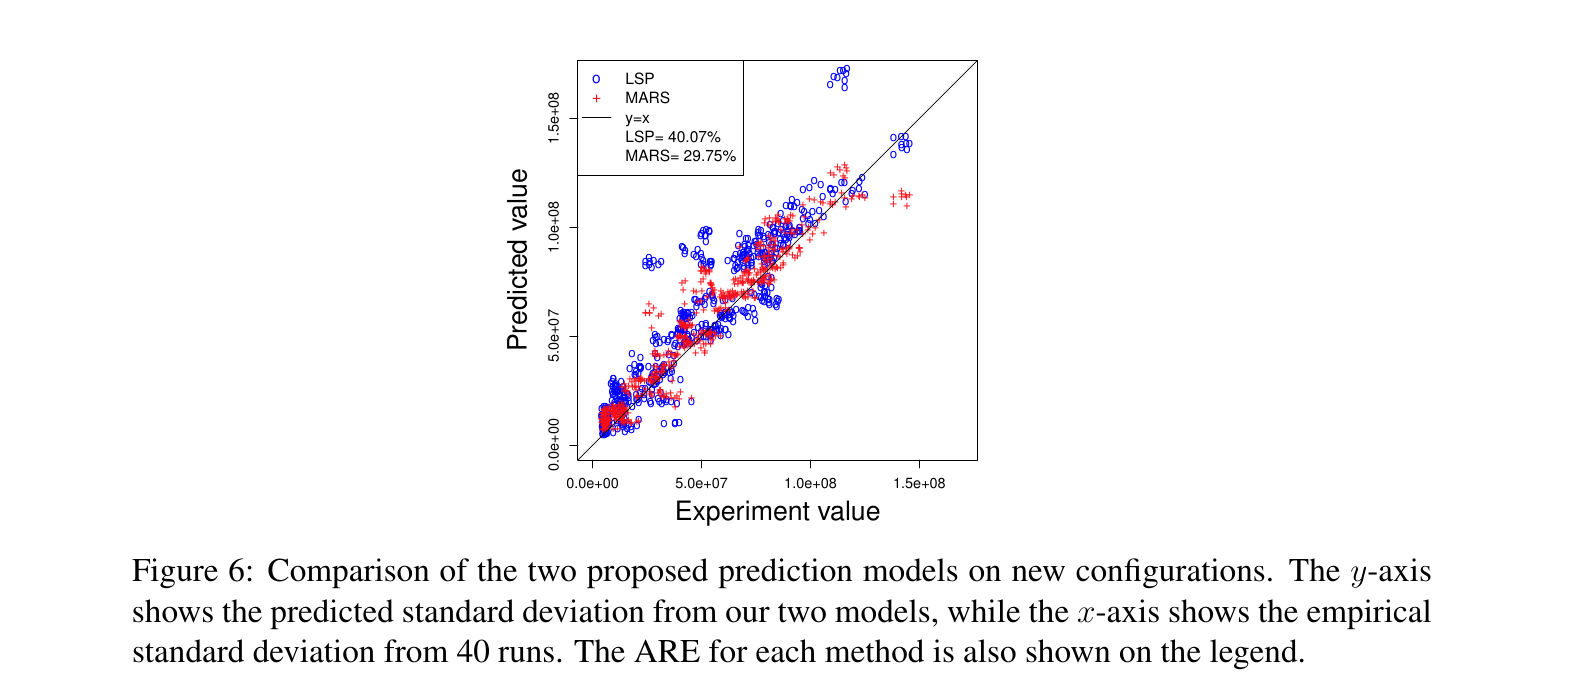
Figure 6: 新しい構成での 2 つの予測モデルの比較。縦軸が予測した標準偏差、横軸が 40 回から得た実測の標準偏差。凡例に ARE を表示。
- 全体では MARS の ARE が 29.75%、LSP が 40.07% で、第 3 章のランダム分割と順位が逆転する。著者は、MARS はファイルサイズとレコードサイズの学習点に敏感だと説明する。
- 操作モード別では、fread、fwrite、initial write の誤差が大きい(fwrite は LSP 107.75%、MARS 95.29%、initial write は LSP 84.71%、MARS 79.76%)。
- 著者は、書き込み系の誤差の原因を今後の課題とする。推測として、ページキャッシュ操作によるコミットのフラッシュがモデルに入っていないこと、ホストと VM の入れ子のファイルシステムの相互作用を挙げる。
- 10 種の操作モード(13 のうち)では、ブレの大きさの順位づけがおおむね当たる。
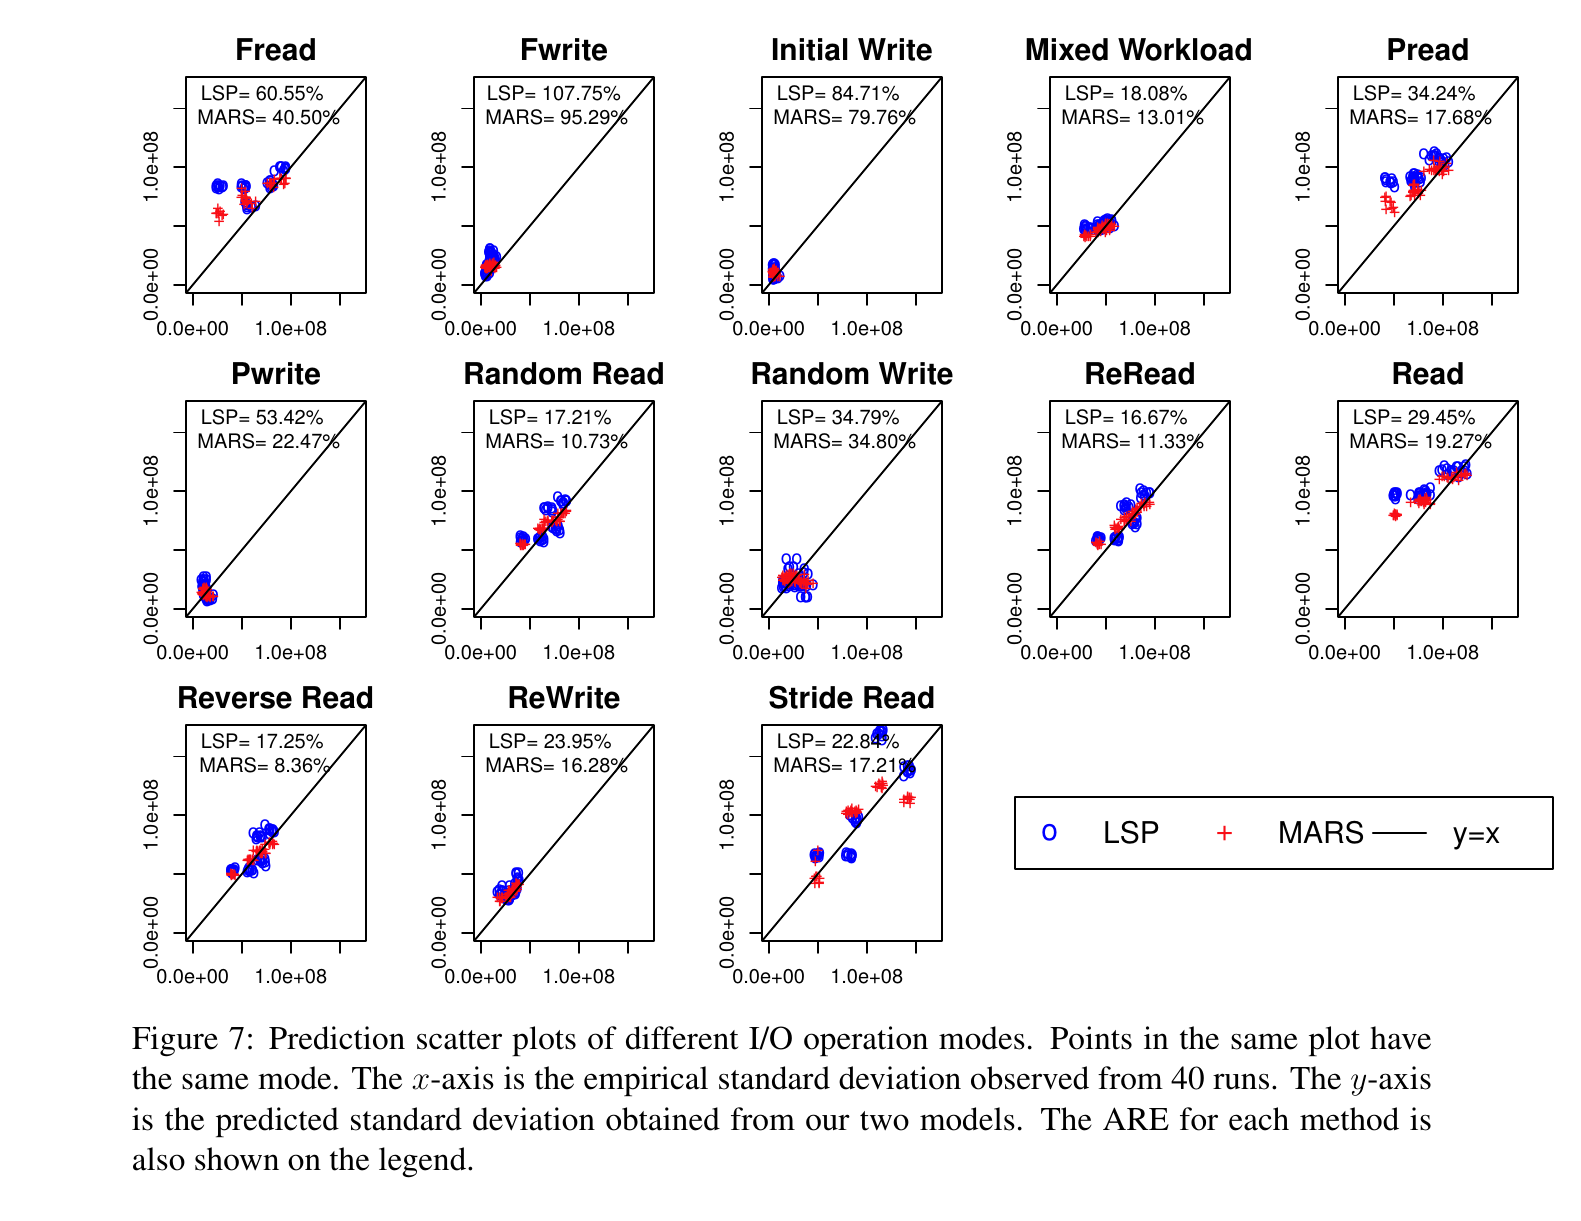
Figure 7: 操作モード別の予測散布図。同じ図の点は同じモード。横軸は 40 回の実測標準偏差、縦軸は 2 モデルの予測標準偏差。
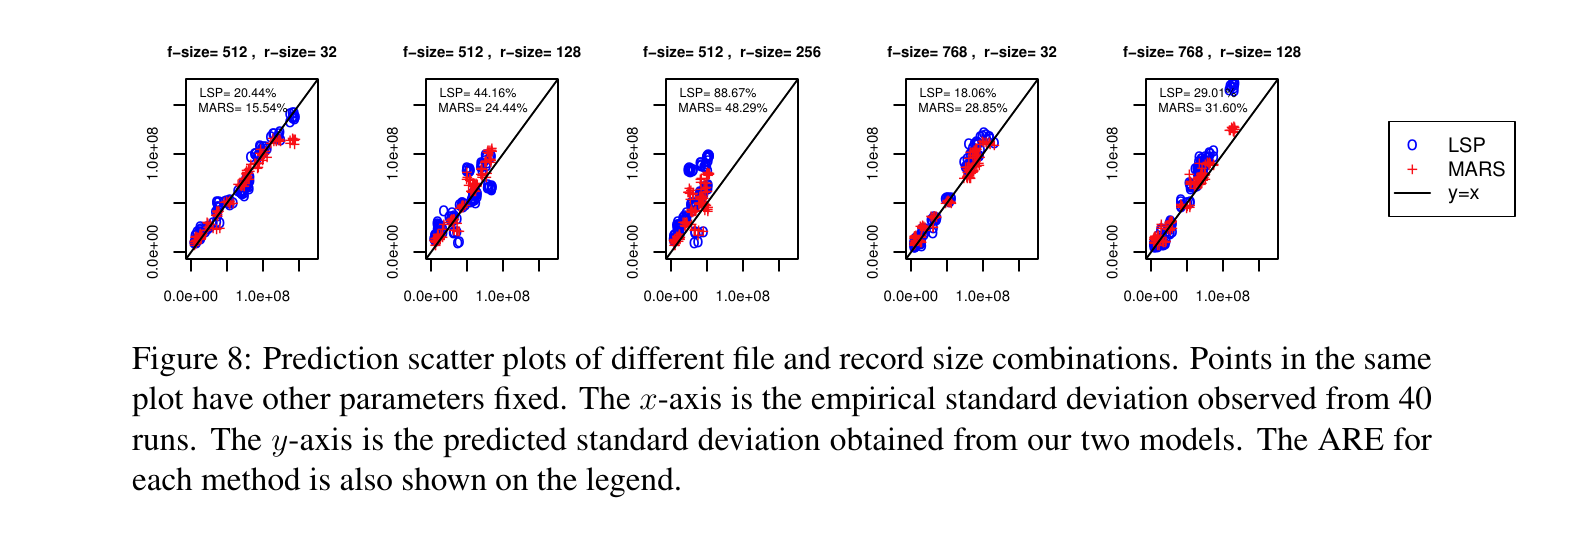
Figure 8: ファイルサイズとレコードサイズの組み合わせ別の予測散布図。横軸は実測標準偏差、縦軸は予測標準偏差。
繰り返し回数と信頼区間(第 6 章)
- 標準偏差ではなく 90% 信頼区間の予測に Delaunay を使うと、学習 9 割で ARE は 4% である。
- 図 9 は、測定回数を 10 から 40 まで増やしたときの信頼区間の収束を示す。測定した構成の例で、24 回で最大値(40 回)への収束の 75%、31 回で 90% に達する。
- 1 回の測定が 10 秒なら、7 回追加(70 秒)で 75% から 90% の収束になる、と著者は例示する。
- 未測定の構成でも、予測から同様の収束曲線を描ける。例では、実測の収束点との差は 3% 未満とある。
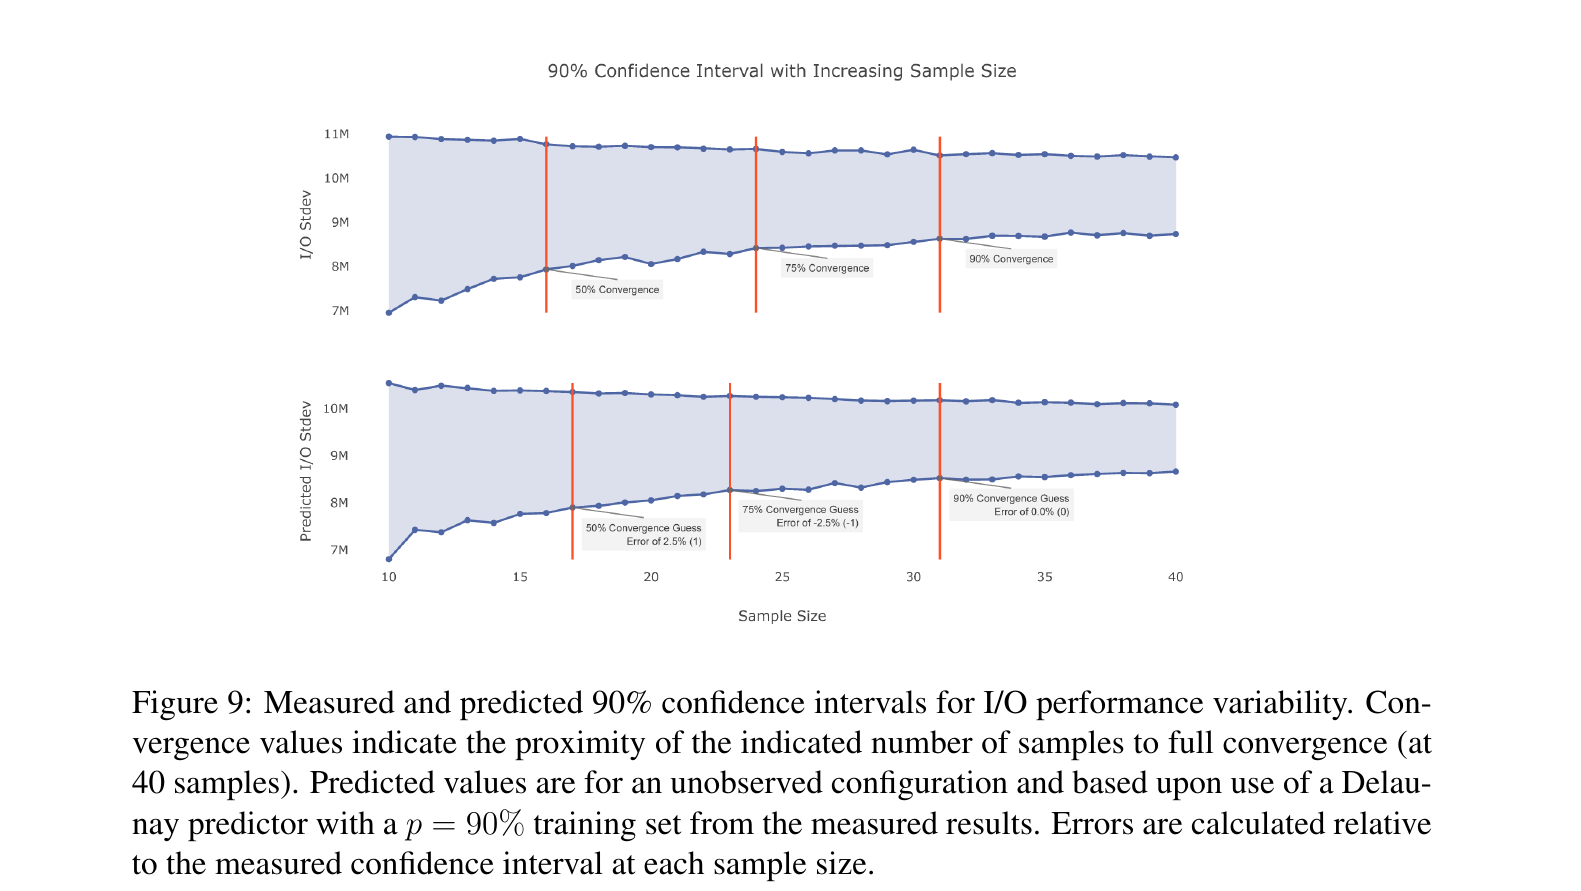
Figure 9: 測定した構成(上)と予測した構成(下)の 90% 信頼区間が、サンプル数とともに狭まる様子。縦線は 50%・75%・90% 収束の位置。予測は Delaunay、p = 90%。
この図は 1 構成の例であり、収束の割合は 40 回測った値を基準とした相対値である。
限界
- 対象は 1 台の共有メモリ計算機の HDD のローカル I/O。ネットワークと NFS は含まない(著者は相互接続の効果を意図的に除外したと書く)。
- ファイルサイズは 64〜1024 KB の 3 水準(予測検証は 512 KB と 768 KB を含む)。
- ブレの指標は標準偏差で、正規性を仮定する。
- モデルは構成に対するブレの大きさを予測するもので、帯域の平均値や、時間(時刻・日)をまたぐ変動は扱わない。
- 書き込み系の予測誤差が大きい(fwrite でほぼ 100%)。
- 論文に再現用 URL はなく、本文中は査読待ちで伏せられている。
関連研究との関係
- 関連研究として、ベンチマークの再現性(Hoefler らのベストプラクティス)、OS ジッタ、アーキテクチャのブレ、性能予測を挙げる。
- 著者は、ブレまで含めた予測モデルの研究は「ほぼ存在しない」と書く。
- 本リポジトリの他ノートとの関係は 性能分析マップ を参照。
Q&A
自分のコメント
- 測定は、ローカル HDD で、ファイルが 1 MB 以下の範囲に限られる。ElasticKernel-GPU の NFS 書き込み(1 MB 以上、nconnect=8)に数値は使えない。
- 「書き込みはサイズに対し増えてから減る」という形は、キャッシュ吸収で説明されている。NFS ではクライアント側ページキャッシュとサーバ側の双方が絡む。この論文の説明をそのまま当てはめるのは避ける。
- 当プロジェクトの測定(1 MB で 32.9、10 MB で 124.4、100 MB 以上で約 234 MiB/s)は、サイズとともに増えて頭打ちになる形で、MOANA の「増えて減る」とは別の領域を見ている。
- 本論文が扱うのは「ブレの予測」と「必要な繰り返し回数」で、帯域の曲線そのものではない。事前測定か実行時測定かの判断材料としては、後者の「繰り返し回数と信頼区間」の考え方が参考になる程度。