AI解説
同著者らによる姉妹論文: “C3: A System for Automating Application-Level Checkpointing of MPI Programs,” LCPC 2003(本ノートでは未読。本論文中でツール名は CCIFT、姉妹論文では C3 と呼ばれる。以後このノートでも通称 C3 を使う)。 情報源: PPoPP 2003 論文本文(著者自己アーカイブ版 PDF、全13頁)を精読して記述。本文に書かれていない事項は書いていない。
一言で
MPI プログラムをコンパイラ(precompiler)で自動的に耐障害版へ変換し、アプリケーション自身に自分の状態を保存・復元させる「アプリケーションレベルの協調的・非ブロッキングチェックポイント」を実現するシステム。既存の非ブロッキング協調プロトコル(Chandy-Lamport など)はシステムレベルのチェックポイント向けに設計されており、アプリケーションレベルでは使えないと論じ、新しいプロトコルを提案する。ベンチマークでのオーバーヘッドは小さいものは2.1%、大きいものはデータサイズ次第で数十〜百数十%まで変動する。
背景・問題
ハードウェアとソフトウェアの複雑化により、多くの科学技術計算アプリケーションの実行時間は、HPC 基盤の平均故障間隔(MTBF)を上回るようになった。論文が書かれた当時、Blue Gene/L のようなマシンは13万プロセッサ超に達しつつあり、逸話的には数時間に1プロセッサを失うと言われていた。したがって計算科学プログラムはハードウェア故障に耐える必要がある。
論文は「停止故障モデル」(プロセスがハングして応答しなくなる)を対象に、アプリケーションレベルの協調的・非ブロッキングチェックポイントが最良のアプローチだと主張する。しかし、この方式を実現しようとすると次の困難にぶつかる。
- 分散システム分野で確立された非ブロッキング協調プロトコル(Chandy-Lamport の分散スナップショットが代表例)は、システムレベルのチェックポインタ向けに設計されている。
- システムレベルのチェックポイントはプログラム実行中の任意の時点で取れるため、これらのプロトコルは「チェックポイントのタイミングを自由に選べる」という前提に依存している。
- アプリケーションレベルのチェックポイントは、プログラマが挿入した
PotentialCheckpoint呼び出しの位置でしか取れない。この制約が既存プロトコルを不適合にする、というのが論文の核心的な問題設定である。
提案手法
システム構成 — precompiler と protocol layer
CCIFT(Cornell Compiler for Inserting Fault-Tolerance)は、ほぼ無改造の単一スレッド C/MPI ソースを読み込み、アプリケーションレベルの状態保存を行うよう計装する。プログラマが追加で必要な作業は、チェックポイントを取ってよい位置に PotentialCheckpoint() 呼び出しを挿入することだけである。計装済みコードはネイティブコンパイラでコンパイルされ、protocol layer というライブラリとリンクされる。protocol layer はアプリケーションと MPI ライブラリの間に位置し、計装されたアプリケーションから MPI への呼び出しをすべて横取りする。
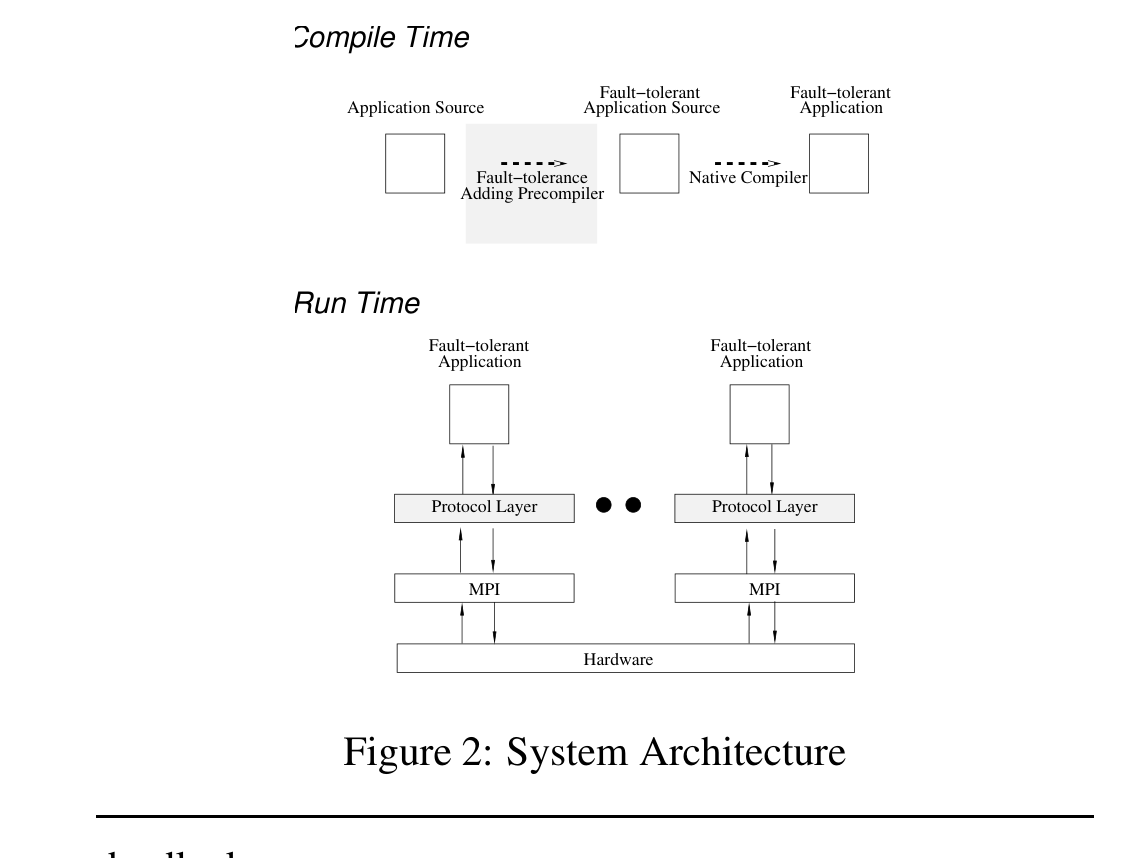
Figure 2: System Architecture。上段がコンパイル時(Fault-tolerance Adding Precompiler)、下段が実行時(Protocol Layer が MPI との間に入る)の構成。
この設計により、協調プロトコルの実装が特定の MPI 実装から独立する。論文自身が、この分離のおかげで「MPI ライブラリのコード(プロプライエタリな場合もある)へのアクセスが不要になり、ある MPI 実装から別の実装への移行も容易になる」というモジュール性の利点を強調している。
エポックと3種類のメッセージ
プロセスの実行は、ローカルチェックポイントとローカルチェックポインの間の期間であるエポックの列に分割される(実行開始が第0エポック)。エポック番号を使い、アプリケーションメッセージを送受信双方のエポック番号 e_A(送信時のAのエポック)と e_B(受信時のBのエポック)で3種類に分類する。
- Intra-epoch message:
e_A = e_B(同じエポック内で送受信)。 - Late message:
e_A < e_B(送信側がチェックポイントを取る前に送られ、受信側がチェックポイントを取った後に届く)。文献では in-flight message とも呼ばれる。 - Early message:
e_A > e_B(送信側が先にチェックポイントを取った後に送られたが、受信側はまだチェックポイントを取っていない時点で受け取ってしまう)。文献では inconsistent message とも呼ばれるが、論文は「復旧線をまたぐメッセージが『未送信なのに受信済み』という、実際には起こり得ない状態を指す名前」であり、アプリケーションレベルでは「特定の地点でしかチェックポイントを取れない」という制約のせいで頻繁に起こる自然な状況だとして、この呼称は誤解を招くと指摘し、early message と呼び直している。
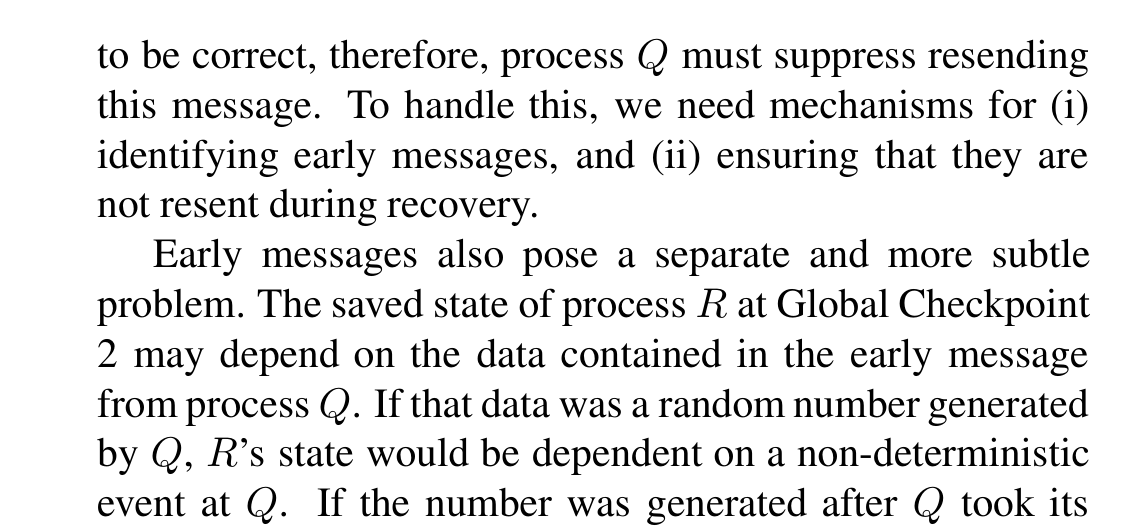
Figure 3: Epochs and message classification。3本の時間軸の上に、エポック境界(点線)をまたぐ Late・Early メッセージと、またがない Intra-epoch メッセージが示されている。
Late メッセージは既存のシステムレベルのプロトコルも扱う必要があるが、Early メッセージはアプリケーションレベル特有の問題である。Chandy-Lamport のようなシステムレベルのプロトコルは、チェックポイントのタイミングを自由に選べることを利用して Early メッセージが発生しないようスケジューリングできるが、アプリケーションレベルではプロセスが PotentialCheckpoint に到達する前に Early メッセージを受け取ってしまう可能性があり、これを避けられない。
4フェーズの協調プロトコル
新しいプロトコルは、initiator(開始プロセス)が主導する4フェーズで進む。
- Phase #1:initiator が全プロセスへ
pleaseCheckpoint制御メッセージを送る。各プロセスはこれを受け取った後、自由なタイミングでローカルチェックポイントを取ってよい。 - Phase #2:プロセスが
PotentialCheckpointに到達すると、ローカル状態を保存し、以後受け取る Late メッセージと非決定的な決定の結果をログし始める。自分宛の Late メッセージをすべて受け取り終えるとreadyToStopLoggingを initiator へ送るが、非決定的な決定のログは続ける。 - Phase #3:initiator が全プロセスから
readyToStopLoggingを受け取ると、すべてのプロセスが新しいエポックへ遷移したことを意味するので、stopLogging制御メッセージを全プロセスへブロードキャストする。 - Phase #4:各プロセスは
stopLoggingを受け取るか、または既にロギングを止めたプロセスからメッセージを受け取ったときにロギングを止める。後者の条件は、まだロギング中の別プロセスの状態が、保存されていないイベント(すでにロギングを止めたプロセスでの非決定的な決定)に因果的に依存してしまうのを防ぐために必要になる。ロギングを止めるとstoppedLoggingを initiator に送り、initiator が全プロセスからこれを受け取るとチェックポイントが確定する。
各アプリケーションメッセージには <epoch, amLogging, nextMessageID> が便乗(ピギーバック)され、受信側はこれを見てメッセージの種類(Late/Intra-epoch/Early)と送信側がまだロギング中かどうかを判定する。エポックを赤・緑に交互に色分けする最適化を使うと、ピギーバックすべき情報はエポック番号1個ではなく1ビットの色情報にまで圧縮できるという。
集団通信の扱い:MPI_Allreduce のような集団通信は、各プロセスが amLogging ビットを便乗させ、呼び出し自体でその論理積を計算させることで、点対点通信と同じ考え方を再利用できる。唯一特別な扱いが要るのが MPI_Barrier で、素朴にはリカバリ時にバリアが無意味な no-op になってしまう。正しい解決策は、バリアに参加する全プロセスがバリア直前に全対全通信を行い、エポック番号が揃っていなければ揃っていないプロセスにその場でローカルチェックポイントを取らせることで、バリアが必ず同じエポック内で実行されるようにする、というものである。
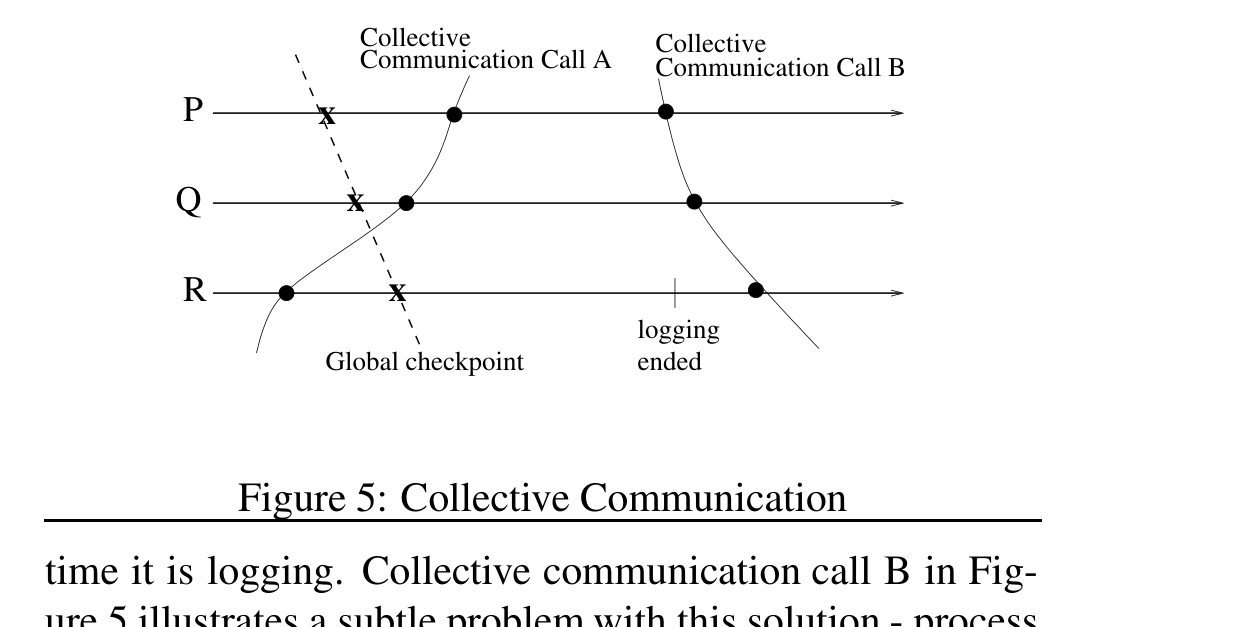
Figure 5: Collective Communication。プロセスP・Q・Rが2回の集団通信(Call A、Call B)をまたいでチェックポイントとロギング終了を行う様子。
状態の保存 — スタック・ヒープを元のアドレスへ復元する
アプリケーションの状態は、静的なプログラム上の位置、動的な実行位置、局所・大域変数、ヒープ上の構造からなる。
- Position Stack (PS):
PotentialCheckpointと関数呼び出しの位置にラベルを挿入し、実行トレースを記録するスタック。チェックポイント時に PS も保存され、再開時には各関数が PS に記録された自分のラベルへジャンプすることで、呼び出しスタックを再構築し、PotentialCheckpointの直後から実行を再開できる。 - Variable Descriptor Stack (VDS):スタック変数のアドレスとサイズを記録するスタックで、変数がスコープに出入りするたびにプリコンパイラが挿入したコードが操作する。チェックポイント時は VDS の各レコードが指すバイト列をチェックポイントファイルへコピーし、復元時は PS でスタックを再構築した後、VDS を使って値を書き戻す。
- Heap Object Structure (HOS):VDS のヒープ版で、生存しているヒープオブジェクトの開始アドレスと長さを保持する。独自のヒープ管理システムを実装し、復元時には同じ仮想アドレス空間のチャンクを要求し直してからオブジェクトを書き戻す。
この設計の要点は、スタック変数もヒープオブジェクトも、復元後に元の実行と全く同じ仮想アドレスに置かれることである。したがって、ポインタは特別な変換なしに「普通のデータ」として保存でき、元のプロセスで有効なデータポインタは、復元されたプロセスでも同じオブジェクトを指す。論文はこれを、可搬性を優先して「再配置可能」なポインタ表現を使う PORCH というシステムと対比し、PORCH はプログラマに C のサブセットでの記述を強い、変換のたびに性能コストを払わせるが、可搬性を目標にしない自分たちはその制約を避けたと説明している。
MPI の不透明オブジェクト(MPI_Request など)は protocol layer が「疑似ハンドル」を介して間接化する。MPI_Request のような一時的なオブジェクトは、チェックポイントをまたいで正しく振る舞うよう疑似ハンドルを個別に再初期化し、それ以外の永続的なオブジェクトは、それを生成・操作した全呼び出しの記録をチェックポイントと一緒に保存しておき、復元時にその呼び出し列を再生することで実質的に同じオブジェクト群を再構築する。
実験・結果
評価は Cornell Velocity スーパーコンピュータの CMI クラスタ(実験時点ではハードウェアの都合で64ノード中16ノードのみ使用、Windows 2000、MPI/Pro 1.6.4)で、3つのベンチマークについて、無改造版・ピギーバック追加版・ログ+MPI状態保存版・全部入り版の4パターンの実行時間を比較する形で行われた。チェックポイント間隔は全実験で30秒。
- 密な共役勾配法(Dense CG):4096×4096 または 8192×8192 行列で完全なチェックポイントのオーバーヘッドは14%。16384×16384まで大きくすると43%まで急増するが、状態保存以外の部分だけのオーバーヘッドは4.5%にとどまるため、増加の原因はアプリケーション状態のサイズそのものだと分析している。
- Laplace ソルバ:最悪ケースでもチェックポイント追加によるオーバーヘッドは2.1%。最大のデータセットでもアプリケーション状態はわずか2.1MBで、CG が遅くなり始める量よりずっと小さいことに加え、メッセージ1つあたりのデータ量がピギーバック情報よりずっと大きいため、ピギーバックの追加コストがほとんど効かないと説明されている。
- Neurosys(神経シミュレータ):アプリケーション状態は18KB〜1.24MBと小さく状態保存自体のオーバーヘッドは小さいが、ピギーバックのための制御メッセージ(
MPI_Allgather5回のそれぞれに1回ずつ)が余分な通信を生み、16×16では160%ものオーバーヘッドを引き起こす。ただし入力サイズが大きくなるにつれ計算・通信量が増えてもメッセージ数自体は変わらないため、この相対的コストは32×32で85%、64×64で34%、128×128では2.7%まで下がる。
関連研究との関係(メモ)
- Chandy-Lamport の分散スナップショット:論文が「最もよく知られた非ブロッキングプロトコル」として名指しし、システムレベルのチェックポインタ向けに設計されているためアプリケーションレベルにはそのまま使えないと主張する、対比の基準点。アプリケーションレベルのチェックポイント の §3.3(Flink の Asynchronous Barrier Snapshotting も同じ Chandy-Lamport を出発点にする)と読み比べると、同じ古典的プロトコルを異なる制約(MPI プログラムの停止故障 vs 止められない dataflow)の下で作り直しているという対応が見える。
- PORCH:可搬性のため再配置可能なポインタ表現を使う既存システム。C3 が「同じ仮想アドレスへの復元」で単純化した設計判断との対比として、論文自身が明示的に言及する。
- AutoCheck(
arXiv:2408.06082予定 cite key):C3 が人手でPotentialCheckpointを挿入する前提なのに対し、AutoCheck はデータ依存グラフから保存すべき変数を自動特定する、という関係。詳細は overview の §5(橋)を参照。
Q&A
(自分がAIに実際に質問したことだけをQ/A形式で残す。まだなし。)
自分のコメント
(ここは自分で都度書く欄。)