AI解説
実装: FTI (Fault Tolerance Interface)、https://github.com/leobago/fti 情報源: SC11 論文本文(著者自己アーカイブ版 PDF、全12頁)を精読して記述。本文に書かれていない事項は書いていない。
一言で
HPC の MPI アプリケーション向けに、トポロジを意識した Reed-Solomon(RS)符号化とノードごとの専用スレッドによる符号化の隠蔽を組み合わせた、低オーバーヘッド・高頻度の多階層チェックポイントライブラリ。SPECFEM3D による地震シミュレーションを TSUBAME2.0 の 1152 GPU 上で走らせても、6 分間隔の高頻度チェックポイントでオーバーヘッドは約 8% に収まる。
背景・問題
ペタスケール以降の HPC システムでは、大規模アプリケーションが数万プロセスでチェックポイントを取ると、1 プロセスあたり数 GB、合計で数十 TB のデータをリモートの並列ファイルシステム(PFS)へ書き出すことになる。I/O 帯域は計算性能ほど伸びていないため、これが I/O ボトルネックを生み、現行のペタスケールシステムで最大 25% のオーバーヘッドを引き起こしていると論文は指摘する。ポスト・ペタスケール以降はコンポーネント数がさらに増え、MTBF(平均故障間隔)が短くなる一方、チェックポイントすべきデータ量はますます大きくなる。
論文は障害の性質そのものにも触れる。半導体の微細化に伴いソフトエラー率(SER)が上がると予想され、ノード単位の物理的な要因(電源を共有する2ノードが同時に落ちる、ラック上部の冷却不良で複数ノードが同時に過熱するなど)による相関故障も無視できなくなる。したがって、ポスト・ペタスケールの耐障害技術は、コストの異なる複数のスキームを組み合わせる必要がある、というのが論文の立場である。
提案手法
トポロジを意識した Reed-Solomon 符号化
チェックポイントの可用性を保証する方法として、パートナーノードへの複製と誤り訂正符号(erasure code)がある。XOR 符号化(N ノードで 1 ノード分のパリティを持つ)は複製よりストレージ効率がよいが、複製と同様にグループ内で 2 ノード同時故障には耐えられない。FTI はより信頼性の高い Reed-Solomon 符号を採用する。RS 符号は K 個のシンボルを K+M 個のシンボルに拡張し、そのうち任意の K 個があれば元のメッセージを復元できる最適な誤り訂正符号である。
FTI は K プロセスのグループを作り、各グループから M=K 個の符号化ファイルを生成する。このとき、グループ内の K プロセスを必ず物理的に別々のノードへ配置する(メモリの chipkill 技術に類似)。これにより、1 ノードが故障してもそのグループが失うのは自分のチェックポイントファイルと符号化ファイルの計2つのイレージャだけで済み、グループはなお M/2 台までのノード故障に耐えられる。さらにこのトポロジを意識した分割により、複数ノードが同時に故障しても、故障を複数のグループへ分散させられる。
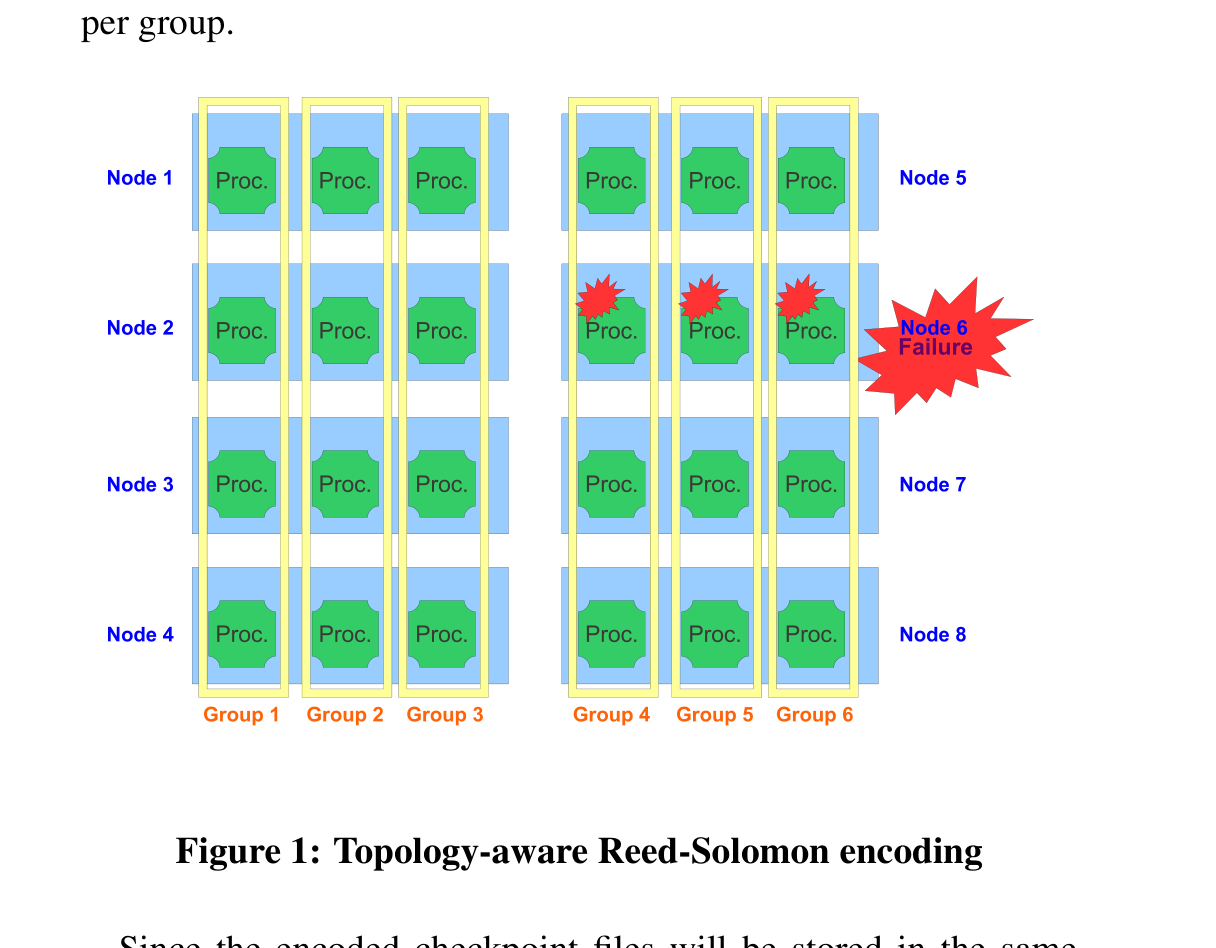
Figure 1: Topology-aware Reed-Solomon encoding。8ノードをグループ1〜6に分割し、Node 6 の故障がGroup 4〜6の一部だけに影響することを示す図。
FT 専用スレッドによる符号化の隠蔽
RS 符号化の欠点は計算コストの高さで、K プロセスのグループで M 個のファイルを符号化する時間は M に比例して増える。FTI はこれをアプリの計算と並行させて隠す。具体的には、各ノードに1つの FT 専用スレッドを立て、そのノードが担当するチェックポイントファイル群の符号化をシリアルに行わせる。各プロセスが自分のファイルを個別に符号化するより遅くなるが、その符号化はアプリの計算と並行に進むため、専用スレッド方式のほうがオーバーヘッドは小さくなる。ノードあたり CPU コアが約12個ある現在のシステムでは、1コアを専用スレッドに割くことによる純粋な性能損失は8.3%だが、コアあたりのスレッド数が増えるほどこの損失は小さくなる(論文はコアあたり4スレッドの Blue Waters を例に0.7%まで下がると試算している)。
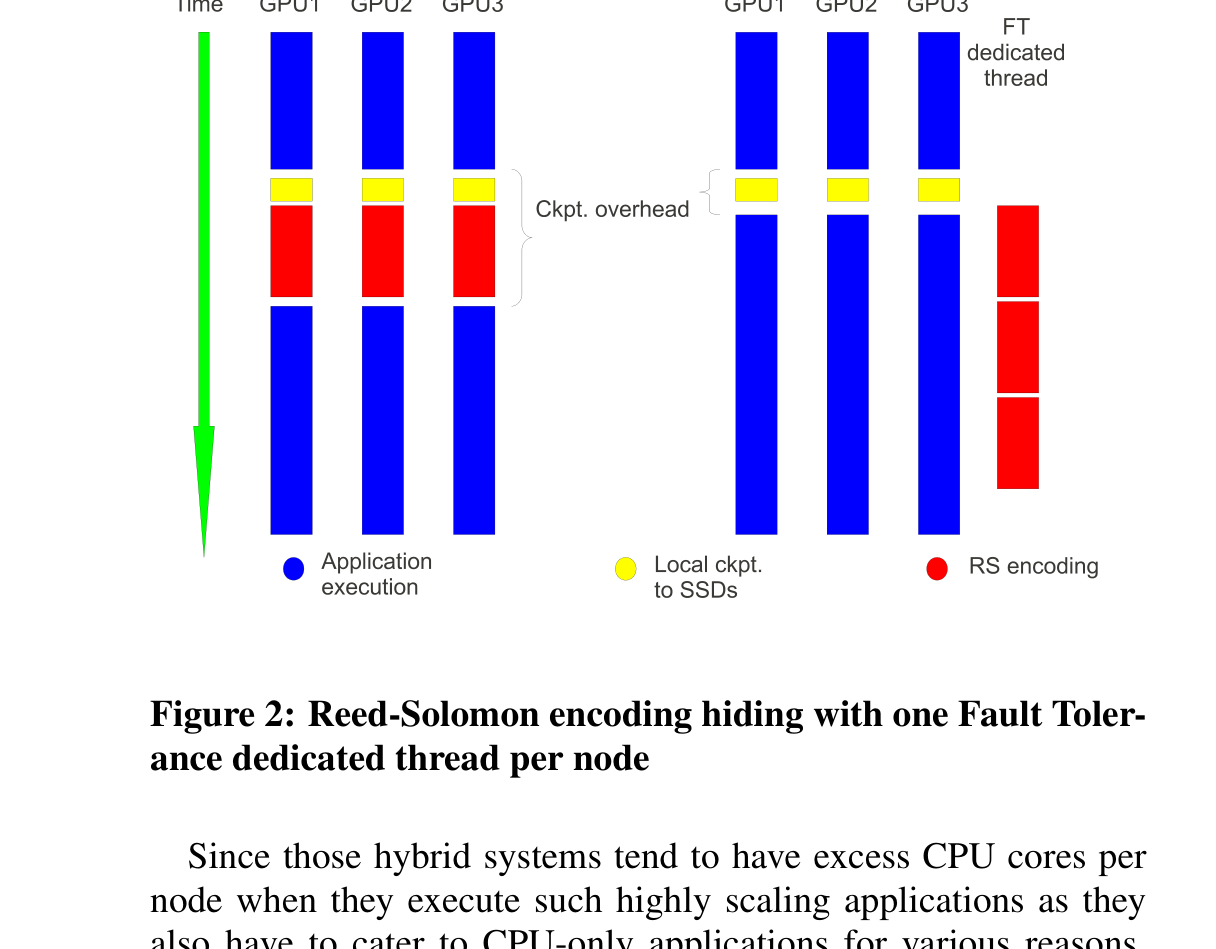
Figure 2: Reed-Solomon encoding hiding with one Fault Tolerance dedicated thread per node。左は各プロセスが自分で符号化する場合、右はFT専用スレッドに任せて計算と並行させる場合。
多階層チェックポイントへの統合
FTI は Moody ら(SCR、1)が提案した三階層チェックポイント(L1: ローカル SSD、L2: パートナーまたは XOR 符号化、L3: PFS)を土台に、L2 を上記のトポロジ考慮 RS 符号化へ置き換える。L1 はソフトエラーなど一過性の故障を毎回のチェックポイントで扱い、L2(RS符号化)は一つ以上のノード故障をより低頻度で扱い、L3 は稀な大規模故障に備える。L3 についても、ローカル SSD へ書いてから PFS へ並行して掃き出す(OpenMPI のステージング機能に類似)ことで、PFS 書き込みをアプリの実行と重ねる。
FTI は MPI アプリに対して、専用の FTI_COMM_WORLD コミュニケータを提供し、アプリのプロセスと FT マネージャプロセスの通信を分離する。障害から再開する際、利用者は設定ファイルの1パラメータを変えて再実行するだけでよく、FTI_Init() が直前のトポロジを再現し、失われたデータがあれば RS 復号を行い、それでも足りなければ PFS 上の最後のチェックポイントを探す。SPECFEM3D への組み込みは1時間未満、追加コードは数十行で済んだという。
数式・アルゴリズム
符号化時間のモデルは、チェックポイントファイルを z バイトの t 個のブロックに分け、各ブロックについて読み込み・m 回の通信(K プロセスのグループで m=K)・m 回の符号化計算・書き込みを行うとして、次式で与えられる。
T_RSenc. = t * ( r*z + m*(a + b*z + e*z) + w*z ) ... (1)
ここで a はネットワーク遅延、1/b は帯域、e は1バイトあたりの符号化時間、r/w は1バイトあたりの読み書き時間。ローカルストレージの読み書きは十分速く無視できるとして、式は次のように簡約される。
T_RSenc. = t * m * e * z ... (2)
つまり符号化時間は、チェックポイントサイズ(s=t*z)とグループサイズ(k=m)の両方に線形に比例する。復号はロスト分の再生成と、失われた符号化ファイルの再符号化という2段階を要するため、符号化のおよそ2倍かかるとされる。
信頼性のモデルでは、システムに x ノードの故障が起きたときにグループの許容故障数 t+1 を超える「破局的故障」が起きる確率 Pr(x_Ct. | x) を組合せ論で見積もる。
Pr(x_Ct. | x) = [ C(g,1) * C(k,t+1) * C(n-(t+1), x-(t+1)) ] / C(n,x) ... (4)
ここで n は総ノード数、k はグループサイズ、g はグループ数、t はグループあたりの許容故障数。これと、TSUBAME1 の4年分の実際の故障記録(1280件)から見積もった「x ノードが同時に故障する確率 Pr(x)」を掛け合わせることで、破局的故障の確率 Pr(x ∩ x_Ct.)(式3)を評価する。
実験・結果
評価環境は TSUBAME2.0(1408計算ノード、ノードあたり NVIDIA M2050 GPU 3基、Westmere-EP CPU 2基、ローカル SSD 60〜120GB×2、QDR InfiniBand デュアルレール)。
- 符号化のスケーラビリティ:ブロックサイズを自動チューニングする仕組みを持ち、2KB以上のブロックサイズで符号化時間が安定する(ネットワーク遅延が計算に完全に隠れる)ことを確認した。
- 信頼性の比較:1000ノード規模のシステムを想定し、SCR の XOR 符号化と FTI の RS 符号化を比較したところ、最小のグループサイズ(4ノード)でも FTI は SCR よりおよそ2桁(2 orders of magnitude)信頼性が高いことを示した。しかもグループサイズを大きくすると FTI の信頼性はさらに数桁向上するのに対し、XOR は逆にグループサイズが大きいほど同時多重故障に弱くなり信頼性が下がる。
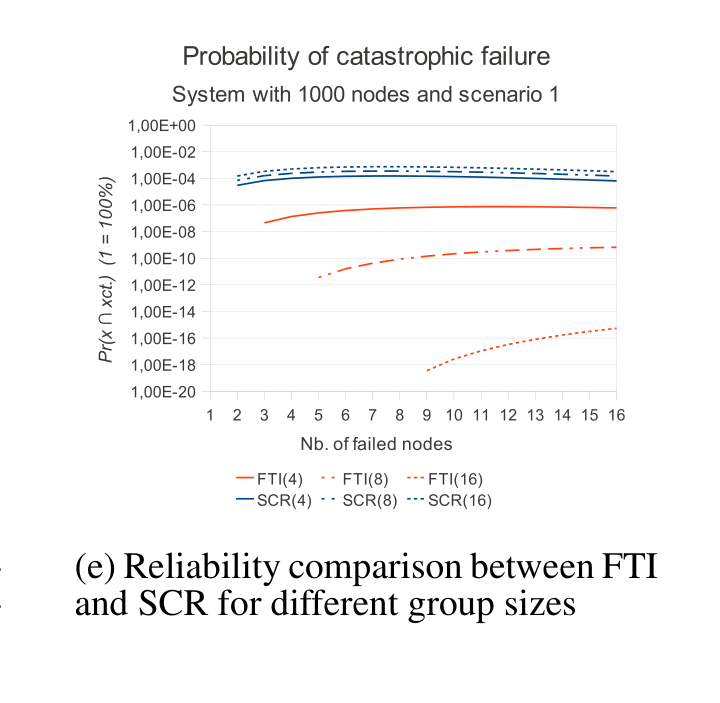
Figure 5(e): Reliability comparison between FTI and SCR for different group sizes。縦軸は対数スケールの破局的故障確率。
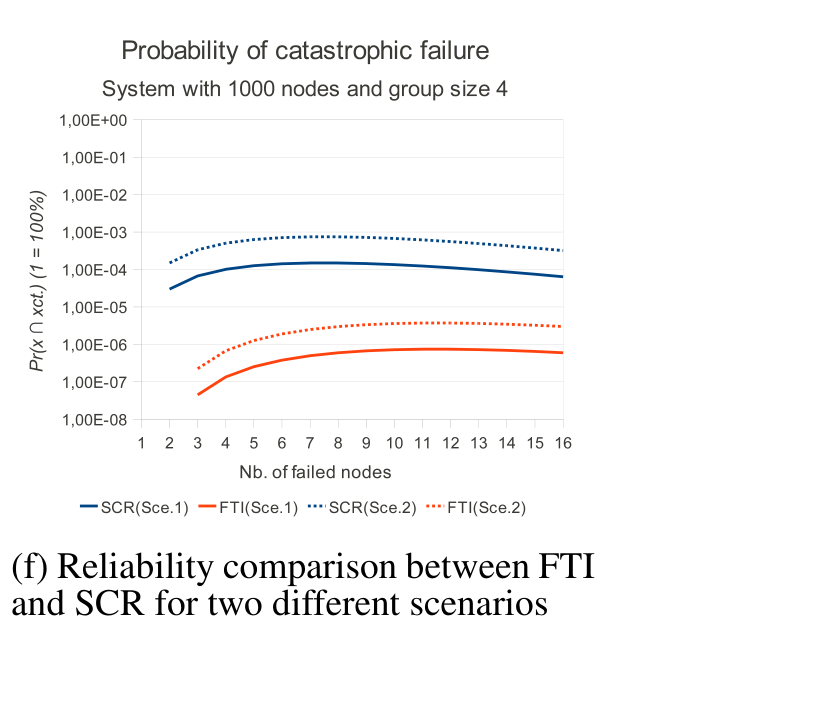
Figure 5(f): Reliability comparison between FTI and SCR for two different scenarios。相関故障の割合を変えた2シナリオでの比較。
- 実データケーススタディ:2011年東北地方太平洋沖地震(Mw9.0)を SPECFEM3D で再現するシミュレーションを実施し、福島県ひの野観測点での合成波形が、地表が恒久的に傾いたことを示す「静的オフセット」を含む観測と整合的な変位(東西成分で約2mの永久変位)を示した。
- 大規模オーバーヘッド評価:1152GPU(0.1ペタフロップス超)で、Young の最適チェックポイント間隔の式(MTBF 12時間、L1チェックポイント2秒と仮定)から導いた6分間隔で高頻度チェックポイントを行っても、チェックポイントなしの場合に対するオーバーヘッドは約8%にとどまった。比較対象のカーネルレベル手法 BLCR+Lustre は、GPU アクセラレータ搭載システムをチェックポイントできない(本評価ではその代替として同等量のデータを Lustre へ書き出す形でコストを模擬)うえ、プロセスの全メモリを保存するため FTI-L1,L2 よりも5倍大きいチェックポイントになり、オーバーヘッドが急増した。
関連研究との関係(メモ)
- SCR(Moody et al., cite key
moody2010scr予定):論文自身が「おそらく我々の研究に最も近い」と明言する先行研究で、三階層構成と確率的マルコフモデルの土台を提供した。FTI はその L2 を、より信頼性の高いトポロジ考慮 RS 符号化に置き換えるという関係にある。論文末尾では、逆に SCR 側が FTI の FT 専用スレッド方式を取り入れる余地や、XOR(SCR の L2)を FTI の L1-L2 間の中間層として組み合わせる将来構想にも触れている。 - PLFS:N-1 書き込みパターンを N-N に変換する並列ログ構造ファイルシステム。PFS 自体の性能を上げる技術であり、FTI とは補完関係にあるとされる。
- diskless checkpointing(Plank ら):PFS への書き込みを避ける系譜として言及されるが、符号化アルゴリズムの最適化や時間・メモリ効率が課題だったとされる。
- 詳細な分野横断の位置づけは アプリケーションレベルのチェックポイント の §3.1 を参照。
Q&A
(自分がAIに実際に質問したことだけをQ/A形式で残す。まだなし。)
自分のコメント
(ここは自分で都度書く欄。)
-
Adam Moody, Greg Bronevetsky, Kathryn Mohror, Bronis R. de Supinski, “Design, Modeling, and Evaluation of a Scalable Multi-level Checkpointing System,” SC10. ↩